Résumez cet article avec :
Inkling 2 Small, de Thinking Machines, obtient le score de Gemini 3.8 Flash pour une fraction du coût par tâche, mais consomme 4 fois plus de tokens que son prédécesseur. Ses points forts, son vrai coût et quand l'utiliser.
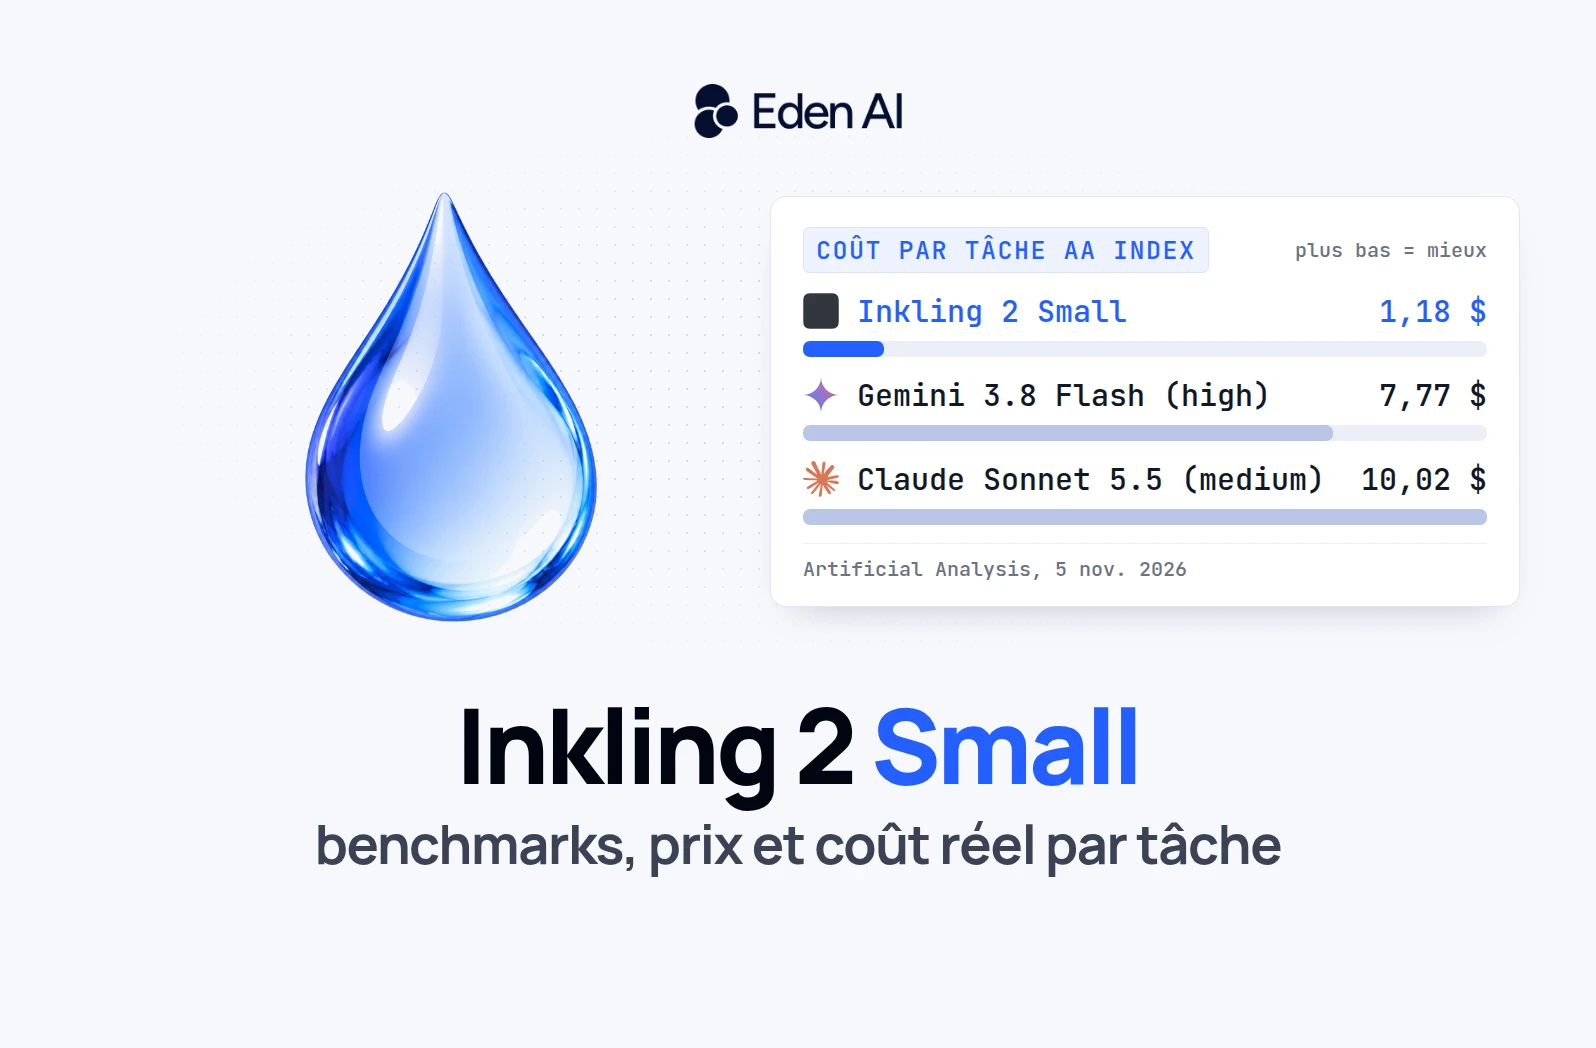
Réponse courte : environ 1,18 $ par tâche, selon Artificial Analysis. C'est à peu près six fois moins que Gemini 3.8 Flash pour le même score, et presque six fois plus que son petit frère Inkling Small, parce que le nouveau modèle aime réfléchir à voix haute : environ 150 000 tokens de sortie par tâche. Des tokens bon marché, un modèle bavard.
Inkling 2 Small est sorti le 5 novembre 2026 chez Thinking Machines Lab, la société fondée par Mira Murati, ancienne CTO d'OpenAI. C'est un modèle mixture-of-experts de 594 milliards de paramètres, dont 17 milliards actifs pour chaque token, qui lit le texte comme les images. Il obtient 31 à l'Intelligence Index d'Artificial Analysis, autant que Gemini 3.8 Flash (high), loin devant le premier Inkling Small. Le hic : il ne tourne pour l'instant que sur la plateforme de Thinking Machines, et ses poids ne sont pas encore publiés.
Ce guide présente ce que le modèle fait bien, ses limites, ce que coûte vraiment une tâche, et comment préparer votre stack pour pouvoir l'essayer en changeant une seule ligne de code.
Inkling 2 Small en bref
| Sortie | 5 novembre 2026, par Thinking Machines Lab |
| Architecture | Mixture-of-experts, 594 Md de paramètres au total, 17 Md actifs |
| Entrées et sortie | Texte et image en entrée, texte en sortie. Contexte jusqu'à 1M de tokens. Effort de raisonnement réglable |
| AA Intelligence Index | 31, soit 18 points de plus qu'Inkling Small, au niveau de Gemini 3.8 Flash (high) |
| Prix sur Tinker | 0,30 $ en entrée, 0,03 $ en entrée mise en cache, 1,00 $ en sortie, par million de tokens |
| Accès aujourd'hui | Uniquement sur Tinker : Playground, API d'inférence et fine-tuning |
| Poids | Licence Apache 2.0, annoncés pour la semaine suivant la sortie, après des tests de sécurité externes. Pas de date confirmée |
| Sur Eden AI | Pas encore. Inkling et Inkling Small sont disponibles dès maintenant |
Ce qui change par rapport à Inkling Small
Inkling 2 Small est un nouveau modèle entraîné de zéro, pas une mise à jour de la première génération. Thinking Machines met en avant quatre changements.
- Un « petit » modèle plus gros : Inkling Small comptait 12 milliards de paramètres actifs sur 276 milliards. Inkling 2 Small en a 17 milliards actifs, sur 594 milliards au total.
- Le travail agentique long : il a été entraîné par apprentissage par renforcement sur des centaines de milliers de longues tâches de code, notées sur la manière de travailler du modèle et pas seulement sur la réussite des tests. Sur l'AutomationBench d'Artificial Analysis, il passe de 5 % à 46 %.
- La vision dans la boucle : un encodeur visuel de 292 millions de paramètres lui permet de lire captures d'écran, graphiques et documents, et de vérifier son propre rendu visuel quand il construit un site web ou une scène 3D.
- Conçu pour le fine-tuning : sur une tâche d'analyse financière, il a atteint le score final d'Inkling Small en seulement 75 étapes d'entraînement, puis a continué de progresser.
L'entraînement lui-même a été économe pour l'époque. Le pré-entraînement a couvert environ 12 600 milliards de tokens en quatre phases, dont la première en 68 heures, et l'apprentissage par renforcement principal a duré 9 jours sur 2 048 GPU. Comme l'a souligné Stéphane Requena, CTO de GENCI, l'organisme français des supercalculateurs publics, c'est bien moins de calcul et de données que les modèles auxquels il se mesure.
Benchmarks : où il gagne, où il perd
Thinking Machines compare Inkling 2 Small aux meilleurs modèles open weights de taille comparable. Voici une sélection de son tableau.
| Catégorie | Benchmark | Inkling 2 Small | DeepSeek V4.1 Flash | Kimi K3 | GLM-5.3-Flash |
|---|---|---|---|---|---|
| Code | DeepSWE v1.1 | 72,1 % | 77,0 % | 68,5 % | 63,4 % |
| Code | Vibe Code Bench v1.1 | 81,6 % | 87,7 % | 85,0 % | 30,8 % |
| Vision | MMMU Pro | 81,6 % | 80,6 % | 80,5 % | 79,0 % |
| Vision | ScreenSpot Pro | 83,8 % | non publié | 73,8 % | non publié |
| Finance | Vals Finance Index | 61,5 % | 60,9 % | 58,0 % | 55,8 % |
| Droit | Vals Legal Index | 73,9 % | 71,9 % | 71,7 % | 71,1 % |
| Travail de bureau | AA-Briefcase v1.1 (Elo) | 1527 | 1570 | 1497 | 1451 |
| Raisonnement | HLE-Diamond | 28,7 % | non publié | 26,9 % | 18,2 % |
Trois points ressortent :
- La vision et les documents sont son point fort. Il mène sur MMMU Pro et ScreenSpot Pro, et devrait devenir le premier modèle open weights du classement « website » de DesignArena dès la sortie de ses poids.
- La finance et le droit viennent ensuite. C'est le meilleur modèle open weights du tableau sur les indices Vals Finance et Legal, qui testent le raisonnement sur des rapports financiers, des tableurs et des contrats.
- En code, il est bon sans être le meilleur. DeepSeek V4.1 Flash reste devant sur DeepSWE et Vibe Code Bench, et Kimi K3 sur SWE-Bench Pro. Artificial Analysis note aussi qu'Inkling 2 Small obtient 13 % sur Terminal-Bench 4.0, contre 30 % pour Claude Sonnet 5.5.
La plupart de ces chiffres viennent de Thinking Machines. Les résultats indépendants d'Artificial Analysis confirment le niveau général, avec une nuance : les hallucinations passent de 61 % à 27 % surtout parce que le modèle refuse plus souvent de répondre, alors que la précision ne progresse que de 32 % à 34 %.
Le prix au token n'est pas le coût par tâche
À 0,30 $ par million de tokens en entrée et 1,00 $ en sortie, Inkling 2 Small est l'un des modèles les moins chers à son niveau. Mais le prix au token ne dit que la moitié de l'histoire : ce que vous payez, c'est ce prix multiplié par le nombre de tokens que le modèle dépense pour finir le travail. Artificial Analysis mesure les deux.
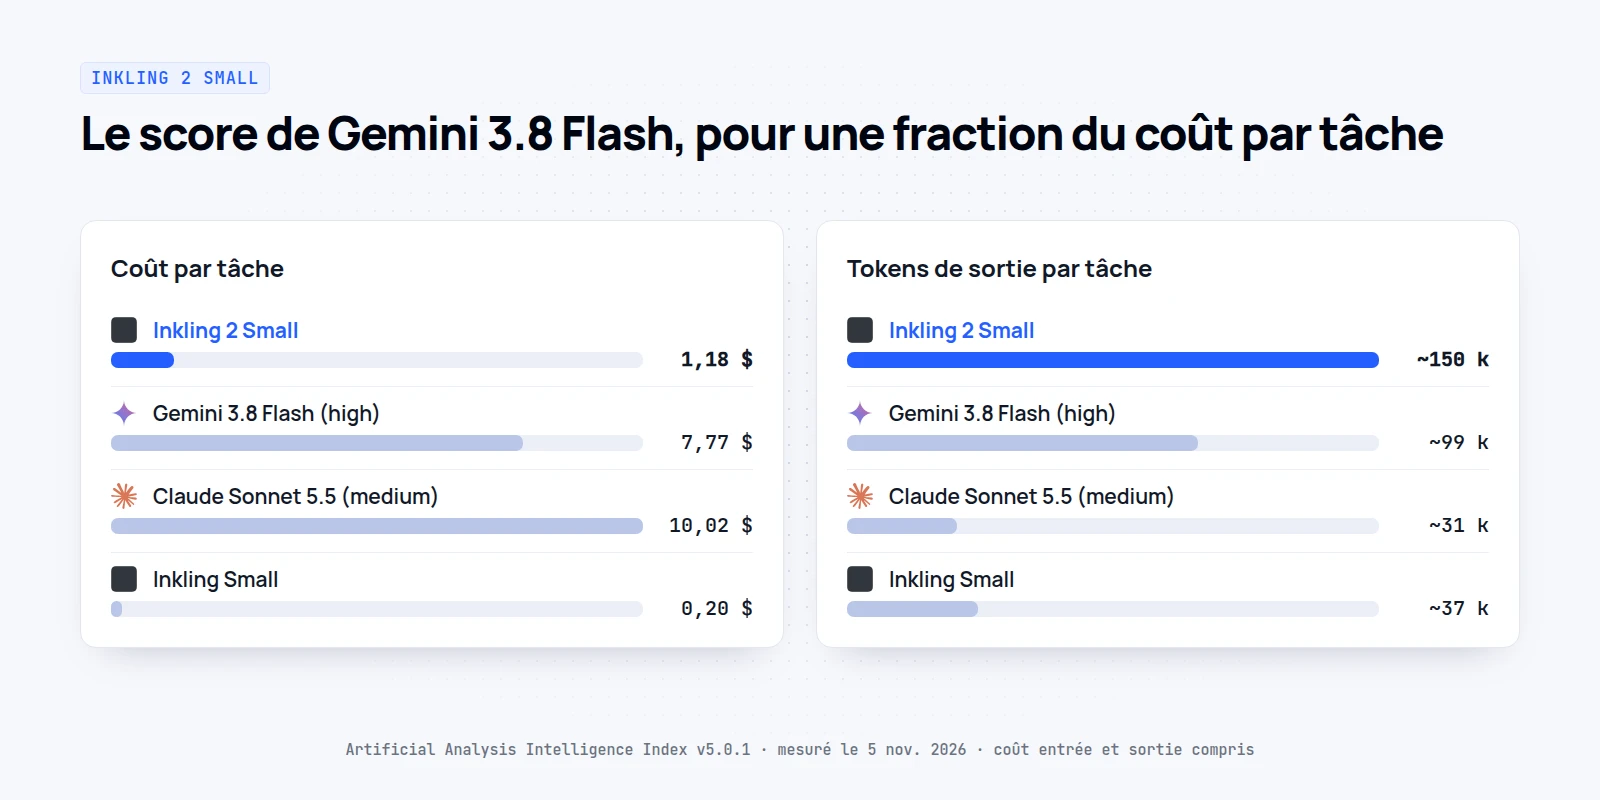
| Modèle | Prix par million de tokens (entrée / sortie) | Tokens de sortie par tâche | Coût par tâche |
|---|---|---|---|
| Inkling 2 Small | 0,30 $ / 1,00 $ (Tinker) | ~150 000 | 1,18 $ |
| Gemini 3.8 Flash (high) | 0,75 $ / 3,75 $ | ~99 000 | 7,77 $ |
| Claude Sonnet 5.5 (medium) | 2,00 $ / 10,00 $ | ~31 000 | 10,02 $ |
| Inkling Small | 0,45 $ / 1,20 $ (DeepInfra) | ~37 000 | 0,20 $ |
Ce tableau donne deux enseignements :
- Face aux modèles de même niveau, il est bien moins cher. Pour le même score à l'Intelligence Index, une tâche coûte environ 6,6 fois moins qu'avec Gemini 3.8 Flash (high), et 8,5 fois moins qu'avec Claude Sonnet 5.5 (medium), alors même qu'il écrit davantage.
- Face à son prédécesseur, il coûte presque 6 fois plus par tâche. Inkling 2 Small réfléchit plus longtemps : environ 150 000 tokens de sortie par tâche, quatre fois plus qu'Inkling Small. La réponse est bien meilleure, mais chaque token supplémentaire se paie.
En pratique, le coût d'un modèle dépend de vos tâches, pas de sa grille tarifaire. Une classification courte ne coûtera presque rien avec n'importe lequel de ces modèles, alors qu'un long travail d'agent peut multiplier la facture. Thinking Machines a entraîné Inkling 2 Small avec plusieurs niveaux d'effort et une pénalité de longueur : baisser l'effort sur les requêtes simples est donc le premier levier pour contenir sa consommation de tokens.
Fermé aujourd'hui, Apache 2.0 bientôt
Pour l'instant, Inkling 2 Small ne tourne que sur Tinker, la plateforme de Thinking Machines, où l'on peut l'essayer dans le Playground, l'appeler par API ou le fine-tuner. Thinking Machines suit ce qu'elle appelle un chemin sûr vers les open weights : elle a annoncé la publication des poids sous licence Apache 2.0 pour la semaine suivant la sortie, une fois les tests de sécurité et le red-teaming externes terminés. Artificial Analysis indique que la date n'est pas confirmée.
Une fois les poids publiés, trois choses changent :
- Plus d'endroits pour l'utiliser : les fournisseurs d'inférence pourront l'héberger, comme ils l'ont fait pour Inkling et Inkling Small, tous deux disponibles sur Eden AI aujourd'hui.
- L'auto-hébergement devient possible : avec 594 milliards de paramètres, le modèle complet demande un serveur multi-GPU, même si seuls 17 milliards sont actifs par token.
- Les versions fine-tunées deviennent portables : les modèles personnalisés sur Tinker pourront être téléchargés.
Artificial Analysis estime qu'il deviendra alors le modèle open weights le mieux noté parmi ceux développés hors de Chine.
Quel modèle pour quelle tâche
Inkling 2 Small n'est pas un choix par défaut pour tout. D'après les résultats publiés, voici où il a sa place.
- Documents, captures d'écran et graphiques : c'est son point fort, avec un encodeur visuel et les meilleurs scores MMMU Pro et ScreenSpot Pro de sa catégorie.
- Analyse financière et juridique : il mène les modèles open weights sur les indices Vals Finance et Legal, et il est conçu pour être fine-tuné sur vos propres données.
- Code agentique : DeepSeek V4.1 Flash et Kimi K3 restent plus forts sur la plupart des benchmarks de code, et DeepSeek V4.1 Flash coûte moins de 0,10 $ par million de tokens en entrée et 0,40 $ en sortie sur Eden AI.
- Requêtes courtes et volumineuses : un modèle plus petit suffit en général, et le routage prix-performance réserve les modèles chers aux requêtes qui en ont besoin.
Se préparer avec Eden AI
Inkling 2 Small n'est pas encore sur Eden AI, car il n'est servi que sur Tinker. Ses deux prédécesseurs, Inkling Small et Inkling, sont disponibles dès maintenant, avec les modèles DeepSeek, Kimi, Gemini, Claude et GPT, derrière une seule clé API et un endpoint compatible OpenAI. Quand un fournisseur avec lequel nous travaillons servira Inkling 2 Small, l'ajouter reviendra à changer le nom du modèle.
La meilleure préparation consiste à mesurer dès aujourd'hui ce que vous coûte vraiment une tâche, avec le même prompt sur plusieurs modèles :
from openai import OpenAI

client = OpenAI(api_key="YOUR_EDENAI_API_KEY", base_url="https://api.edenai.run/v3")

task = (
    "Read this quarterly result and list the three main risks: "
    "revenue +4%, gross margin -3 pts, inventory +22%, cash -15%."
)

# add Inkling 2 Small to this list when a provider serves it
for model in [
    "deepinfra/thinkingmachines/Inkling-Small",
    "google/gemini-3.8-flash",
    "deepinfra/deepseek-ai/DeepSeek-V4.1-Flash-1017",
]:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": task}],
    )
    tokens = response.usage.completion_tokens
    cost = getattr(response, "cost", 0)  # Eden AI returns the cost of each call
    print(f"{model}: {tokens} output tokens, ${cost:.4f}")
Nous l'avons lancé le 9 novembre 2026. Pour le même prompt, DeepSeek V4.1 Flash a répondu en 108 tokens de sortie pour moins de 0,0001 $, Inkling Small en 696 tokens pour environ 0,0009 $, et Gemini 3.8 Flash en 599 tokens pour environ 0,0023 $. Même tâche, un écart de 1 à 6 en tokens et de 1 à 30 en coût : c'est ce que la grille tarifaire ne dit pas.
Une fois votre modèle choisi, Eden AI prend en charge la production :
- Une facture et une clé pour tous les modèles : tester un nouveau modèle ne commence jamais par un nouveau contrat.
- Des fallbacks vers un autre modèle ou fournisseur en cas de panne, définis dans la même requête.
- Le routage par fournisseur pour trier les fournisseurs par prix ou fixer votre propre ordre, quand un même modèle est servi par plusieurs d'entre eux.
Points à garder en tête
- La plupart des benchmarks viennent de Thinking Machines : Artificial Analysis confirme le niveau général, mais testez sur vos propres tâches avant de changer de modèle.
- Pas de date ferme pour les poids : Thinking Machines a annoncé « la semaine prochaine » le 5 novembre, après les tests de sécurité. Ne planifiez pas de migration sur cette base.
- Il consomme beaucoup de tokens : environ 150 000 tokens de sortie par tâche sur l'Intelligence Index. Surveillez votre consommation et adaptez le niveau d'effort à la tâche.
- Les prix de Tinker ne sont pas définitifs : quand des fournisseurs hébergeront le modèle, les prix dépendront de chacun.
FAQ
Qu'est-ce qu'Inkling 2 Small ?
Inkling 2 Small est un modèle multimodal de Thinking Machines Lab, sorti le 5 novembre 2026. C'est un modèle mixture-of-experts de 594 milliards de paramètres, dont 17 milliards actifs, qui accepte texte et images en entrée et renvoie du texte. Il obtient 31 à l'Intelligence Index d'Artificial Analysis.
Combien coûte Inkling 2 Small ?
Sur Tinker, 0,30 $ par million de tokens en entrée, 0,03 $ pour l'entrée mise en cache et 1,00 $ par million de tokens en sortie. Artificial Analysis a mesuré un coût moyen de 1,18 $ par tâche de l'Intelligence Index, contre 7,77 $ pour Gemini 3.8 Flash (high).
Inkling 2 Small est-il open source ?
Pas encore. Il est sorti avec des poids fermés sur Tinker. Thinking Machines prévoit de publier les poids sous licence Apache 2.0 après des tests de sécurité externes, et l'a annoncé pour la semaine suivant la sortie.
Inkling 2 Small est-il meilleur qu'Inkling Small ?
Oui, nettement : 31 à l'Intelligence Index d'Artificial Analysis contre 13, avec de gros progrès sur les tâches agentiques, la vision et le raisonnement. Il utilise aussi environ quatre fois plus de tokens de sortie par tâche, donc il coûte plus cher à l'usage.
Inkling 2 Small est-il disponible sur Eden AI ?
Pas encore, car il n'est servi que sur Tinker pour l'instant. Inkling et Inkling Small sont disponibles sur Eden AI aujourd'hui. Quand un fournisseur servira Inkling 2 Small, il pourra être ajouté au catalogue et appelé avec la même API.