Résumez cet article avec :
Tout envoyer à un grand modèle de langage, c'est le réflexe de 2026. En 2027, les modèles spécialisés feront l'essentiel du travail. Nous avons comparé les deux sur trois tâches.
En 2026, la plupart des produits d'IA ont un réflexe : tout envoyer à un grand modèle de langage. Les résumés, bien sûr, mais aussi les factures, la modération, la traduction, les données personnelles. Un LLM sait tout faire, alors il finit par tout faire.
Ce réflexe est en train de changer. Gartner prévoit que d'ici 2027, les entreprises utiliseront des petits modèles spécialisés au moins trois fois plus que les LLM généralistes, parce qu'ils répondent plus vite, consomment moins de calcul et coûtent moins cher à faire tourner.
Chez Eden AI, nous appelons ces modèles spécialisés des expert models. Nous avons soumis trois tâches courantes à un expert model et à un LLM rapide pour voir où se trouve vraiment la différence.
Qu'est-ce qu'un modèle d'IA spécialisé ?
Un modèle d'IA spécialisé est conçu et entraîné pour une seule tâche : lire une facture, transcrire la parole, détecter un contenu toxique, retirer des données personnelles, traduire un texte. Il ne discute pas et ne raisonne sur rien d'autre. En échange, il renvoie un résultat structuré et prévisible, en général plus vite et moins cher qu'un modèle généraliste.
Eden AI donne accès aux deux types de modèles avec la même clé API :
| LLM généralistes | Modèles d'IA spécialisés (expert models) | |
|---|---|---|
| Conçus pour | Toute tâche texte ou multimodale : chat, raisonnement, rédaction, appel d'outils | Une seule tâche : OCR, transcription, traduction, modération, données personnelles, analyse d'image... |
| Sortie | Texte libre, ou JSON si on le demande | Un format fixe et structuré, souvent avec des scores de confiance |
| Tarif | Au token, variable selon la longueur du prompt et le raisonnement | À la page, au caractère, à la seconde ou à la requête |
| Sur Eden AI | Environ 1 000 modèles sur /v3/chat/completions | 265 modèles de 47 fournisseurs, 37 tâches, sur /v3/universal-ai |
| Nom du modèle | google/gemini-3.8-flash | text/anonymization/microsoft |
Nous avons testé les deux sur trois tâches
Mêmes données, envoyées via Eden AI le 2 novembre 2026 : une fois à un expert model, une fois à Gemini 3.8 Flash, un LLM rapide et peu cher, avec ses réglages par défaut. Chaque appel a été lancé trois fois, la latence indiquée est la médiane.
| Tâche | Expert model | Gemini 3.8 Flash (LLM) | Verdict |
|---|---|---|---|
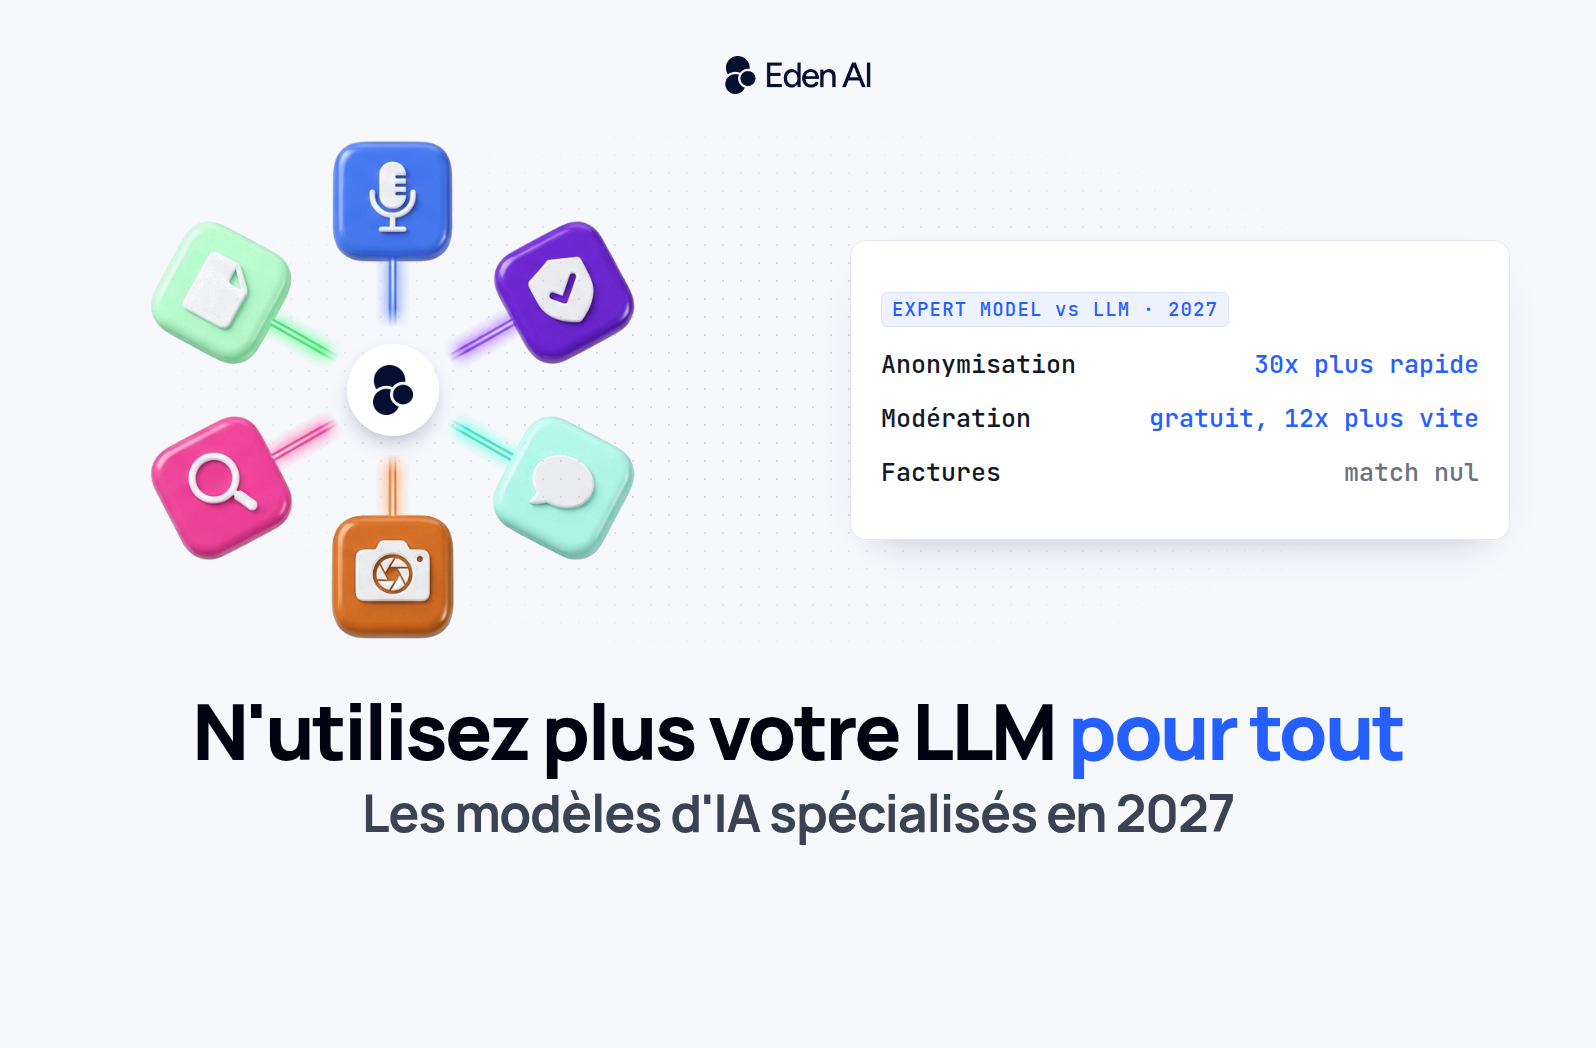
| Retrait des données personnelles | Microsoft : 0,28 s, 0,00025 $, chaque élément typé et localisé | 8,96 s, environ 0,0037 $, tout est masqué | Expert : ~30x plus rapide, ~15x moins cher |
| Modération | Modération OpenAI : 0,41 s, gratuit, scores sur 13 catégories | 5,11 s, environ 0,0014 $, sa propre estimation de gravité | Expert : gratuit, ~12x plus rapide |
| Lecture de facture (1 page) | Microsoft : 6,06 s, 0,01 $, champs clés justes sauf l'IBAN | 9,52 s, environ 0,0055 $, tous les champs justes | Match nul : testez sur vos documents |
Données personnelles : l'expert gagne largement
Nous avons envoyé un ticket client contenant un nom, un email, un numéro de téléphone, une adresse et un IBAN. Les deux approches ont tout masqué. L'expert model a répondu en 0,28 seconde pour 0,00025 $, soit environ 30 fois plus vite et 15 fois moins cher que le LLM. Il a aussi renvoyé le type, la position et le score de confiance de chaque élément trouvé, exactement ce qu'il faut pour un audit.
Modération : gratuite, instantanée et notée
Sur un message menaçant, le modèle de modération d'OpenAI a répondu en 0,41 seconde, gratuitement, avec un score pour chacune de 13 catégories, dont 0,98 pour le harcèlement. Le LLM a lui aussi signalé le message, mais en 5 secondes, avec sa propre estimation de la gravité. Des scores par catégorie se transforment facilement en seuils ; l'avis d'un LLM est plus difficile à régler.
Lecture de facture : match nul
Sur une facture propre d'une page, le parser de factures de Microsoft a trouvé le numéro, les dates, les lignes, la TVA et les totaux en 6 secondes pour 0,01 $, avec des dates au format standard. Il a raté l'IBAN. Gemini 3.8 Flash a tout trouvé, IBAN compris, pour environ un demi-centime, mais en 9,5 secondes, et en gardant les dates telles qu'écrites sur le document.
Sur des documents simples, un LLM rapide est une vraie option. Les parsers spécialisés gardent l'avantage de la structure : le même format de sortie pour la douzaine de parsers de factures disponibles sur Eden AI, ce qui permet de changer de fournisseur sans réécrire son code.
Quand choisir un modèle spécialisé, et quand un LLM
- Choisissez un modèle spécialisé pour les tâches ciblées et répétitives à gros volume : modération, retrait de données personnelles, transcription, OCR, traduction, analyse d'image. Vous gagnez en coût, en latence et en fiabilité du résultat.
- Choisissez un modèle spécialisé quand vous devez prouver ce qui s'est passé : scores de confiance, positions et catégories s'auditent plus facilement qu'un texte libre.
- Choisissez un LLM pour le travail ouvert : raisonnement, rédaction, formats inhabituels, ou tâches qui changent chaque semaine.
- Combinez les deux dans la plupart des vrais produits. Gartner recommande d'ailleurs des approches composites, avec plusieurs modèles et plusieurs étapes plutôt qu'un seul modèle qui fait tout.
Un schéma courant : les modèles spécialisés prennent les étapes qui doivent être rapides, peu chères ou conformes, et le LLM prend l'étape qui demande du jugement.
Combiner les deux avec Eden AI
Sur Eden AI, LLM et expert models partagent la même URL de base et la même clé API. Dans cet exemple, un modèle spécialisé retire les données personnelles d'un ticket de support avant qu'un LLM rédige la réponse : le LLM ne voit jamais les coordonnées du client.
import requests

BASE = "https://api.edenai.run/v3"
headers = {"Authorization": "Bearer YOUR_EDENAI_API_KEY"}

ticket = ("Hi, this is Claire Dubois. My order 55102 has not arrived. "
          "Reach me at [email protected] or +33 6 12 34 56 78.")

# 1. Un modèle spécialisé retire d'abord les données personnelles
anon = requests.post(f"{BASE}/universal-ai", headers=headers, json={
    "model": "text/anonymization/microsoft",
    "input": {"text": ticket, "language": "en"},
}).json()
safe_text = anon["output"]["result"]

# 2. Le LLM ne voit que le texte anonymisé
reply = requests.post(f"{BASE}/chat/completions", headers=headers, json={
    "model": "google/gemini-3.8-flash",
    "messages": [{"role": "user", "content": f"Draft a short support reply to this ticket:\n{safe_text}"}],
}).json()

print(reply["choices"][0]["message"]["content"])
Nous l'avons lancé le 2 novembre 2026 : le nom, l'email et le téléphone ont été masqués avant que le LLM rédige sa réponse. L'ensemble a coûté environ un quart de centime.
Ce qu'apporte Eden AI :
- Une clé pour les deux mondes : environ 1 000 LLM sur
/v3/chat/completions, et plus de 250 expert models de 47 fournisseurs sur/v3/universal-ai, pour 37 tâches. Voir LLMs vs expert models dans notre documentation. - Changer de fournisseur en une chaîne :
text/anonymization/microsoftdevienttext/anonymization/amazon, et le format de sortie reste le même. - Les agents peuvent les utiliser comme outils : notre serveur MCP met les expert models, comme l'OCR, la recherche web, la parole et la traduction, à disposition de tout client MCP ou boucle d'agent.
- L'Europe quand il le faut : plus de 100 expert models sont disponibles dans la région UE.
Points à garder en tête
- Nos tests sont indicatifs : une donnée par tâche, des données fictives, trois passages chacun. Testez sur vos propres données avant de choisir.
- Le coût d'un LLM dépend du prompt : un document plus long, ou un modèle qui raisonne davantage, change la facture. Les expert models sont en général facturés à la page, au caractère ou à la seconde, ce qui est plus facile à prévoir.
- Vérifiez les langues et les régions : tous les expert models ne couvrent pas toutes les langues ni toutes les régions, et le catalogue indique les deux pour chaque modèle.
- Le chiffre de Gartner est une prévision, publiée en avril 2025, pas une mesure.
Si vous hésitez encore sur la taille de modèle pour vos usages LLM, notre guide SLM vs LLM en production traite cet aspect de la question.
FAQ
Qu'est-ce qu'un modèle d'IA spécialisé ?
Un modèle d'IA spécialisé, aussi appelé modèle dédié ou expert model, est conçu pour une seule tâche : OCR, transcription, traduction, modération ou retrait de données personnelles. Il renvoie un résultat structuré et, pour cette tâche, il est en général plus rapide et moins cher qu'un LLM généraliste.
Les modèles spécialisés sont-ils meilleurs que les LLM ?
Pour les tâches ciblées et répétitives, souvent oui. Dans nos tests, un expert model a retiré les données personnelles environ 30 fois plus vite et 15 fois moins cher qu'un LLM rapide, et la modération était gratuite. Pour le travail ouvert et le raisonnement, les LLM restent le meilleur choix.
Pourquoi les modèles spécialisés vont-ils progresser en 2027 ?
Gartner prévoit que d'ici 2027, les entreprises utiliseront des petits modèles spécialisés au moins trois fois plus que les LLM généralistes, parce qu'ils répondent plus vite, consomment moins de calcul et réduisent les coûts d'exploitation.
Que sont les expert models sur Eden AI ?
Ce sont les modèles d'IA spécialisés d'Eden AI : plus de 250 modèles de 47 fournisseurs pour 37 tâches, dont l'OCR, la lecture de documents, la parole, la traduction, la modération, l'analyse d'image et la recherche web. Ils passent par l'endpoint /v3/universal-ai, avec la même clé API que les LLM.
Peut-on utiliser modèles spécialisés et LLM ensemble ?
Oui. Sur Eden AI, les deux utilisent la même clé API et la même URL de base : un même workflow peut appeler un expert model pour une étape et un LLM pour la suivante, comme dans l'exemple ci-dessus.