Résumez cet article avec :
DeepSeek V4.1 Flash et Jev, le modèle le plus vite adopté sur l'AI Gateway de Vercel, signalent le même virage : des décisions IA pour une fraction de centime les mille appels.
Deux lancements de ces dernières semaines en disent long sur l'évolution des dépenses en IA, et aucun des deux n'est un modèle plus gros.
Le premier est DeepSeek V4.1 Flash, un modèle rapide et bon marché que DeepSeek utilise désormais pour servir les requêtes envoyées à V4 Pro, facturées au tarif Flash, selon TechNode. Le second est Jev, un modèle de TypeSafe qui ne sait pas écrire un seul mot. Il a atteint 13 % des équipes payantes de l'AI Gateway de Vercel dans les 24 heures suivant son lancement, l'adoption la plus rapide de l'histoire de cette passerelle, selon The Next Web.
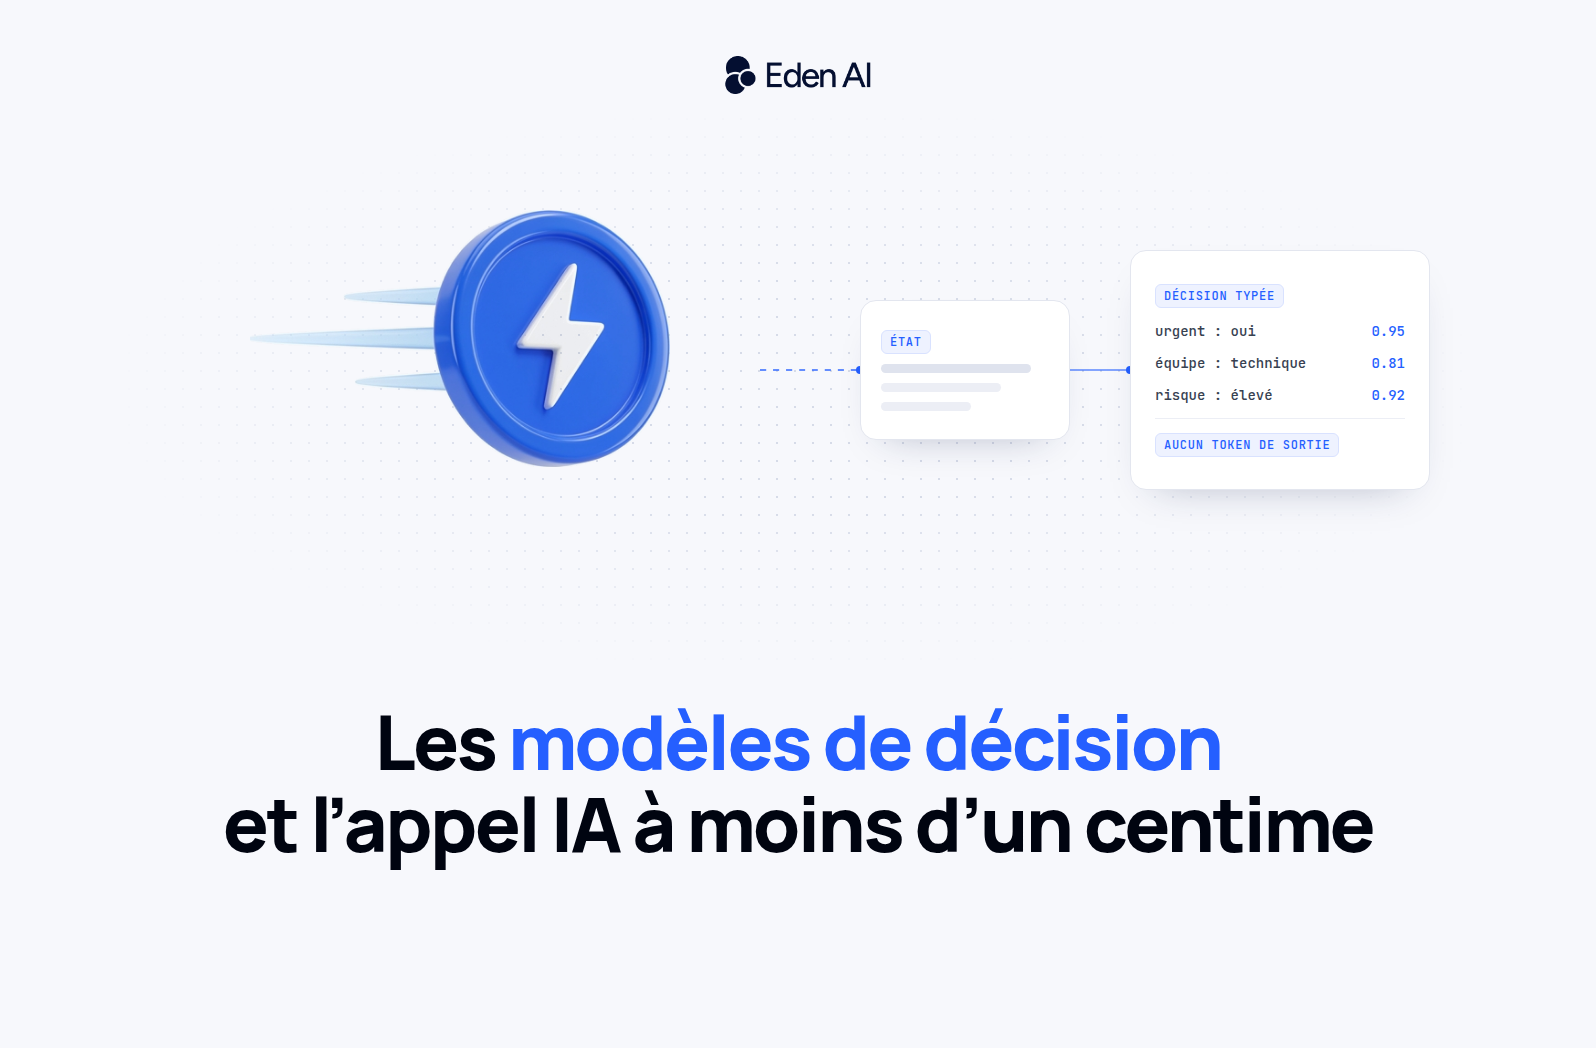
Les deux signalent le même virage. Une part croissante des appels IA en production ne demande pas un texte. Elle demande une décision : quelle équipe, quelle catégorie, est-ce un remboursement, à quel point est-ce urgent. Et ces décisions deviennent assez bon marché pour être prises à chaque requête.
Ce que coûte une décision aujourd'hui
Nous avons envoyé le même ticket de support, « J'ai été facturé deux fois pour ma facture d'octobre et j'ai besoin d'un remboursement aujourd'hui », à orienter vers la facturation, la technique ou les ventes, via l'API d'Eden AI le 21 octobre 2026. Trois configurations, toutes avec la bonne réponse :
| Configuration | Ce qui revient | Latence médiane | Coût pour 1 000 décisions |
|---|---|---|---|
| Jev, modèle de décision | « billing », avec une probabilité pour chaque équipe | 318 ms | 0,015 $ |
| DeepSeek V4.1 Flash, route A | « billing », en texte | 868 ms | 0,0055 $ |
| DeepSeek V4.1 Flash, route B | « billing », en texte, après un raisonnement | 2 064 ms | 0,038 $ |
À ces prix, le coût n'est plus une raison de ne pas placer un modèle devant chaque requête. Mille décisions coûtent entre un demi-centime et quatre centimes. Un million coûtent de quelques dollars à quelques dizaines de dollars.
Le tableau cache aussi une leçon. Le même modèle, DeepSeek V4.1 Flash, a coûté sept fois plus cher sur la route B que sur la route A, parce que cette route raisonne avant de répondre et a dépensé environ 70 tokens de sortie pour écrire un seul mot. En génération de texte, le prix par token n'est que la moitié de la facture. L'autre moitié, c'est le nombre de tokens que le modèle décide de produire.
De la génération à la décision
Un modèle de décision fonctionne différemment d'un modèle de chat. Vous envoyez un état, le texte à évaluer, et des questions typées à son sujet. Le modèle lit tout une seule fois et renvoie une valeur pour chaque question, sans écrire de texte :
- Oui ou non : une probabilité que quelque chose soit vrai, par exemple « est-ce une demande de remboursement ? »
- Une option parmi plusieurs : l'option retenue et la probabilité de chaque option, par exemple « quelle équipe doit traiter ce ticket ? »
- Un niveau sur une échelle : un score sur votre propre grille, par exemple « à quel point est-ce urgent ? »
Ce fonctionnement a trois conséquences. La réponse est toujours l'une des options que vous avez définies, donc rien à analyser et aucune catégorie inventée. Chaque réponse porte sa propre confiance, donc votre code peut agir quand le modèle est sûr et passer la main à une personne sinon. Et comme rien n'est généré, il n'y a pas de tokens de sortie à payer : Jev n'est facturé qu'en entrée, à 0,042 $ par million de tokens.
Jev n'est pas seul. Via l'endpoint de décisions d'Eden AI, vous pouvez aussi appeler aujourd'hui Metis de GreenPT, le modèle de décision de Microsoft sur Azure, un modèle de décision d'OpenAI et une préversion de Qwen. Quand plusieurs labos lancent la même nouvelle catégorie en quelques semaines, c'est en général que le besoin existait déjà.
Quel outil pour quelle tâche
| Tâche | Le plus adapté | Pourquoi |
|---|---|---|
| Orienter un ticket, un lead ou une requête | Modèle de décision | Options fixes, score de confiance, rien à analyser |
| Filtrer : spam, remboursement, prêt à envoyer ? | Modèle de décision | Une probabilité que votre code peut seuiller |
| Pré-filtre avant un modèle coûteux | Modèle de décision ou LLM rapide bon marché | Coûte une fraction de l'appel qu'il peut éviter |
| Extraction courte ou réponse d'une ligne | LLM rapide bon marché | La sortie, ce sont des mots, pas une option fixe |
| Rédiger, expliquer, coder | LLM généraliste | Les modèles de décision ne savent pas écrire |
Le schéma le plus utile combine les deux. Un modèle de décision lit chaque requête entrante et décide de la suite : répondre automatiquement, envoyer vers un modèle bon marché, vers un modèle de pointe, ou vers une personne. Le modèle coûteux ne tourne que quand il est vraiment nécessaire.
Ce qu'il faut garder en tête
- Les chiffres des vendeurs restent ceux des vendeurs : TypeSafe annonce Jev jusqu'à 193,6 fois plus rapide et 444,6 fois moins cher que des LLM sur ses propres évaluations. Votre ratio dépend de vos prompts, de votre modèle actuel et de votre trafic. Notre test ci-dessus montre un écart plus modeste, mais réel.
- Testez sur vos propres données : un modèle de décision ne vaut que par les questions et les options que vous lui donnez. Formulez les questions positivement et gardez des options bien distinctes : les négations sont faciles à mal interpréter.
- Regardez la confiance, pas seulement la réponse : les probabilités sont tout l'intérêt. Fixez à l'avance le seuil qui déclenche l'automatisation et celui qui déclenche une revue humaine.
- Surveillez les tokens de sortie des LLM bon marché : un modèle qui raisonne avant de répondre peut multiplier le coût d'une réponse d'un mot, comme le montre la route B. Vérifiez le champ
usagesur de vraies requêtes, pas seulement la grille de prix. - Vérifiez la région : Jev est servi depuis les États-Unis aujourd'hui. Si vos données doivent rester en Europe, Metis et le modèle de décision de Microsoft ont des routes UE sur Eden AI.
Essayer les deux via Eden AI
Une décision via l'endpoint de décisions d'Eden AI :
import requests

response = requests.post(
    "https://api.edenai.run/v3/alpha/decisions",
    headers={"Authorization": "Bearer YOUR_EDENAI_API_KEY"},
    json={
        "model": "typesafe/jev-latest",
        "state": "Hi, I was charged twice for my October invoice and I need a refund today.",
        "questions": {
            "is_refund": {"type": "noul", "instructions": "Is this a refund request?"},
            "team": {
                "type": "choice",
                "instructions": "Which team should handle this?",
                "criteria": {
                    "billing": "Payments, invoices, refunds",
                    "technical": "Bugs, outages, integrations",
                    "sales": "Pricing, upgrades, new accounts",
                },
            },
        },
    },
)
print(response.json()["answers"])
Remplacez le nom du modèle par greenpt/metis ou azure/microsoft-decision-1@eu pour comparer les modèles de décision sur les mêmes questions. L'endpoint de décisions est en alpha, ses formats de requête et de réponse peuvent encore évoluer ; la documentation des décisions donne le détail.
Le même ticket via un LLM bon marché passe par l'endpoint standard de chat completions, avec la route DeepSeek V4.1 Flash de votre choix. Comparez latence, coût et champ usage sur vos propres requêtes avant d'en choisir une.
Par où commencer
Choisissez une décision que votre produit prend des milliers de fois par jour, l'orientation d'un ticket, une détection de spam ou un score de lead, et faites-la passer par un modèle de décision en parallèle de votre solution actuelle pendant une semaine. Si les réponses tiennent et que les scores de confiance se comportent bien, vous avez fait passer un coût récurrent de quelques centimes à une fraction de centime, et libéré vos gros modèles pour le travail qui en a besoin. Pour aller plus loin sur l'adéquation entre coût du modèle et tâche, voyez notre guide du routage prix-performance.
Questions fréquentes
Qu'est-ce qu'un modèle de décision ?
Un modèle de décision répond à des questions typées sur un texte, comme oui ou non, une option parmi plusieurs ou un niveau sur une échelle, et renvoie une valeur avec sa probabilité au lieu de générer du texte. Il lit l'entrée une seule fois, ce qui le rend rapide, et il est en général facturé uniquement sur les tokens d'entrée.
Combien coûte une décision IA aujourd'hui ?
Dans notre test du 21 octobre 2026, orienter un ticket de support a coûté entre 0,0055 $ et 0,038 $ les mille décisions selon le modèle et la route. Soit une fraction de centime les mille appels avec un LLM bon marché, et environ un centime et demi les mille avec Jev.
Pourquoi Jev est-il adopté si vite ?
Jev a atteint 13 % des équipes payantes de l'AI Gateway de Vercel dans les 24 heures suivant son lancement. Il répond à un besoin courant, les petites décisions répétées dans les applications, avec des réponses typées, des scores de confiance, un prix bas et aucun token de sortie à payer.
Faut-il remplacer son LLM par un modèle de décision ?
Seulement pour les décisions. Un modèle de décision ne sait pas écrire, résumer, extraire du texte libre ni s'expliquer. Utilisez-le pour le routage, la classification, le filtrage et le scoring, et gardez un modèle généraliste pour tout ce qui demande des mots.
Peut-on utiliser des modèles de décision dans l'UE ?
Oui, avec le bon modèle. Sur Eden AI, Metis de GreenPT et le modèle de décision de Microsoft ont des routes UE. Jev est servi depuis les États-Unis aujourd'hui.