Résumez cet article avec :
Le Next-Concept Modeling (NCM), développé par le laboratoire Hazy Research de Stanford et Together AI, génère du texte en partant d'une structure globale vers des détails précis, plutôt que jeton par jeton. Il affiche une vitesse de génération 10 à 31 fois supérieure à celle des modèles de langage par diffusion performants. Cet article explique le fonctionnement du NCM, la signification réelle de ses benchmarks, sa comparaison avec les LLM actuels et ses implications pour les équipes qui développent des produits basés sur l'IA.
Le Next-Concept Modeling (NCM) est un nouveau cadre de génération de texte issu du laboratoire Hazy Research de Stanford et de Together AI, publié sur arXiv le 9 octobre 2026. Au lieu de prédire un jeton à la fois, il construit le texte d'une structure globale vers des détails précis. Dans les expériences des auteurs, il a égalé ou surpassé les modèles de langage par diffusion tout en générant 10 à 31 fois plus vite et en s'entraînant sur environ 4 à 5 fois moins de jetons.
Ces chiffres ont rapidement donné lieu à des titres comparant « NCM vs LLM ». Cette comparaison est pertinente, mais pas de la manière dont la plupart des titres le suggèrent. Les résultats du NCM proviennent de petits modèles de recherche comparés à des modèles de diffusion, et non à des systèmes de la classe de GPT, Claude ou Mistral. Voici ce que cette approche change, ce que les benchmarks démontrent réellement et ce que cela signifie pour les équipes qui développent aujourd'hui des modèles de langage.
Trois méthodes pour générer du texte
La plupart des grands modèles de langage sont autorégressifs. Ils prédisent le jeton suivant, l'ajoutent à la séquence et répètent l'opération jusqu'à ce que la réponse soit complète. Le traitement de l'invite peut être effectué en parallèle, mais chaque jeton de sortie dépend des précédents, ce qui rend le décodage séquentiel.
Les modèles de langage par diffusion empruntent une voie différente. Ils partent d'une séquence corrompue et affinent de nombreuses positions en parallèle sur plusieurs itérations. Cela réduit le nombre d'étapes séquentielles, mais chaque itération traite généralement la séquence complète, et la qualité a tendance à diminuer lorsque le nombre d'itérations est réduit.
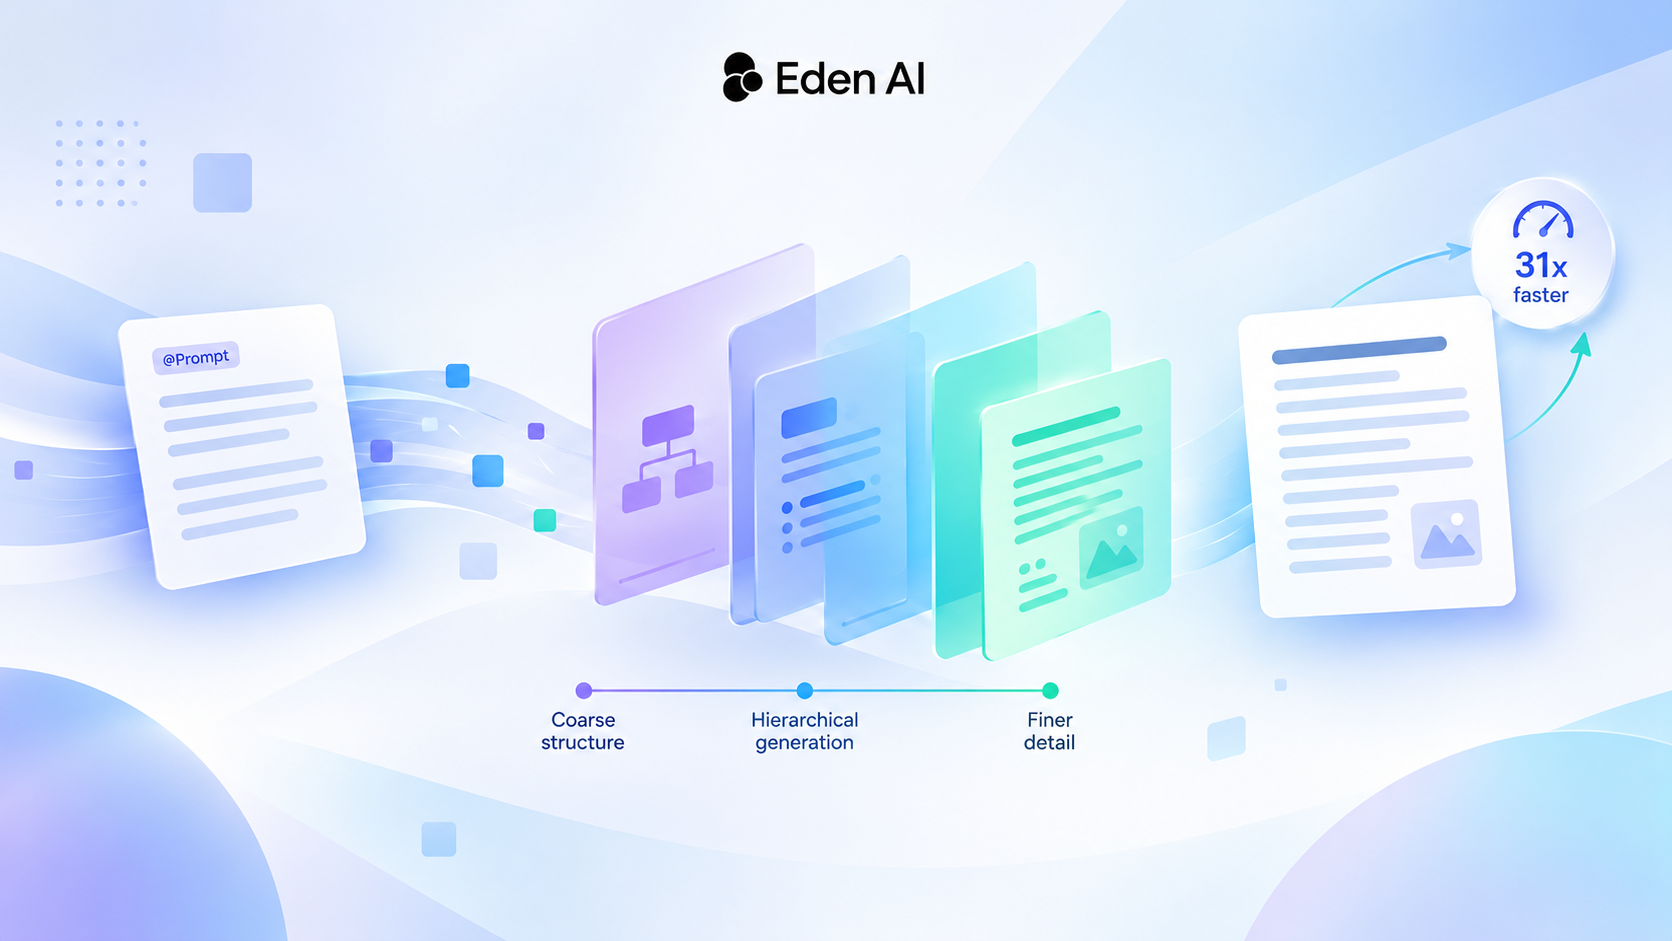
Le Next-Concept Modeling explore une troisième option. Il ne prédit pas des jetons individuels et ne raffine pas non plus de manière répétée une séquence complète de jetons. Au lieu de cela, il représente le texte sous forme de hiérarchie et génère cette hiérarchie du plus général au plus détaillé.
Le NCM ne se contente pas de générer plusieurs jetons à la fois. Il modifie ce qui est généré, à savoir une hiérarchie apprise de codes discrets plutôt que des jetons, ainsi que l'ordre dans lequel le résultat prend forme.
Comment fonctionne le Next-Concept Modeling
Le NCM adapte une idée issue de la génération d'images au domaine du texte. Il s'agit de la prédiction à l'échelle suivante, popularisée par VAR, qui a remporté le prix du meilleur article à NeurIPS 2024 : générer d'abord une version basse résolution, puis ajouter les détails. Le texte est plus complexe que les images à cet égard, car il n'existe pas de moyen naturel de « sous-échantillonner » une phrase. Les représentations globales doivent être apprises.
Étape 1 : Apprendre une hiérarchie. Les chercheurs entraînent un auto-encodeur variationnel à quantification vectorielle résiduelle (VQ-VAE) multi-échelle qui convertit le texte en codes discrets répartis sur plusieurs niveaux. Les premiers niveaux ne contiennent que quelques codes et capturent la structure globale. Les niveaux suivants sont plus longs, et chacun code ce que les niveaux précédents ont laissé inexpliqué. Un décodeur transforme ensuite la hiérarchie complète en texte. Une fois entraîné, ce tokeniseur est figé.
Étape 2 : Apprendre à générer la hiérarchie. Un transformeur apprend à prédire chaque niveau à partir des niveaux précédents. Au moment de l'inférence, il génère les niveaux dans l'ordre, mais prédit tous les codes au sein d'un même niveau en parallèle. Le décodeur transforme ensuite le résultat en texte final.
Un exemple de traduction
Les auteurs illustrent le processus avec une traduction de l'allemand vers l'anglais. Un modèle autorégressif écrirait la phrase anglaise mot à mot. Le premier niveau décodé par le NCM est à peine lisible. Chaque niveau ultérieur ajoute et corrige des détails, et au onzième et dernier niveau, la sortie correspond étroitement à la traduction de référence, avec un score BLEU de 77,8. L'amélioration n'est pas parfaitement constante, car la qualité augmente et diminue entre les niveaux intermédiaires, mais le mouvement global va de l'ébauche à la phrase finie. Vous pouvez parcourir l'exemple niveau par niveau sur le blog de Hazy Research.
Pourquoi est-ce plus rapide : moins d'étapes, des étapes moins coûteuses
L'efficacité du NCM provient de deux sources. Premièrement, il nécessite beaucoup moins d'étapes séquentielles que les modèles de diffusion pour atteindre une qualité similaire. Deuxièmement, ses premières étapes sont peu coûteuses, car les niveaux grossiers ne contiennent que quelques codes, tandis qu'un modèle de diffusion traite la séquence complète à chaque étape.
Ce que signifie « concept » ici
Le mot concept nécessite quelques précautions. Dans le NCM, il fait référence aux informations contenues dans les niveaux grossiers d'une hiérarchie de codes apprise. Il ne s'agit pas d'affirmer que le modèle raisonne comme un humain ou travaille avec des idées compréhensibles par l'homme. Les niveaux grossiers semblent capturer une structure utile, ce qui est une propriété architecturale intéressante, mais cela ne doit pas être interprété comme une déclaration sur l'intelligence.
Cela aide également à distinguer le NCM d'un projet au nom similaire. Les Large Concept Models (LCM)de Meta, publiés en décembre 2024, traitent chaque phrase comme un « concept ». Ils prédisent la phrase suivante de manière autorégressive dans SONAR, un espace d'encodage de phrases existant. Le NCM, quant à lui, apprend sa propre hiérarchie de codes discrets et la génère niveau par niveau, en parallèle au sein de chaque niveau. Les noms sont similaires, mais les architectures sont très différentes.
Ce que montrent les benchmarks
L'article évalue le NCM sur la modélisation linguistique inconditionnelle, la traduction automatique, le résumé et le Sudoku. Les comparaisons sont effectuées par rapport à des modèles de langage par diffusion performants à échelles de paramètres équivalentes.
Les trois chiffres de vitesse proviennent de trois expériences différentes et ne doivent pas être combinés en une seule affirmation universelle. Le résultat de 21× provient de la génération inconditionnelle sur LM1B, le résultat de 10× provient d'OpenWebText, et le résultat de 31× provient du résumé sur XSum.
Les auteurs mesurent également le temps réel (wall-clock time) plutôt que de simplement compter les étapes de génération. C'est important, car une étape qui traite quelques codes coûte beaucoup moins cher qu'une étape traitant la séquence complète, et le nombre d'étapes seul occulte cette différence.
Les économies de jetons d'entraînement sont un résultat distinct. Une réduction d'environ 4 à 5 fois du nombre de jetons est notable, d'autant plus qu'elle inclut l'entraînement du tokeniseur. Néanmoins, cela mesure le nombre de jetons vus par le modèle, et non la puissance de calcul ou le coût total. Le matériel, la préparation des données et le déploiement influencent tous le coût réel d'une charge de travail.
Les Les résultats du Sudoku sont remarquables car chaque cellule doit satisfaire simultanément les contraintes de ligne, de colonne et de bloc. Les auteurs suggèrent que la génération du plus grossier au plus fin facilite ce type de planification globale, car les niveaux ultérieurs peuvent réviser la grille dans son ensemble. Cela fait des tâches structurées une piste prometteuse à explorer, mais cela ne prouve pas que le NCM soit un meilleur raisonneur général.
Une autre conclusion est importante pour les praticiens. Comme le NCM échantillonne rapidement, les auteurs utilisent le temps gagné pour générer plusieurs candidats et choisir le meilleur, en utilisant une technique appelée décodage par risque de Bayes minimal (MBR). Cela améliore les scores de traduction et de résumé tout en maintenant un temps d'échantillonnage total compétitif par rapport aux modèles de référence par diffusion. Échanger de la vitesse contre davantage de candidats est une pratique que les équipes de production utilisent déjà avec les LLM conventionnels.
NCM vs LLM : où en sommes-nous réellement ?
Le NCM est souvent présenté comme un rival direct des systèmes de type GPT, Claude ou Mistral. Une comparaison plus utile consiste à examiner la manière dont chaque approche génère du texte et le degré de maturité de chacune.
La principale limite est l'échelle. La plupart des expériences sur le NCM utilisent des générateurs d'environ 100 millions de paramètres, et les montées en charge jusqu'à 725 millions de paramètres sont décrites comme préliminaires. La conception présente également des contraintes connues :
- Il dépend d'un tokeniseur entraîné séparément puis figé.
- Il utilise une profondeur hiérarchique fixe, de sorte que même une courte continuation passe par tous les niveaux.
- Les auteurs signalent des artefacts occasionnels lors des transitions entre les niveaux grossiers.
Les prochaines étapes de l'équipe de recherche abordent ces points directement : une mise à l'échelle accrue, l'entraînement conjoint du tokeniseur et du générateur, ainsi qu'un calcul adaptatif qui permettrait au modèle de consacrer moins d'efforts aux sorties plus simples.
En résumé, le NCM démontre qu'une stratégie de génération différente peut offrir d'importants gains d'efficacité dans des contextes spécifiques. Il n'a pas encore prouvé d'avantage général sur les LLM de pointe. Cela nécessiterait des preuves à une échelle beaucoup plus vaste, sur de nombreux types de charges de travail et dans des conditions de service réelles.
Ce que le NCM signifie pour les développeurs d'IA
La leçon plus large est que l'efficacité d'un modèle de langage dépend d'autres facteurs que le nombre de paramètres. La manière dont un modèle représente l'information et dont il produit ses résultats peut être tout aussi importante. Pour les équipes évaluant toute nouvelle approche, NCM inclus, les quatre mêmes questions s'appliquent.
Concernant spécifiquement la disponibilité, le Dépôt GitHub de NCMetPoints de contrôle Hugging Face facilitent l'expérimentation. Cependant, chaque point de contrôle est entraîné pour une tâche spécifique (XSum, WMT14, Sudoku, LM1B, TinyStories ou OpenWebText), et aucun n'est pris en charge par un fournisseur d'inférence. Il s'agit d'une version de recherche, et non d'un remplacement immédiat pour un modèle hébergé.
Ce fossé entre « ce qui fonctionne dans un article » et « ce qui fonctionne en production » n'est pas propre à NCM. C'est le même écart que celui que nous avons décrit dans Le fossé dans la compréhension commune des capacités des LLM. La méthode la plus rapide présentée dans un article de recherche n'est pas automatiquement le bon choix pour chaque application, et le modèle le plus puissant ne vaut pas toujours son coût, comme nous l'avons abordé dans L'appel d'IA le plus écologique est celui que vous n'avez pas surdimensionné.
La réponse pragmatique consiste à garder le choix du modèle flexible. Si votre application appelle des modèles via une API unique, adopter une approche plus rapide lorsqu'elle devient prête pour la production signifie modifier une configuration, et non reconstruire votre intégration. Avec Eden AI, par exemple, vous pouvez lister les modèles disponibles et leurs capacités, router les requêtes en fonction du prix, de la vitesse ou de la latence, et mettre en place un système de secours automatique afin que l'expérimentation de nouvelles solutions ne compromette pas la fiabilité. Notre guide sur le routage LLM couvre ces stratégies plus en détail.
La contribution durable de NCM réside peut-être davantage dans la question qu'il soulève que dans les chiffres qu'il rapporte. Il remet en question l'hypothèse selon laquelle la génération de texte efficace doit nécessairement suivre la voie de la prédiction du jeton suivant. La question de savoir s'il transformera l'IA en production dépendra de l'évolution de cette approche à mesure qu'elle passera à l'échelle.
La prochaine génération de systèmes d'IA ne sera peut-être pas définie par une stratégie de génération unique, mais par la pertinence avec laquelle chaque stratégie est adaptée à la tâche qu'elle accomplit.
Pour aller plus loin
À propos du Next-Concept Modeling
- Next-Concept Modeling : Génération de texte rapide et parallèle du général au particulierl'article original.
- Le NCM expliqué par Hazy Research: la présentation des auteurs, avec un exemple de traduction interactive.
- HazyResearch/ncm sur GitHubetPoints de contrôle NCM sur Hugging Face: code, points de contrôle et configuration d'évaluation.
- Large Concept Models : modélisation du langage dans un espace de représentation de phrases: l'approche distincte de Meta au niveau de la phrase, datant de 2024.
Par Eden AI
- Le routage LLM expliqué : meilleures stratégies pour le coût, la vitesse et la qualité
- Le fossé dans la compréhension commune des capacités des LLM
- Documentation d'Eden AI: une API pour plus de 500 modèles, avec routage de fournisseur et solution de secours intégrés.