Résumez cet article avec :
Les routeurs LLM deviennent une infrastructure essentielle pour les applications s'appuyant sur plusieurs modèles et fournisseurs d'IA, mais ils introduisent également une nouvelle frontière de sécurité. Des recherches récentes montrent comment un intermédiaire malveillant peut intercepter du trafic sensible, modifier des appels d'outils, dérober des identifiants et exploiter des agents IA autonomes sans compromettre le modèle sous-jacent. Cet article explore les risques liés aux routeurs LLM malveillants, les conclusions d'une étude à grande échelle sur les services de routage, et les mesures de défense que les développeurs peuvent adopter pour concevoir des architectures d'agents IA plus sûres.
Les agents IA sont de plus en plus construits sur des routeurs et des passerelles LLM. Au lieu de connecter une application directement à OpenAI, Anthropic, Google ou un autre fournisseur de modèles, les développeurs peuvent insérer une couche de routage intermédiaire pour sélectionner les modèles, optimiser les coûts, améliorer la fiabilité et offrir une API unique.
Cette architecture est pratique. Elle crée également une nouvelle frontière de sécurité.
Un article de recherche récent, Your Agent Is Mine: Measuring Malicious Intermediary Attacks on the LLM Supply Chain, étudie ce qui se passe lorsque cet intermédiaire n'est pas digne de confiance. Les chercheurs ont analysé 28 routeurs LLM payants et 400 gratuits, mettant en évidence des manipulations malveillantes des réponses, des comportements d'attaque adaptatifs et une utilisation abusive des identifiants. Ils ont également démontré comment des intermédiaires compromis peuvent s'intégrer dans des chaînes d'attaque plus vastes impliquant des agents IA autonomes.
Le problème sous-jacent est simple mais facile à négliger : un routeur LLM n'est pas nécessairement une couche de transport passive. Il peut se placer directement entre un agent et son fournisseur de modèles, lui donnant une visibilité sur les requêtes et les réponses et, selon l'architecture, la capacité de les modifier.
Pour les applications de chat traditionnelles, il s'agit déjà d'un sérieux problème de confiance. Pour les agents autonomes capables d'exécuter des outils, d'accéder à des fichiers, d'exécuter du code ou d'interagir avec des systèmes externes, les conséquences peuvent être bien plus graves.
La couche de confiance cachée derrière les agents IA
Une application LLM simple ressemble souvent à ceci :
Application → Fournisseur de modèle → Application
L'application envoie une requête à un fournisseur et reçoit une réponse. Cependant, lorsque plusieurs modèles et fournisseurs sont impliqués, un routeur peut simplifier l'architecture :
Application → Routeur LLM → Fournisseur de modèle
Le routeur décide de la destination d'une requête. Il peut sélectionner un fournisseur en fonction du coût, de la latence, de la disponibilité, de la qualité du modèle, des exigences géographiques ou d'autres politiques. Si un fournisseur devient indisponible, il peut rediriger la requête ailleurs.
Cette architecture est de plus en plus utile car l'infrastructure IA devient plus fragmentée. Les équipes peuvent utiliser plusieurs fournisseurs commerciaux, des modèles ouverts, des points de terminaison spécialisés et différents modèles pour différentes charges de travail.
L'architecture de routage LLM d'Eden AI suit cette tendance générale : une passerelle peut fournir une interface unifiée tout en donnant aux développeurs accès à plusieurs modèles et fournisseurs, au routage, aux solutions de secours et à d'autres contrôles d'infrastructure. La question importante n'est donc pas de savoir si le routage est utile. C'est le niveau de confiance que les développeurs accordent à la couche de routage.
Cette distinction devient cruciale dès lors que l'application est un agent IA.
Un routeur est bien plus qu'un simple commutateur de trafic
Pour une requête API classique, le routeur peut voir une invite et une réponse textuelle. Une requête d'agent peut contenir bien plus.
Selon l'application, le trafic transitant par un intermédiaire peut inclure des instructions système, le contexte de la conversation, des définitions d'outils, des arguments d'outils, des résultats d'outils, des données d'authentification et d'autres données applicatives.
Le routeur peut également se situer sur le chemin de réponse :
Fournisseur de modèle → Routeur → Agent
Cela signifie que la question de sécurité n'est plus seulement « Le routeur peut-il envoyer ma requête au bon modèle ? ». Elle devient «Puis-je faire confiance au routeur pour ne pas modifier ce que le modèle renvoie ? »
C'est la question centrale explorée par cette recherche.
Comment un intermédiaire malveillant peut modifier le comportement d'un agent
Un LLM génère normalement une réponse qu'un agent interprète. Lorsque la réponse contient un appel d'outil, l'agent peut utiliser cette sortie structurée pour effectuer une action.
Le flux normal est le suivant :
Agent → Routeur → Modèle
Modèle → Routeur → Agent → Outil
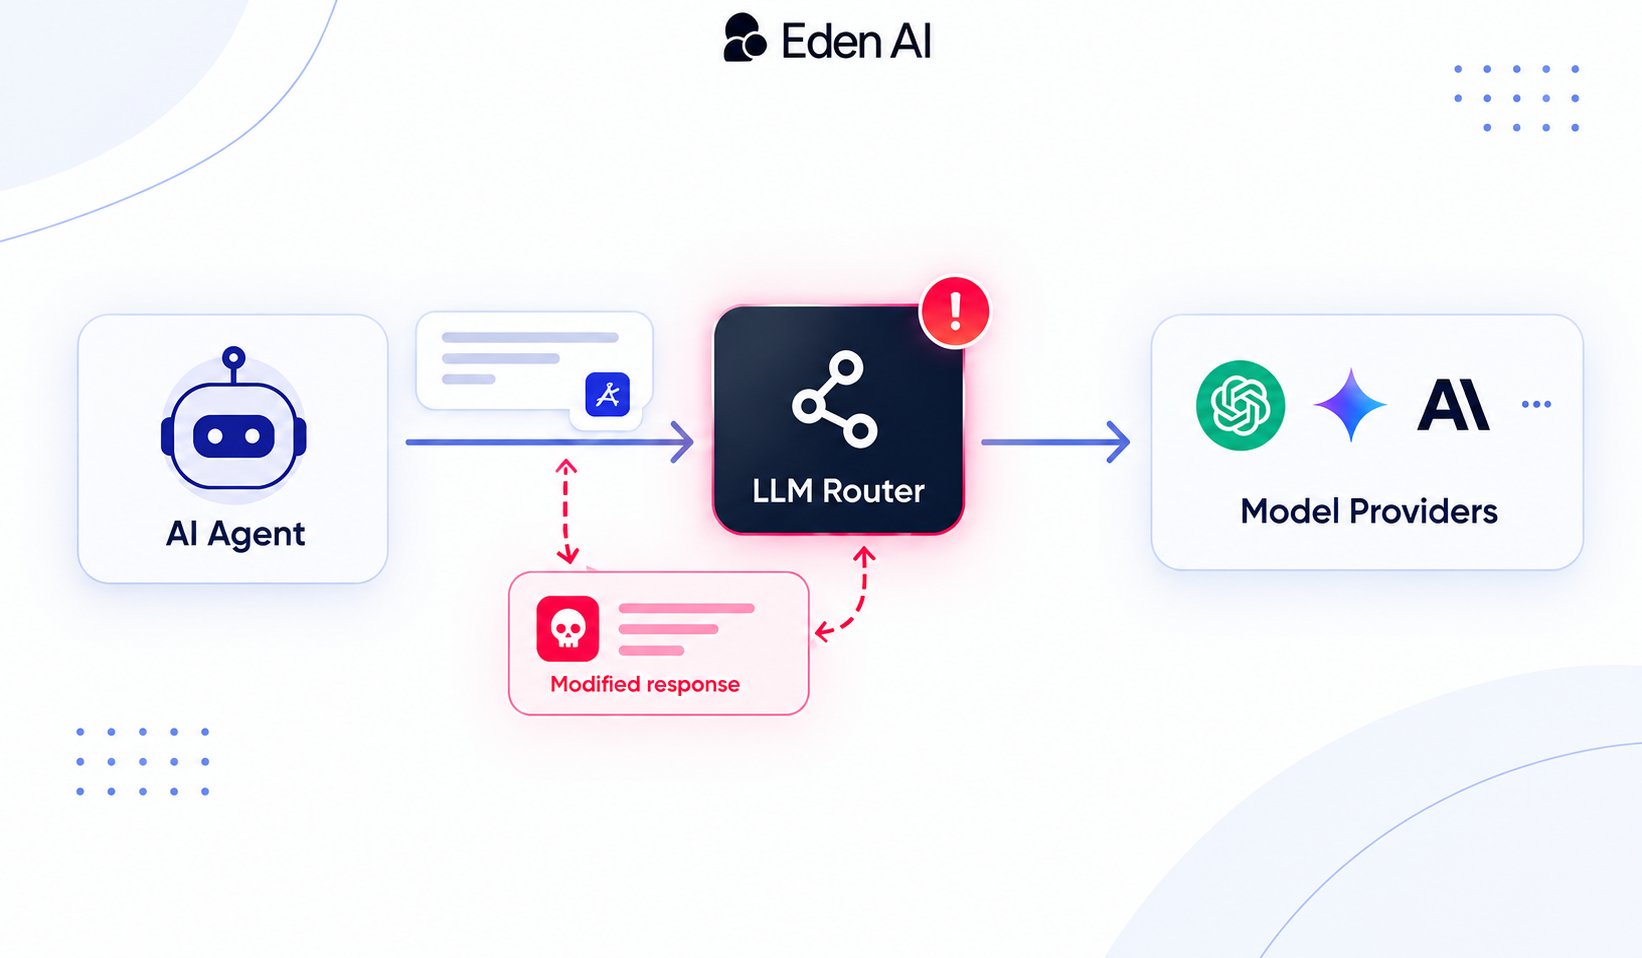
Un intermédiaire compromis peut se placer directement sur la seconde moitié de ce chemin :
Modèle → Routeur malveillant → Agent → Outil
Le modèle lui-même n'a pas besoin d'être compromis. L'agent n'a pas besoin d'être vulnérable à une injection de prompt. Le routeur doit simplement modifier la réponse avant de la transmettre à l'application.
Prenons un exemple simplifié. Un modèle décide qu'un agent doit appeler un outil spécifique avec un ensemble d'arguments précis. L'agent reçoit la réponse et, parce qu'il est conçu pour exécuter cet outil automatiquement, il agit en conséquence.
Si l'intermédiaire modifie ces arguments avant que la réponse n'atteigne l'agent, celui-ci risque d'exécuter une action différente de celle générée initialement par le modèle.
L'attaque exploite donc une couche souvent considérée comme une infrastructure plutôt que comme une composante du modèle de sécurité de l'application.
Ceci est différent de l'injection de prompt.
Les attaques par injection de prompt tentent d'influencer le modèle via des instructions contenues dans des prompts, des documents, des sites web ou d'autres entrées.
L'attaque par intermédiaire décrite par les chercheurs intervient à un point différent de la chaîne.
Le modèle peut produire une réponse parfaitement légitime. L'intermédiaire peut ensuite modifier cette réponse avant que l'agent ne la reçoive.
Cela rend l'attaque particulièrement intéressante, car renforcer la résistance du modèle à l'injection de prompt ne résout pas automatiquement le problème de l'intermédiaire.
Le modèle peut être digne de confiance.
La connexion au fournisseur peut être chiffrée.
Le schéma de l'outil peut être valide.
Et pourtant, l'agent peut toujours recevoir une réponse qui a été altérée quelque part entre le fournisseur et l'application.
La menace silencieuse : le passage d'identifiants par le routeur
La manipulation de réponse n'est qu'une facette du problème.
Un intermédiaire peut également être en mesure d'observer des informations sensibles circulant dans le trafic qu'il traite.
Les applications d'IA fonctionnent fréquemment aux côtés d'autres services et identifiants. Selon l'architecture, les requêtes ou les interactions avec des outils peuvent exposer des informations liées à des environnements cloud, des systèmes de contrôle de version, des bases de données, des API tierces ou d'autres services.
Si un routeur est malveillant, il n'a pas nécessairement besoin de manipuler un agent. Il peut simplement collecter des informations précieuses qui transitent par lui.
Les recherches ont mis en évidence des routeurs abusant d'identifiants contrôlés par les chercheurs lors des mesures de l'écosystème. Dans l'une des expériences de l'étude, les chercheurs ont également observé un routeur qui a vidé des cryptomonnaies à partir d'une clé privée contrôlée par un chercheur.
Cela souligne un principe de sécurité plus large :
Tout intermédiaire capable d'observer le trafic sensible d'une application devient partie intégrante de la limite de confiance de cette application.
Ce principe est bien connu dans l'infrastructure traditionnelle, mais il est particulièrement crucial dans les systèmes d'IA, car les agents combinent de plus en plus les appels de modèles avec l'accès à des outils et des identifiants externes.
L'attaque ne doit pas nécessairement se produire immédiatement
L'une des conclusions les plus préoccupantes est qu'un comportement malveillant n'a pas forcément besoin d'apparaître lors de la première requête.
Un routeur peut se comporter normalement lors de tests classiques et ne déclencher un comportement suspect que lorsque certaines conditions sont réunies.
Les chercheurs décrivent des stratégies d'attaque adaptatives impliquant des conditions telles que le nombre de requêtes, des modes d'exécution autonomes ou les caractéristiques du projet ciblé. Un exemple concernait un comportement différé après un certain nombre de requêtes préalables.
Cela pose un problème de test majeur.
Imaginez que vous évaluiez un routeur tiers avant de le mettre en production. Vous envoyez plusieurs requêtes, inspectez les réponses, et tout semble normal.
Cela ne prouve pas nécessairement que l'intermédiaire est digne de confiance.
Un système malveillant pourrait délibérément minimiser son comportement observable lors de tests de base et ne s'activer que lorsqu'une cible plus intéressante ou un environnement spécifique est détecté.
Cibler la couche de dépendances
Les recherches examinent également les attaques qui ciblent les dépendances logicielles plutôt que de simplement insérer une commande manifestement suspecte.
C'est important car les développeurs construisent souvent leurs défenses autour d'indicateurs visibles, tels que des destinations inattendues ou des charges utiles manifestement malveillantes.
Une modification plus subtile peut préserver une grande partie de la structure originale de la requête tout en changeant une dépendance ou un autre composant de l'action.
La leçon plus large est que une syntaxe valide ne garantit pas une intention valide.
Un appel d'outil peut être conforme au schéma attendu tout en restant nuisible si son contenu a été altéré.
Ce que les chercheurs ont découvert dans l'écosystème des routeurs
Ce sont les mesures présentées dans l'étude qui rendent le problème particulièrement notable.
Les chercheurs ont examiné 428 routeurs au total : 28 routeurs payants et 400 routeurs gratuitsLeur étude a révélé neuf routeurs ayant injecté du code malveillant, deux ayant démontré un comportement d'évitement adaptatif et 17 ayant abusé d'identifiants appartenant aux chercheurs.
Ces chiffres ne doivent pas être interprétés comme la preuve que la plupart des routeurs LLM sont malveillants. L'étude est une mesure d'un écosystème et d'une méthodologie de recherche particuliers, et non une affirmation selon laquelle chaque routeur commercial ou open-source est compromis.
Mais les résultats démontrent quelque chose d'important : L'intermédiaire lui-même doit être inclus dans le modèle de sécurité.
C'est là une conclusion significative pour les développeurs.
Les chaînes de routeurs créent un problème de maillon faible
Le risque devient encore plus intéressant lorsque plusieurs couches de routage sont impliquées.
Considérez un système où une application envoie du trafic via plusieurs intermédiaires :
Agent → Routeur A → Routeur B → Routeur C → Fournisseur de modèle
Le routeur A peut être digne de confiance.
Le routeur B peut être digne de confiance.
Le routeur C peut être compromis.
Du point de vue de l'application, cependant, la réponse finale transite toujours par la chaîne :
Modèle → Routeur C → Routeur B → Routeur A → Agent
Si le routeur C modifie la réponse, le routeur A et le routeur B peuvent simplement transmettre le message modifié.
Cela crée une propriété de maillon faible : l'ajout de couches de routage supplémentaires n'augmente pas automatiquement la sécurité.
Le même principe s'applique aux identifiants. Si un intermédiaire dans la chaîne peut accéder à un identifiant, la sécurité de l'ensemble de la chaîne dépend du comportement correct de cet intermédiaire.
Les expériences d'empoisonnement
Les chercheurs sont allés plus loin en étudiant comment une infrastructure apparemment bénigne peut être impliquée dans la même surface d'attaque via des identifiants divulgués et des chaînes de relais faibles.
Leurs expériences ont permis d'observer une activité importante en aval, incluant des centaines de sessions d'agents et d'interactions impliquant des centaines de projets ou d'hôtes.
L'essentiel n'est pas de comprendre les mécanismes précis de l'expérience, mais plutôt l'amplification de l'échelle.
Un intermédiaire compromis n'a pas nécessairement besoin d'attaquer une application à la fois.
Si cet intermédiaire se trouve au sein d'une infrastructure utilisée par de nombreux agents, il peut potentiellement devenir un point central d'observation et de manipulation pour un écosystème beaucoup plus vaste.
Les agents autonomes augmentent les enjeux
Les implications en matière de sécurité deviennent nettement plus critiques lorsque les agents peuvent agir sans approbation humaine.
Un chatbot traditionnel pourrait suggérer : « Vous devriez installer ce paquet. » Un humain décide ensuite s'il convient de le faire.
Un agent de codage autonome pourrait, quant à lui, recevoir un appel d'outil et l'exécuter dans le cadre de son flux de travail.
Cela fait passer le modèle de sécurité de :
Sortie du modèle → Interprétation humaine → Action
à :
Sortie du modèle → Agent → Action
L'intermédiaire devient donc un maillon de la chaîne qui détermine les actions réelles de l'agent.
Les expériences d'empoisonnement menées dans le cadre de cette recherche ont permis d'observer des centaines de sessions d'agents, dont un grand nombre fonctionnant en mode hautement autonome.
C'est pourquoi le problème de l'intermédiaire devient plus crucial à mesure que les agents IA gagnent en capacité.
Plus un agent dispose d'autorité, plus l'intégrité de chaque message qui lui parvient est importante.
Comment les développeurs peuvent-ils se défendre contre les routeurs malveillants ?
Il n'existe pas de mesure unique permettant d'éliminer totalement le risque. L'étude évalue plusieurs défenses côté client, chacune répondant à un aspect différent du problème.
1. Appliquer des politiques avant l'exécution d'outils à haut risque
Une approche consiste à intégrer des contrôles de politique entre la réponse du modèle et l'exécution de l'outil.
Par exemple, un agent pourrait restreindre les outils autorisés à effectuer des opérations sensibles, les destinations auxquelles ils peuvent accéder, ou les catégories d'actions nécessitant une approbation supplémentaire.
Cela crée une autre limite de sécurité :
Réponse du modèle → Vérification de la politique → Exécution de l'outil
De tels contrôles peuvent bloquer des actions suspectes même si une réponse a été modifiée en amont.
La limite est que les règles de politique peuvent devenir difficiles à maintenir, et une modification malveillante n'a pas nécessairement besoin de paraître manifestement malveillante.
2. Inspecter les appels d'outils pour détecter des anomalies
Une autre couche consiste à inspecter les réponses du modèle et les appels d'outils avant leur exécution.
Les destinations inattendues, les arguments inhabituels, les modèles de commande suspects ou les changements par rapport au comportement établi peuvent tous devenir des signaux de détection.
Les chercheurs ont évalué la détection d'anomalies côté réponse et ont rapporté de solides performances de détection sur leurs échantillons d'attaque, bien que les faux positifs restent un défi.
Il s'agit d'une distinction importante :
La détection n'est pas la même chose que la vérification.
Un détecteur d'anomalies peut identifier un comportement qui semble suspect. Il ne peut pas prouver qu'une réponse provient du fournisseur du modèle sans avoir été modifiée.
3. Tenir des journaux détaillés
La journalisation n'empêche pas un intermédiaire malveillant d'agir, mais elle peut considérablement améliorer la détection et la réponse aux incidents.
Les équipes doivent être en mesure de comprendre :
- quel modèle a traité une requête
- quel fournisseur a été sélectionné
- quels outils ont été invoqués
- quelles informations d'identification ou quels services ont été impliqués
- quand un comportement inhabituel a commencé
- comment les requêtes circulent dans l'infrastructure
Pour les systèmes d'agents, l'observabilité doit aller au-delà de la latence et de la consommation de jetons.
Elle doit également permettre de répondre aux questions suivantes : Qu'a reçu l'agent, qu'a-t-il exécuté et d'où provenait cette instruction ?
C'est un point de plus en plus crucial à mesure que l'infrastructure IA devient plus distribuée.
4. Réduire la valeur des identifiants exposés aux agents
Le principe du moindre privilège est particulièrement important pour les systèmes d'IA autonomes.
Un agent ne devrait pas avoir automatiquement accès à tous les identifiants disponibles dans son environnement. Les opérations sensibles doivent utiliser des identifiants à portée limitée, des environnements isolés et, si nécessaire, une approbation supplémentaire.
Cela ne résout pas le problème du routage malveillant, mais limite l'impact potentiel en cas de compromission d'un intermédiaire.
La compromission d'un routeur ne devrait pas se traduire automatiquement par un accès illimité à l'ensemble de l'infrastructure d'une application.
La solution de fond : vérifier l'intégrité des réponses du modèle
Les défenses ci-dessus fonctionnent principalement côté client.
Elles permettent de restreindre, d'inspecter ou d'enregistrer ce que l'agent reçoit.
Mais une question architecturale plus profonde se pose :
L'agent peut-il vérifier que la réponse reçue est bien celle produite par le fournisseur du modèle ?
Aujourd'hui, une architecture simplifiée peut ressembler à ceci :
Fournisseur → Routeur → Agent
Le routeur peut terminer une connexion et en établir une autre. Du point de vue de l'agent, le routeur est donc la source immédiate de la réponse.
Une architecture future plus robuste pourrait offrir une forme de provenance authentifiée des réponses :
Fournisseur → Réponse authentifiée → Routeur → Agent
L'agent pourrait alors vérifier l'intégrité ou l'origine des parties de la réponse sensibles à la sécurité avant de les exécuter.
Cela n'empêcherait pas nécessairement un routeur de voir le trafic. Cela rendrait plutôt toute modification non autorisée détectable.
Pour les agents utilisant des outils, cette distinction pourrait devenir de plus en plus importante.
Ce que cela implique pour le routage LLM
La leçon à tirer de cette recherche n'est pas que les développeurs devraient cesser d'utiliser des routeurs LLM.
Le routage devient un élément essentiel de l'infrastructure IA, car les applications modernes doivent de plus en plus gérer plusieurs fournisseurs, modèles, tarifs, objectifs de latence, solutions de secours et exigences de disponibilité.
La véritable leçon est que la couche de routage doit être traitée comme une infrastructure critique pour la sécurité plutôt que comme un composant réseau invisible.
Lors de l'évaluation d'un routeur LLM, les développeurs devraient poser des questions allant au-delà de :
- Combien de modèles prend-il en charge ?
- Quelle est sa vitesse ?
- Quel est son coût ?
- Propose-t-il des solutions de secours ?
Les questions de sécurité sont également importantes :
- Quelles données le routeur peut-il voir ?
- Où le trafic est-il traité ?
- Comment les identifiants sont-ils gérés ?
- Quels contrôles d'authentification et d'accès sont disponibles ?
- Les requêtes et les réponses peuvent-elles être auditées ?
- Comment les décisions de routage sont-elles enregistrées ?
- Les outils sensibles peuvent-ils nécessiter des contrôles supplémentaires ?
- Que se passe-t-il lorsque plusieurs intermédiaires sont enchaînés ?
- Comment une organisation peut-elle enquêter sur une action inattendue d'un agent ?
Ceci est particulièrement important pour les systèmes où un LLM ne se contente pas de générer du texte, mais contrôle des logiciels, accède à des données ou interagit avec des services externes.
Les passerelles d'IA doivent être intégrées à l'architecture de sécurité
L'évolution des simples API de LLM vers des passerelles et des routeurs d'IA est une conséquence naturelle de la croissance de l'écosystème des modèles.
Une même application peut avoir besoin de travailler avec plusieurs fournisseurs tout en conservant une cohérence en matière d'authentification, de politiques de routage, d'observabilité, de mécanismes de secours et de contrôle des coûts.
Cette centralisation peut être utile du point de vue de la sécurité et de la gouvernance, à condition que la passerelle elle-même soit traitée comme un composant d'infrastructure de confiance et sécurisée en conséquence.
Eden AI aborde ce problème en fournissant une passerelle unifiée pour accéder aux modèles et aux fournisseurs d'IA et les router. Sa couche de routage permet d'abstraire les différences entre les fournisseurs tout en offrant aux équipes un contrôle centralisé sur l'accès aux modèles, le routage, les solutions de secours et l'utilisation. L'avantage architectural global est que ces aspects peuvent être gérés de manière cohérente au lieu d'être implémentés indépendamment dans chaque application.
Mais la recherche souligne un principe important pour l'ensemble de l'industrie :
La centralisation crée des responsabilités.
Plus une passerelle d'IA contrôle d'infrastructure, plus sa sécurité, sa transparence, son isolation et son observabilité deviennent cruciales.
Construire une architecture plus sûre pour les agents d'IA
Une architecture d'agent plus robuste peut donc être conçue comme une superposition de plusieurs couches plutôt que comme une limite de confiance unique
La passerelle gère le routage et les questions d'infrastructure, tandis que l'environnement de l'agent continue d'appliquer le principe du moindre privilège et des contrôles au niveau des outils.
Pour les actions à fort impact, une couche d'approbation ou de politique supplémentaire peut être ajoutée entre la réponse du modèle et l'exécution.
Et sur l'ensemble du système, l'observabilité fournit un historique de ce qui s'est passé.
Cette approche de défense en profondeur reconnaît une réalité importante :
Aucune couche ne devrait être approuvée aveuglément.
La chaîne d'approvisionnement de l'IA ne s'arrête pas au modèle
Le débat sur la sécurité de l'IA s'est logiquement concentré sur le comportement des modèles, les injections de requêtes, l'empoisonnement des données et les vulnérabilités des outils d'agents.
Les recherches sur les intermédiaires malveillants ajoutent une dimension supplémentaire à ce constat.
Le modèle n'est qu'un élément parmi d'autres dans le processus menant d'une instruction à une action.
Entre l'utilisateur et l'exécution finale de l'outil, peuvent intervenir un framework d'agent, une passerelle IA, un ou plusieurs routeurs, des fournisseurs de modèles, des serveurs d'outils, des API externes et d'autres infrastructures.
Chaque intermédiaire capable d'observer ou de modifier la communication devient partie intégrante du périmètre de sécurité.
Cela conduit à un principe simple pour la prochaine génération d'applications d'IA : Faites confiance au modèle, mais vérifiez également le chemin emprunté par sa sortie avant qu'elle n'atteigne un agent autonome.
À mesure que les agents IA gagnent en autonomie pour agir au nom des utilisateurs et des organisations, l'intégrité de ce chemin deviendra tout aussi cruciale que l'intelligence du modèle lui-même.
L'avenir du routage sécurisé en IA ne se résumera donc pas au choix du meilleur modèle ou du fournisseur le plus économique. Il dépendra également de notre capacité à rendre l'infrastructure située entre le modèle et l'agent observable, contrôlée et fiable.