Résumez cet article avec :
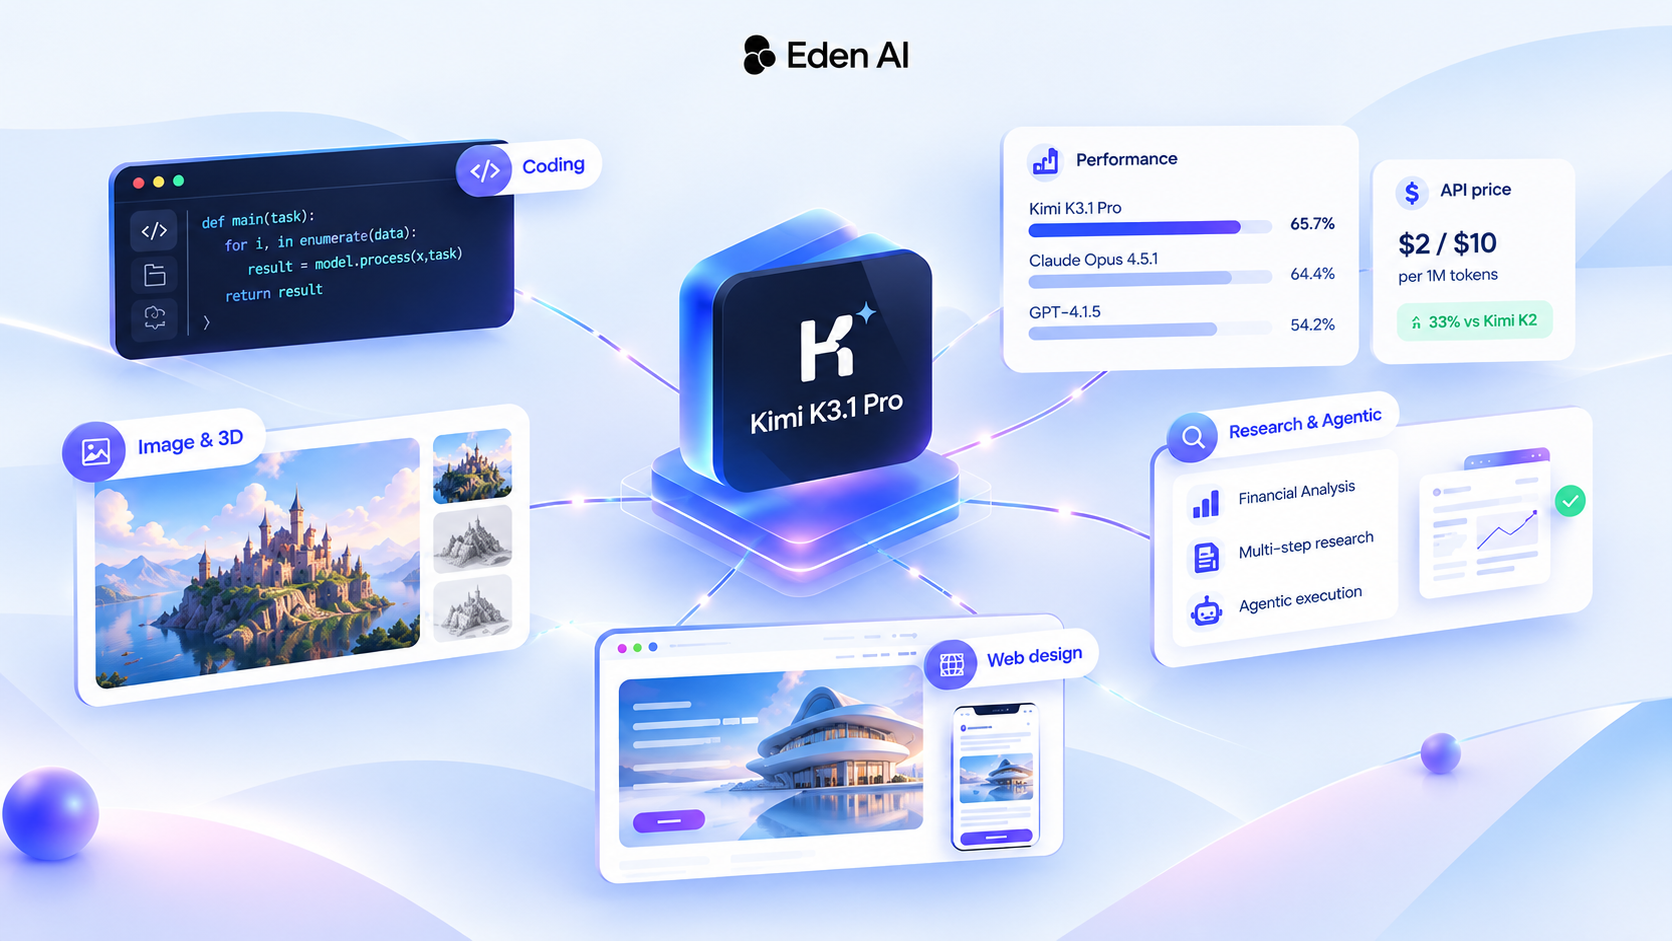
Kimi K3.1 Pro est la version optimisée après entraînement du Kimi K3 par Moonshot AI, dotée d'une fenêtre contextuelle d'un million de jetons, de scores proches de ceux d'Opus sur Terminal-Bench et de tarifs API inférieurs d'un tiers à ceux du K3. Nos tests pratiques et benchmarks indépendants révèlent ses points forts, ses faiblesses et pourquoi le prix au jeton ne reflète pas le coût réel d'une tâche.
Un modèle peut devenir nettement meilleur sans pour autant être le choix idéal pour chaque mission. C'est la question soulevée par Kimi K3.1 Pro, le nouveau fleuron de Moonshot AI, qui s'attaque à des charges de travail de plus en plus exigeantes en matière de codage, de création visuelle et d'agents autonomes.
Lors d'une récente évaluation pratique, la chaîne Arena a soumis Kimi K3.1 Pro à une série de tâches variées : scènes 3D animées, conception de sites web, recherche d'itinéraires de randonnée et tableaux de bord riches en données. Les résultats montrent des progrès substantiels par rapport au Kimi K3, mais aussi des incohérences dans la précision visuelle, l'ergonomie de l'interface et l'organisation des informations.
Le prix rend la situation plus intéressante. Les tarifs de l'API Kimi K3.1 Pro sont inférieurs d'un tiers à ceux du Kimi K3, tandis que les modèles de pointe et les alternatives open-weight moins coûteuses se disputent les mêmes charges de travail. La question pertinente n'est donc pas de savoir si Kimi a rattrapé les leaders, mais dans quels cas sa combinaison de capacités, de fiabilité et de coût en fait le modèle approprié.
Qu'est-ce que Kimi K3.1 Pro et qu'est-ce qui a changé par rapport au Kimi K3 ?
Moonshot AI a présenté Kimi K3.1 Pro le 23 octobre 2026, en tant que premier modèle de sa série K3.1. Il ne s'agit pas d'une nouvelle architecture. Moonshot le décrit comme une version post-entraînée du Kimi K3, conçue avec une puissance de calcul post-entraînement nettement supérieure et un apprentissage par renforcement à grande échelle sur des centaines de domaines. Pour rendre cela possible, l'équipe a retravaillé son framework RL, l'inférence à long contexte, l'infrastructure de bac à sable et les contrôles de qualité de l'environnement.
Le modèle conserve les dimensions du K3, une conception de type « Mixture-of-Experts » et une fenêtre contextuelle allant jusqu'à un million de jetons, adaptée aux bases de code volumineuses, aux longs documents et aux recherches en plusieurs étapes. Une variante « Highspeed » fonctionne deux à trois fois plus vite avec les mêmes capacités, à un prix plus élevé. Les deux sont disponibles dans les applications Kimi, Kimi Code et via la Kimi API sous les noms kimi-k3.1-proetkimi-k3.1-pro-highspeed, avec une option de non-rétention des données disponible pour les clients API.
Moonshot met en avant quatre domaines d'amélioration : le codage, la création 3D, la recherche financière et l'exécution par agents. Son chiffre phare est de 65,7 % sur Terminal-Bench 4.0, contre 66,4 % pour Claude Opus 5.5 et 58,2 % pour GPT-6 Astra. Lors de son test de résistance interne aux hallucinations, le taux d'erreur au niveau des affirmations est passé de 23,4 % pour le K3 à 8,3 %.
Ces gains sont réels, mais un écart réduit sur un seul benchmark d'agent de codage ne prouve pas une performance égale sur l'ensemble du travail de développement. Un modèle peut gérer des tâches plus complexes dans l'ensemble tout en restant incohérent sur des sous-tâches spécifiques, comme l'implémentation d'une interface précise ou la vérification de la validité de sa propre solution. C'est précisément ce que les tests pratiques permettent d'analyser.
Ce que révèlent les tests pratiques
L'évaluation Arena est utile car elle juge des résultats complets plutôt qu'un score unique : la cohérence visuelle, le respect des instructions, l'organisation et l'utilité pratique sont tous pris en compte. Ses démonstrations sont des comparaisons qualitatives et non des mesures contrôlées de la qualité globale du modèle.
Génération 3D et visuelle : plus cohérente, mais pas encore précise
Les tests de scènes 3D montrent l'ampleur de l'amélioration par rapport à Kimi K3. Dans les scènes du dinosaure et de l'ours, K3.1 Pro produit des mouvements plus cohérents et moins de problèmes de rendu visibles. L'exemple de la ville romaine constitue une nouvelle avancée : un environnement de style voxel plus complet au lieu du résultat clairsemé et décousu produit par le modèle précédent.
Amélioration ne signifie toutefois pas constance. L'évaluation révèle toujours des artefacts visuels et des difficultés à reproduire certains styles, notamment l'animation en pâte à modeler. D'autres modèles obtiennent de meilleurs résultats sur certaines tâches, grâce à des détails environnementaux plus riches, une géométrie plus précise ou une animation plus convaincante.
Le test de l'illustration du vase illustre un point similaire. Appliquer un design bidimensionnel sur une surface courbe demande plus qu'un joli dessin : le résultat doit respecter la forme et la perspective de l'objet, et certains modèles concurrents gèrent mieux cette contrainte que Kimi.
Les chiffres de Moonshot racontent la même histoire. Sur BenchCAD, qui teste la reconstruction 3D via du code CAO généré, K3.1 Pro obtient un score de 92,7 % avec des outils, proche mais inférieur à Claude Opus 5.5 (96,2 %) et GPT-6 Astra (95,9 %). Pour une utilisation en production, la question n'est pas de savoir si un modèle peut générer une scène impressionnante, mais avec quelle fiabilité il respecte les contraintes spatiales et stylistiques du brief. Une scène peut sembler convaincante au premier coup d'œil tout en contenant des erreurs structurelles qui ne deviennent visibles qu'après un examen attentif.
Développement web : esthétique ne signifie pas utilisable
Les tests de sites web révèlent une limite différente. Kimi K3.1 Pro produit des mises en page visuellement attrayantes, avec une typographie soignée et une présentation plus organisée que Kimi K3. Mais l'exemple du restaurant de ramen montre comment un design peut paraître abouti tout en plaçant les commandes essentielles trop bas sur la page.
L'exemple du magasin de jouets montre un autre type d'inadéquation avec le prompt : un style visuel sobre et une image de marque orientée vers les adultes ne conviennent pas à un produit destiné aux enfants. Le modèle a produit une interface cohérente sans pour autant capturer le public cible ou la personnalité de la marque.
Le tableau de bord de course est plus encourageant. Les informations sur le pilote sont plus claires que dans la mise en page encombrée de Kimi K3, bien qu'une grande partie de l'en-tête soit utilisée de manière inefficace.
La génération front-end regroupe plusieurs tâches distinctes : écrire du code fonctionnel, comprendre l'intention, organiser l'information et rendre l'interface facile à utiliser. Un résultat solide nécessite ces quatre éléments, et pas seulement une page esthétique.
Recherche et visualisation de données : la structure fait partie de la réponse
Les tâches axées sur la recherche montrent pourquoi ces modèles sont utiles au-delà de la simple réponse aux questions. Dans l'exemple du sentier alpin, Kimi K3.1 Pro organise les informations sur l'itinéraire autour d'une carte centrale avec des détails complémentaires. La visualisation du centre de données mondial rassemble également les informations et les présente sous une forme plus structurée que son prédécesseur.
Les modèles concurrents produisent cependant des mises en page comparables ou plus épurées pour des coûts de tâche estimés inférieurs. De plus, récupérer des informations, les organiser et les représenter avec précision sont trois défis distincts : une carte bien organisée peut toujours contenir des données incomplètes, obsolètes ou mal interprétées. Pour les rapports, les tableaux de bord et les pages de recherche, l'évaluation doit porter sur les faits sous-jacents autant que sur la présentation.
Dans ces trois domaines, les trois mêmes questions permettent de distinguer une démo impressionnante d'un résultat prêt pour la production :
Comment Kimi K3.1 Pro se compare-t-il à Claude, GPT et aux rivaux open-weight ?
Les exemples de l'Arena montrent un modèle plus performant et plus cohérent visuellement que Kimi K3, mais ils n'établissent pas de classement universel. La situation devient plus claire lorsque les démos sont lues parallèlement aux résultats des benchmarks et aux évaluations indépendantes.
La comparaison de Moonshot est mitigée. K3.1 Pro est en tête sur l'ingénierie logicielle à long terme (SWE-Marathon) et affiche un score de pointe de 64,4 sur OfficeQA Pro v2, un benchmark de documents financiers. Il se situe juste derrière Opus 5.5 sur Terminal-Bench 4.0 et est nettement distancé sur Terminal-Bench Science. Il s'agit de résultats publiés par le fournisseur, et plusieurs scores de concurrents proviennent d'autres rapports et du classement officiel Terminal-Bench, ils ne doivent donc pas être interprétés comme une expérience comparative unique.
Les tests indépendants tirent dans des directions opposées. Artificial Analysis a obtenu un score de 67 % sur Terminal-Bench 4.0, soit légèrement au-dessus du chiffre annoncé par Moonshot, et classe K3.1 Pro quatrième sur 215 modèles dans son Intelligence Index, comme le rapporte R&D World. L'évaluation du codage par agents de Bito, qui soumet chaque modèle aux mêmes tâches réelles et aux mêmes corrigés, est moins flatteuse : 72 % au global pour Kimi K3.1 Pro, contre 75 % pour Claude Sonnet 5.5 et 87 % pour Claude Opus 5.5. L'écart s'est creusé au fil des sessions. Kimi a égalé Sonnet lors du traçage de code et de l'analyse des échecs, puis a pris du retard lors de la planification, de l'implémentation et de l'audit des correctifs. Dans ce même benchmark, il a obtenu exactement le même score que Kimi K3.
Aucun de ces résultats ne permet de trancher pour tous les cas d'usage. Ensemble, ils démontrent pourquoi une poignée de scores ne peut prédire le comportement d'un modèle sur votre travail, une lacune que nous avons explorée dans ce que signifie réellement « prendre en charge » en production. La comparaison pratique consiste moins à trouver un modèle gagnant sur tous les tableaux qu'à savoir où les forces de chaque modèle sont pertinentes.
Tarification de Kimi K3.1 Pro : prix au jeton vs coût d'un résultat final
Les tarifs API standard de Kimi K3.1 Pro sont de 2 $ par million de jetons en entrée et 10 $ par million de jetons en sortie, avec des entrées en cache à 0,20 $. Kimi K3 coûte 3 $ et 15 $. Il s'agit d'une réduction d'un tiers sur l'entrée comme sur la sortie, ce qui rend le nouveau modèle intéressant à tester pour toute équipe utilisant déjà Kimi, avant même de prendre en compte les gains de capacité. Consultez la plateforme API Kimi pour connaître les tarifs actuels, car les prix et les conditions de facturation peuvent évoluer.
Il s'agit de prix par jeton, et non par site web, animation ou tableau de bord de recherche. Une tâche complexe peut impliquer des appels répétés au modèle, l'exécution d'outils, des recherches web, ainsi que la génération et la correction de code. Un modèle avec un prix au jeton plus bas peut s'avérer plus coûteux s'il nécessite des itérations supplémentaires, écrit davantage de jetons de raisonnement ou produit un résultat nécessitant une intervention manuelle.
L'évaluation de Bito rend cela concret. Kimi K3.1 Pro affiche le même prix catalogue par jeton que Claude Sonnet 5.5, pourtant ses longues sessions de codage coûtent plus de trois fois plus cher et ont pris quatre fois plus de temps. La raison est le volume : Kimi a généré environ 98 000 jetons de sortie par longue session, dont la majeure partie était consacrée au raisonnement.
La même prudence s'applique à la vidéo de l'Arena : ses coûts estimés par artefact généré proviennent de tâches et de configurations particulières, et non de prix standardisés applicables à chaque utilisateur.
Une comparaison équitable mesure deux choses conjointement : la qualité du résultat final et les ressources totales nécessaires pour atteindre un résultat acceptable. Pour une tâche de génération simple, le prix au jeton est un point de départ raisonnable. Pour un agent à exécution longue, les tentatives répétées, le temps d'exécution et la révision humaine comptent tout autant, et une étape de vérification peut même permettre à un modèle moins coûteux de prendre en charge une plus grande partie du travail, comme nous l'avons montré dans comment un projet de 600 milliards de jetons a permis d'utiliser des modèles moins chers.
Devriez-vous utiliser Kimi K3.1 Pro en production ?
Pour les développeurs et les équipes produit, Kimi K3.1 Pro est un candidat à évaluer pour une charge de travail spécifique, et non un remplacement par défaut des modèles déjà en service.
Les exigences varient selon le cas d'utilisation. Une équipe développant une expérience 3D interactive privilégiera la géométrie, l'animation et la cohérence visuelle. Une équipe générant des sites web se souciera davantage de la justesse fonctionnelle, de l'accessibilité et de l'emplacement des commandes essentielles. Une application de recherche nécessite des informations précises et sourcées, des données complètes et une organisation visuelle claire. Chacun de ces cas appelle des critères d'évaluation différents, ce qui fait du choix du modèle une décision d'ingénierie continue : comparez les résultats, mesurez l'accomplissement des tâches, suivez les coûts et réévaluez votre choix à mesure que les modèles et les tarifs évoluent.
C'est là que le routage multi-modèle intervient. Au lieu d'envoyer chaque requête vers un seul modèle, une application peut sélectionner un modèle en fonction du type de tâche, du budget, de la latence et de la qualité attendue. Kimi K3.1 Pro pourrait gérer l'analyse financière à long contexte, un modèle plus rapide les étapes de codage interactif, et un modèle de pointe les revues critiques. Ces décisions doivent reposer sur des performances mesurées sur votre propre charge de travail, et non sur un classement général. Notre guide sur les stratégies de routage LLM pour le coût, la vitesse et la qualitécouvre les principales approches.
Eden AI regroupe les modèles de nombreux fournisseurs derrière une API compatible OpenAI ; ainsi, tester une nouvelle version revient à modifier une chaîne de modèle plutôt qu'à réécrire une intégration. Le routage par fournisseur sélectionne le fournisseur le moins cher, le plus rapide ou celui offrant la latence la plus faible pour un modèle, les solutions de secours maintiennent les requêtes actives en cas de défaillance d'un fournisseur ou d'un modèle, et les politiques de routage vous permettent de définir quels modèles tester pour un type de requête donné. Chaque réponse indique également son coût, ce qui permet de comparer les modèles sur le coût total par tâche plutôt que sur le seul prix des jetons. Kimi K3 est déjà disponible sur Eden AI via plusieurs fournisseurs, et les mêmes modèles d'intégration agnostiques aux fournisseurs s'appliquent à chaque nouvelle version de Kimi.
Verdict : un concurrent sérieux, pas un choix automatique par défaut
Kimi K3.1 Pro représente une avancée significative pour Moonshot AI. Les tests de l'Arena montrent une meilleure cohérence visuelle, une organisation de l'interface et des résultats de recherche améliorés ; les benchmarks des fournisseurs et indépendants confirment un codage agentique plus performant ; et des prix d'API inférieurs d'un tiers à ceux de Kimi K3 rendent cette mise à niveau commercialement intéressante.
Les preuves ne sont toutefois pas uniformes. Certaines tâches visuelles restent incohérentes, les interfaces soignées peuvent encore présenter des lacunes en matière d'utilisabilité, les tests de codage indépendants le placent derrière Claude Sonnet 5.5 et Opus 5.5, et un prix par jeton plus bas ne garantit pas un coût inférieur par tâche accomplie.
Kimi K3.1 Pro mérite d'être pris en considération par les équipes qui développent des agents de codage, des flux de travail de recherche et financiers, ainsi que des applications 3D créatives. Son intégration en production dépendra de ses performances par rapport aux alternatives sur les tâches qui comptent le plus pour vous.
La leçon à retenir va au-delà de Kimi : le meilleur modèle n'est pas celui qui affiche le score le plus élevé aux tests de référence ou le prix par jeton le plus bas. C'est celui qui offre la qualité requise, de manière fiable, à un coût soutenable pour votre application.
FAQ
Pour aller plus loin
Sources originales
- Présentation de Kimi K3.1 Pro, le blog technique de Moonshot AI, avec le tableau complet des benchmarks, les notes d'évaluation et la méthodologie de suppression des données de cybersécurité.
- Kimi K3.1 Pro vs Claude Opus 5.5 vs Sonnet 5.5 pour le codage, l'évaluation indépendante étape par étape de Bito, incluant le coût et le temps par session.
- Meilleur modèle à poids ouverts pour le codage, la comparaison par Bito de Kimi K3.1 Pro, GLM 5.3 et DeepSeek V4.1 Flash.
- Classement Terminal-Bench, la référence publique pour le benchmark de codage agentique à l'origine du score phare de Kimi.
- Analyse de VentureBeat sur cette sortie, incluant les résultats indépendants d'Artificial Analysis et le débat autour de la promotion du lancement.
Sur le blog d'Eden AI
- Les meilleurs LLM à poids ouverts en octobre 2026
- Intégrer Kimi K3 à votre stack LLM : modèles d'intégration agnostiques aux fournisseurs
- Les meilleurs routeurs LLM en 2026 : comparatif par coût, latence et fonctionnalités
- Google Gemini 4 Argon : Coûts et benchmarks de performance pour les systèmes d'IA en production
- L'appel d'IA le plus écologique est celui que vous n'avez pas surdimensionné
Dans la documentation d'Eden AI