Résumez cet article avec :
Jev de TypeSafe AI est le premier modèle de « Système 1 » : au lieu de générer du texte jeton par jeton, il prend en compte l'état du programme et des questions typées pour renvoyer des décisions structurées avec des probabilités calibrées en un seul passage parallèle. Ce guide explique les changements architecturaux induits, puis vous accompagne dans la création d'un routeur opérationnel où Jev classifie chaque requête entrante et Eden AI l'exécute via le modèle approprié. Il aborde les types de questions Choice, Score et Noul, les seuils de confiance et les chemins de repli, propose un routeur Python complet et prêt à l'emploi, et offre une analyse honnête sur les cas où un modèle de décision surpasse un classifieur affiné, et ceux où ce n'est pas le cas.
Les grands modèles de langage sont devenus remarquablement performants pour comprendre des instructions, écrire du code et résoudre des problèmes complexes. Pourtant, une grande partie du travail au sein d'une application d'IA en production ne consiste pas à générer du contenu, mais à prendre des décisions.
À quelle catégorie appartient cette requête ? Quel outil l'agent doit-il appeler ensuite ? Faut-il privilégier un modèle rapide ou un modèle de raisonnement ? Ce document récupéré est-il pertinent ? Ce résultat doit-il être auto-approuvé ou envoyé pour révision ?
Ces décisions sont souvent minimes comparées à la génération d'une réponse complète. Pourtant, les LLM traditionnels sont fréquemment utilisés pour les prendre, obligeant le modèle à générer des jetons alors que le logiciel n'a besoin, en fin de compte, que d'une étiquette, d'un score ou d'une décision booléenne.
Jev, le premier modèle de « Système 1 » public de TypeSafe AI, adopte une approche différente. Au lieu de générer des chaînes de caractères destinées à être interprétées par des humains, Jev est conçu pour renvoyer des décisions structurées et probabilistes que les logiciels peuvent exploiter directement.
Le résultat est un modèle ciblant une couche différente de la pile technologique IA : non pas le modèle qui rédige la réponse finale, mais l'intelligence qui décide de la suite des opérations.
Qu'est-ce que Jev ?
TypeSafe AI a lancé Jev le 15 septembre 2026, parallèlement à une levée de fonds de 40 millions de dollars menée par DCVC. L'entreprise a été fondée par Diogo Almeida, co-inventeur du RLHF et d'InstructGPT chez OpenAI.
Jev est un modèle de décision à entrée textuelle : il évalue un bloc d'état par rapport à un ensemble de questions typées et renvoie une réponse structurée pour chacune d'elles, accompagnée d'une distribution de probabilité et d'un indice de confiance, le tout en un seul appel API. Il ne génère aucun texte. L'espace de réponse pour chaque question est énuméré dans la requête ; la réponse est donc une valeur issue d'un ensemble que vous avez défini, et non une chaîne de caractères à analyser.
Deux remarques pratiques avant de planifier votre intégration. Jev est propriétaire et fourni via l'API hébergée de TypeSafe, actuellement accessible sur liste d'attente — il n'existe aucun poids publié ni aucune option sur site à ce jour. Et bien qu'il ne puisse pas émettre de valeur en dehors de l'espace de réponse défini, ce qui élimine les erreurs de schéma et d'analyse, il peut tout de même se tromper avec assurance.
Le problème : nous demandons constamment aux LLM de tout faire
L'architecture dominante des applications d'IA modernes est simple : un utilisateur envoie une requête, un LLM la lit, le LLM génère une réponse. Cela fonctionne extrêmement bien lorsque le résultat attendu est du langage.
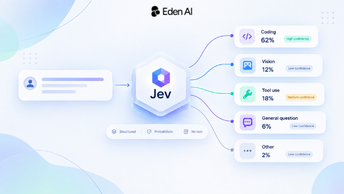
Mais imaginez une application recevant des milliers de requêtes par minute. Avant d'appeler un modèle de pointe coûteux, elle doit savoir s'il s'agit d'une demande de code, si elle nécessite une analyse visuelle, s'il s'agit d'une question simple ou d'une tâche de raisonnement complexe, et si elle doit être traitée automatiquement ou escaladée. L'application a finalement besoin d'une seule valeur :
Un LLM conventionnel parvient toujours à cette valeur par la génération de texte autorégressive — en générant des jetons séquentiellement, en les payant, en attendant leur production, puis en analysant le résultat pour le structurer. Jev part de l'autre extrémité. Au lieu de demander « Que dois-je écrire ? », le modèle est structuré autour de « Quelle décision dois-je prendre ? »
Des chaînes de caractères aux décisions
TypeSafe appelle cette famille Modèles de Système 1. Ce nom fait référence à la distinction établie par Daniel Kahneman entre la pensée rapide et intuitive du Système 1 et le raisonnement lent et délibéré du Système 2. Le compromis est explicite : renoncer à la génération de texte libre au profit d'un échantillonnage parallèle, d'une conformité garantie au schéma et d'une probabilité associée à chaque réponse.
L'idée centrale : des décisions, pas des chaînes de caractères.
Un LLM classique pourrait renvoyer « Cela ressemble à une demande de support technique liée à l'authentification. Il serait probablement préférable de la traiter par… », et votre application doit ensuite interpréter ce texte. Avec Jev, vous déclarez l'espace de décision avant l'inférence : le modèle y puise ses choix et y associe des probabilités. Il n'est plus question de demander à un modèle de produire du JSON en espérant qu'il respecte votre schéma.
La seconde architecture est beaucoup plus proche du fonctionnement des logiciels traditionnels.
Trois primitives : Choix, Score et Noul
Jev propose un ensemble restreint de types de questions que vous pouvez combiner pour créer des systèmes de décision plus complexes. Chaque requête comporte un modèle, un état (une chaîne, un objet ou un tableau), et une liste non vide de questions objet. Chaque question nécessite un type et des instructions.
La précision des limites est essentielle lors de la conception d'un schéma. Le type Choice accepte de 1 à 255 catégories ; Score utilise un tableau ordonné de 2 à 10 niveaux ; Noul ne requiert aucun critère. Vous pouvez envoyer plusieurs questions en une seule requête, et les réponses sont renvoyées sous les mêmes clés que celles utilisées pour les questions.
Pourquoi les probabilités sont importantes
Jev ne se contente pas de fournir une réponse, il transmet également des informations sur son propre degré d'incertitude. TypeSafe qualifie cette approche d'apprentissage par renforcement pour décisions calibrées (RLCD), et elle optimise la fiabilité des probabilités plutôt que la préférence humaine, contrairement au RLHF.
Comparez une décision de routage qui ressemble à ceci :
à une autre qui ressemble à cela :
Les deux ont un gagnant. Une seule d'entre elles devrait être automatisée.
Une mise en garde que TypeSafe souligne dans sa propre documentation et qu'il convient de répéter : une probabilité n'est pas une garantie d'exactitude. Les probabilités indiquées peuvent être arrondies et ne pas totaliser exactement un, une étiquette rapportée peut différer d'un calcul basé sur les estimations, et les probabilités ainsi que le niveau de confiance ne constituent ni des garanties de précision démontrées ni une autorisation d'agir. Calibrez vos seuils en fonction de votre propre trafic étiqueté.
Pourquoi Jev est si rapide
Les modèles autorégressifs traditionnels produisent des résultats de manière séquentielle. Chaque jeton dépend du précédent.
Cela est logique lorsque l'objectif est de générer un texte de longueur arbitraire. C'est moins évident lorsque la réponse est technique ou 0,82.
Jev n'est pas autorégressif : il ingère un état, évalue chaque question par rapport à celui-ci en parallèle et renvoie toutes les réponses en un seul passage, en 70 à 500 millisecondes. Les chiffres publiés sont frappants : la comparaison effectuée par TypeSafe montre que Jev accomplit une tâche de Système 1 en 0,114 seconde contre 8,566 secondes pour un LLM de pointe, pour un coût de 0,000081 $ contre 0,013880 $, ce qui représente, selon eux, une exécution 193,6 fois plus rapide et 444,6 fois moins chère. La tarification est de 0,042 $ par million de jetons en entrée, les sorties étant facturées à zéro.
Considérez ces chiffres comme des benchmarks fournis par le vendeur sur des flux de travail sélectionnés par lui. L'idée durable n'est pas le multiplicateur, c'est que une décision ne nécessite pas qu'un modèle génératif se comporte comme un chatbot.
« Pourquoi ne pas simplement utiliser un classifieur ? »
C'est la question qu'un ingénieur expérimenté pose avant celle du routage, et elle mérite une réponse directe. La classification de texte est un problème résolu. BERT affiné, embeddings combinés à une régression logistique, et petits modèles avec modes de sortie structurés classent tous efficacement pour un coût quasi nul.
En quoi un modèle de Système 1 diffère :
- Aucune donnée d'entraînement et aucun cycle d'entraînement. Un classifieur affiné nécessite un jeu de données étiqueté par tâche. Jev utilise un schéma écrit dans la requête, vous permettant ainsi de déployer une nouvelle décision dans le temps qu'il faut pour rédiger un dictionnaire.
- Les changements de schéma sont gratuits. Ajouter une cinquième catégorie de routage à un classifieur affiné implique un réétiquetage et un réentraînement. Ici, vous ajoutez simplement une clé aux
critères. - La grille d'évaluation accompagne l'appel. L'état et les questions sont envoyés ensemble à chaque requête, il n'y a donc aucune étape distincte d'enregistrement de la grille.
- Le calibrage est l'objectif d'entraînement, et non une réflexion après coup que l'on corrige avec une mise à l'échelle de la température.
- Une sémantique de niveau « frontier ». Un petit classifieur peine face à des requêtes nécessitant une connaissance du monde ou une intention subtile. C'est précisément là que les décisions de routage deviennent complexes.
Le contrepoint honnête : si vous avez une tâche de classification stable, à haut volume, étroite et que vous disposez de nombreuses données étiquetées, un petit modèle affiné sera probablement moins cher et tout aussi précis. Les modèles de Système 1 justifient leur utilité lorsque l'espace de décision change fréquemment, lorsqu'il n'y a pas de données étiquetées, ou lorsque le jugement nécessite une réelle compréhension sémantique.
Jev n'est pas un chatbot miniature
Il est tentant de se demander s'il s'agit simplement d'un petit LLM, mais cela passe à côté de l'essentiel sur le plan architectural : le modèle est optimisé pour une interface différente. Un LLM généraliste est conçu pour générer des chaînes de caractères ; Jev est conçu pour répondre à des questions prédéfinies sur un état et renvoyer des décisions typées.
Ce compromis est délibéré. Jev n'est pas le modèle que vous solliciteriez pour rédiger un article de blog, fournir une longue explication, créer une application, faire du brainstorming ou écrire un e-mail. Il est destiné aux décisions prises au sein des logiciels — classification, routage, notation, extraction — plutôt qu'à la conversation. Cela le rend complémentaire plutôt que concurrent.
Créer un routeur personnalisé avec Jev + Eden AI
Le routage de modèles est l'application la plus évidente. Une application moderne peut utiliser un modèle rapide pour les requêtes simples, un modèle de codage pour les tâches de programmation, un modèle de raisonnement pour les problèmes complexes, un modèle multimodal pour les images et un modèle économique pour la classification en masse. Le défi consiste à décider quel modèle reçoit chaque requête.
L'approche intéressante consiste à séparer l'intelligence de routage de l'exécution du modèle — et vous pouvez effectuer les deux via Eden AI avec une seule clé API. Eden AI propose Jev via un point de terminaison dédié aux décisions, et nomme ce point de terminaison en fonction de sa capacité plutôt que du fournisseur, de sorte qu'un second fournisseur de modèles de décision puisse utiliser le même chemin.
Une remarque importante avant de commencer à construire. Le point de terminaison des décisions est en alpha: ses structures de requête et de réponse, les identifiants de modèles qu'il expose et sa tarification peuvent changer sans préavis, ce qui pourrait rompre les intégrations existantes. Eden AI conseille de placer l'appel derrière un petit adaptateur de votre conception, afin qu'un changement de structure ne nécessite qu'une seule modification au lieu de plusieurs.
Étape 1 : Définir les catégories de routage
Supposons que nous construisions un assistant généraliste avec quatre catégories, chacune associée à un modèle disponible via Eden AI :
Vérifiez vos identifiants dans le catalogue avant la mise en production — Eden AI utilise partout le format fournisseur/modèle dans la V3, et la liste évolue au gré des sorties des fournisseurs. Vous pouvez découvrir les modèles de décision de la même manière :
jev-latest est le modèle stable actuel et jev-preview est la version la plus récente, stable ou non. Les deux renvoient à une version concrète, que la réponse indique dans son champ model. Fixez cette version concrète une fois que vous avez ajusté vos seuils en fonction de celle-ci.
La logique de routage n'a pas besoin de connaître l'implémentation de ces modèles. Elle a seulement besoin de la correspondance catégorie → modèle.
Étape 2 : Demander à Jev de classifier le prompt
Le prompt de l'utilisateur devient le state. Les catégories deviennent une question à choix dont les critères associent chaque nom d'option à une description de son cas d'application. Décrivez vos critères plutôt que de simplement les nommer : une clé d'option brute fonctionne, mais une phrase expliquant quand l'utiliser est préférable, et une description structurée l'est encore plus.state. Les catégories deviennent une choice question avec un criteria objet — chaque nom d'option est associé à une courte description qui indique à Jev ce qu'il doit contenir.
Notez que state n'a pas besoin d'être une chaîne de caractères. Passez un objet ou un tableau lorsque la structure elle-même est porteuse de sens et que le modèle doit l'interpréter — c'est utile si votre routage repose sur d'autres éléments que le prompt brut (plan utilisateur, longueur de la conversation, types de pièces jointes).
La réponse encapsule le tout sous answers, indexé par les noms que vous avez choisis, et indique la version concrète du modèle ainsi que le coût exact de l'appel :
Extraire la décision se fait en deux lignes :
Remarquez ce qui ne s'est pas produit. Jev n'a généré aucune explication, n'a produit aucune réponse finale et n'a appelé aucun LLM. Il a pris exactement la décision demandée par l'application — et vous a indiqué son coût.
Étape 3 : Envoyer le prompt à Eden AI
Une fois le modèle sélectionné, le prompt original est envoyé au point de terminaison de complétion de chat compatible OpenAI d'Eden AI. Même clé, chemin différent :
Une précision importante : le point de terminaison des décisions ne se résume pas à un simple changement d'URL de base par rapport aux complétions de chat. La documentation d'Eden AI est explicite : vous devez diriger votre client vers /v3/alpha/decisions directement plutôt que de remplacer l'URL de base. Les corps de requête et de réponse correspondent à ceux de TypeSafe, mais pas le chemin. Ainsi, l'appel de décision reste sur les requêtes, tandis que l'appel de génération utilise le SDK OpenAI.
Deux responsabilités bien distinctes :
Étape 4 : Ajouter un routage basé sur la confiance
Le routeur devient réellement utile lorsque vous utilisez la distribution plutôt que le simple gagnant. Une réponse de choix comporte son propre niveau de confiance ainsi que la distribution de probabilité complète, il n'y a donc rien à calculer. Supposons que Jev renvoie :
Choisir automatiquement le codage est une approche audacieuse ; le modèle vous indique qu'il ne parvient pas à distinguer deux catégories. Utilisez la confiance comme signal de routage et envoyez les décisions à faible confiance à un humain ou à un modèle plus puissant plutôt que de considérer chaque réponse comme définitive :
0,80 n'est pas une valeur universelle. Enregistrez vos décisions de routage ainsi que leurs résultats pendant une semaine, puis choisissez un seuil en fonction du coût réel d'une erreur de routage, et notez la version du modèle utilisée pour le réglage, car la réponse indique la version précise dont elle provient.
Une asymétrie à garder à l'esprit : une réponse « noul » ne possède pas de champ de confiance, car le nombre constitue à la fois la réponse et sa propre mesure de confiance. Utilisez l'écart de sa probabilité par rapport à 0,5 :
Étape 5 : Aller au-delà des catégories
Une seule requête peut contenir autant de questions que vous le souhaitez, traitées simultanément sur le même état. Poser trois questions ne coûte guère plus cher qu'en poser une seule, car l'état n'est lu qu'une fois. Alors, n'hésitez pas à en poser plusieurs :
Les critères de score doivent être classés du plus bas au plus élevé, car l'index est le score. La valeur renvoyée est la moyenne pondérée par la probabilité, elle peut donc se situer entre deux niveaux, et une légende vous renvoie votre grille d'évaluation afin que vous puissiez interpréter le chiffre :
Un 2.4 se situe entre «strict» et «niveau recherche». Votre politique peut ensuite combiner les signaux — notez qu'une valeur nulle est renvoyée sous la clé noul, et non probability:
Formulez vos questions de manière positive autant que possible. Un modèle de décision lit les instructions au pied de la lettre, et les négations ainsi que les implications sont sources d'erreurs : « Cela nécessite-t-il du code ? » est mieux routé que « N'est-ce pas une tâche de codage ? ».
C'est là que Jev commence à ressembler moins à un remplaçant pour un LLM qu'à une couche d'intelligence programmable.
Le routeur complet
Tout ce qui est spécifique à Jev se trouve dans pick_model, donc un changement de forme alpha ne nécessite qu'une seule modification :
Trois notes de conception à garder à l'esprit. Si la couche de décision échoue, le routeur revient à une valeur par défaut performante plutôt que de générer une erreur ; un routeur capable de faire tomber toute votre application est pire que l'absence de router. MODEL_BY_CATEGORY.get(...) avec une solution de repli signifie qu'une catégorie ajoutée ultérieurement à CRITÈRES mais oubliée dans la carte se dégrade au lieu de provoquer une erreur. Et comme vous ne payez que pour les entrées, récupérez les données avant de juger : envoyez la partie pertinente de l'état, pas l'intégralité de votre base de documents.
En termes de coût, la décision est quasi gratuite par rapport à la génération qu'elle protège. Les modèles de décision sont facturés uniquement sur les entrées, avec des sorties gratuites, à 0,042 $ par million de jetons en entrée ; l'exemple concret d'Eden AI facture 430 jetons en entrée et 73 jetons en sortie à 0,00001806 $. Chaque réponse comporte un coût en USD, afin que vous puissiez enregistrer précisément ce que vous coûte la couche de routage et le comparer à ce que coûtaient les erreurs de routage auparavant.
Pourquoi placer le routeur en dehors du LLM ?
Vous pourriez simplement demander à un LLM quel modèle utiliser, et pour de nombreuses applications, cela suffit. Mais si le routeur est lui-même un modèle génératif, l'étape de routage ajoute un appel d'inférence générative supplémentaire ; latence accrue, jetons supplémentaires, surcharge d'analyse, formats de sortie variables et une sortie de plus à valider.
Au lieu de :
Prompt → LLM génératif → Texte expliquant le routage → Analyseur → Sélection du modèle
vous pouvez avoir :
Prompt → Jev → Décision typée → Sélection du modèle
Aucune architecture n'est universellement meilleure. L'essentiel est que le travail du routeur est fondamentalement différent de celui du générateur, et Jev est explicitement conçu autour de cette distinction.
Au-delà du routage de modèles
Une fois que les décisions structurées deviennent peu coûteuses, elles deviennent une primitive que vous pouvez utiliser partout. Les exemples de TypeSafe incluent le choix du prochain outil ou sous-agent dans une boucle d'agent, la décision de continuer, de réessayer, de demander à l'utilisateur ou d'arrêter, l'évaluation de l'urgence ou du risque avant une action, et la vérification des sorties du modèle pour appliquer des garde-fous.
Routage d'agent. Un agent utilise Jev pour choisir quel outil ou flux de travail exécuter ensuite, sans consommer un appel de génération à chaque étape.
Accélération RAG. Avant une étape coûteuse de récupération ou de génération, déterminez si les segments récupérés sont pertinents, si une nouvelle recherche est nécessaire ou quel index interroger.
Classification à haut volume. Tri d'e-mails, classement de documents, files d'attente de modération, où le résultat est simplement ventes, support, facturation, spam.
Examen automatisé. Utilisez le niveau de confiance comme filtre avant de solliciter un modèle plus puissant ou un examinateur humain. Particulièrement utile lorsqu'une décision automatisée erronée coûte bien plus cher qu'une escalade.
Boucles en temps réel. Les systèmes interactifs, les jeux et les boucles d'agents nécessitent de nombreuses petites décisions sans avoir à attendre une réponse générative lourde à chaque fois.
La place de Jev dans une pile technologique IA moderne
L'architecture distingue deux questions : que doit-il se passer ? et quel modèle choisir ? Jev gère le premier. Eden AI fournit l'infrastructure pour le second.
Le compromis
Un LLM généraliste peut presque tout produire. Jev, par conception, ne le peut pas : son espace de sortie est défini avant l'inférence. C'est une limite si vous avez besoin d'une génération libre, mais un atout lorsque vous savez exactement quelles décisions vous attendez.
Trois points importants à préciser avant de concevoir votre architecture :
La précision est bonne, sans être surhumaine. Sur le benchmark interne de quatre workflows de TypeSafe, Jev atteint environ 68 % de précision, soit un niveau proche des LLM de milieu de gamme, mais pour un coût et une latence bien moindres. L'avantage réside dans l'économie et la rapidité, pas dans la puissance brute.
La sécurité de typage n'est pas la justesse. Jev ne peut pas émettre de valeur en dehors de l'espace de réponse défini, ce qui élimine les erreurs de schéma et d'analyse, mais il peut tout de même se tromper avec assurance.
Le point de terminaison est en version alpha. Eden AI héberge Jev actuellement, il n'y a donc pas de liste d'attente ; cependant, le point de terminaison des décisions est explicitement marqué comme alpha : la structure des requêtes et des réponses, les identifiants de modèles exposés et la tarification peuvent changer de manière significative sans période de préavis. Il est sûr pour l'expérimentation, mais risqué pour une mise en production critique. Gardez l'appel derrière un petit adaptateur, comme le fait le routeur ci-dessus, afin qu'un changement de structure ne nécessite qu'une seule modification. Notez également que Jev reste propriétaire : aucun poids publié, aucune option d'auto-hébergement ou sur site. Si vous avez besoin de garanties sur la résidence des données, ce n'est pas encore l'outil qu'il vous faut.
La bonne approche n'est pas LLM contre Jev. C'est LLM et modèles de décision.
En résumé
L'industrie a passé des années à améliorer la génération de langage par les modèles. Jev pose une question différente : et si les modèles étaient conçus dès le départ pour prendre des décisions directement exploitables par les logiciels ?
La réponse est un modèle articulé autour de sorties typées, de probabilités calibrées et d'évaluations parallèles plutôt que de texte libre. Cela ne rend pas les LLM génératifs obsolètes, mais suggère une architecture plus modulaire, où un modèle génératif rédige la réponse, un modèle de décision choisit quel modèle doit la rédiger, et une passerelle comme Eden AI fournit la couche de modèles sous-jacente.
Le résultat n'est pas un modèle unique qui fait tout. C'est un logiciel où différents types d'intelligence deviennent des primitives composables.
Prêt à construire la couche d'exécution ? Créez un compte Eden AI gratuit et obtenez une clé API unique pour accéder à plus de 500 modèles provenant de plus de 50 fournisseurs, ou consultez la documentation de l'API V3 pour lancer votre première complétion de chat en moins d'une minute.