Résumez cet article avec :
Une utilisation inhabituelle de l'API LLM peut signaler une compromission d'identifiants, mais un pic de trafic ne suffit pas à expliquer ce qui s'est passé. Une attribution fiable nécessite de relier les identifiants à leurs charges de travail attendues et d'analyser les variations des taux de requête, de l'utilisation des modèles, de la consommation de jetons, du timing, des régions et des réseaux. En combinant ces signaux avec une visibilité centralisée sur le trafic IA, les équipes peuvent identifier les incohérences comportementales, enquêter sur les activités suspectes et limiter l'impact des identifiants compromis.
Une augmentation soudaine de l'utilisation de l'IA est facile à remarquer. Comprendre pourquoi elle s'est produite est beaucoup plus difficile.
Cette distinction est cruciale à mesure que les applications d'IA passent d'appels API occasionnels à des agents permanents, des processus en arrière-plan, des assistants de codage, des flux de travail automatisés et des services de production. Un identifiant autrefois utilisé par un développeur pour quelques requêtes par jour peut désormais être à l'origine de centaines d'appels automatisés par heure.
Si cet identifiant est exposé, un simple tableau de bord d'utilisation peut vous indiquer que la consommation a augmenté. Il ne vous dira peut-être pas quelle charge de travail en est responsable, si l'activité était légitime ou si l'identifiant est utilisé là où il n'aurait jamais dû l'être.
C'est toute la différence entre la détection et l'attribution.
En septembre 2026, un abonné à Claude Max a signalé que sa consommation de jetons continuait d'augmenter alors qu'il ne travaillait pas activement. Anthropic a enquêté et a informé l'utilisateur qu'une clé de session Claude compromise avait été utilisée pour générer des jetons OAuth Claude Code non autorisés. Anthropic a également averti d'autres utilisateurs concernés de l'existence de logiciels malveillants de type infostealer capables de dérober des sessions de connexion Claude.
Cet incident rappelle utilement un problème de production plus large : les identifiants IA nécessitent une surveillance comportementale, pas seulement une authentification.
Ce guide explique comment construire cette couche de surveillance en utilisant les métadonnées de requête, des bases de référence adaptées aux charges de travail et la détection d'anomalies, sans avoir besoin d'inspecter le contenu des prompts des utilisateurs.
Un pic d'utilisation n'est pas une explication
Supposons que votre infrastructure IA traite normalement 50 000 jetons par heure.
Un matin, ce nombre grimpe à 300 000.
C'est une anomalie. Mais ce n'est pas encore une explication.
L'augmentation pourrait provenir de :
- un lancement de produit légitime
- un nouveau flux de travail d'agent
- une migration de modèle
- une boucle de nouvelle tentative
- des fenêtres de contexte plus longues
- un traitement par lots
- un changement côté fournisseur
- des identifiants compromis
Le chiffre global vous indique ce qu'il est advenu de la consommation. Il ne vous indique pas nécessairement quelle charge de travail l'a générée.
Cela devient particulièrement complexe lorsque plusieurs applications partagent le même compte fournisseur ou les mêmes identifiants d'API.
Une clé de production unique peut être utilisée par :
customer-chat
support-agent
document-worker
internal-copilot
scheduled-reports
Si l'utilisation totale double, le tableau de bord du fournisseur peut signaler l'augmentation avec précision.
Votre équipe de sécurité a tout de même une autre question : Quelle charge de travail a généré ce trafic inattendu ?
C'est là tout le problème de l'attribution.
Détection vs Attribution
Il est utile de diviser le suivi de l'utilisation de l'IA en trois niveaux.
1. Consommation
Quelle est notre consommation ?
Exemples :
- requêtes
- jetons d'entrée
- jetons de sortie
- coût
- latence
C'est le niveau que proposent la plupart des tableaux de bord basiques.
2. Détection
Le comportement actuel est-il inhabituel ?
Exemples :
- le volume de requêtes est nettement supérieur à la normale
- un modèle apparaît soudainement dans une charge de travail qui ne l'utilisait jamais auparavant
- le trafic survient à des heures inhabituelles
- la consommation de jetons change radicalement
Cela nécessite une base de référence.
3. Attribution
Quel identifiant, application, environnement ou charge de travail a généré l'anomalie ?
Exemples :
Cela nécessite des métadonnées de requête structurées.
L'essentiel est que la détection sans attribution complique l'investigation.
Vous savez qu'un changement a eu lieu, mais vous devez encore parcourir les journaux, les applications, les identifiants et les tableaux de bord des fournisseurs pour en trouver la source.
Pourquoi les identifiants d'IA en production sont différents
Les identifiants d'API traditionnels étaient souvent associés à une application relativement prévisible.
Les applications d'IA sont de moins en moins prévisibles.
Une requête LLM peut être générée par :
- un utilisateur interactif,
- un agent autonome,
- une tâche planifiée,
- un consommateur de file d'attente,
- un pipeline CI/CD,
- un assistant de codage,
- une tâche de synthèse en arrière-plan,
- ou un autre modèle agissant en tant qu'orchestrateur.
Les agents rendent le problème encore plus intéressant.
Une application classique pourrait produire :
Un agent peut produire :
Une charge de travail légitime peut donc générer des volumes de trafic importants et variables.
Cela signifie qu'une règle simple telle que « Plus de 1 000 requêtes par heure = compromis » n'est pas particulièrement utile. Le détecteur doit comprendre le comportement normal de chaque charge de travail.
Six signaux pouvant révéler des anomalies liées aux identifiants
Aucun signal isolé ne prouve qu'une clé API a été compromise.
L'approche pertinente consiste à combiner plusieurs signaux indépendants et à enquêter lorsque plusieurs d'entre eux évoluent simultanément.
1. Incohérence entre identifiant et charge de travail
Chaque identifiant doit avoir un usage prévu. Par exemple :
Imaginez maintenant que support-prod commence soudainement à effectuer des requêtes associées à la charge de travail de recherche.
Ce n'est pas forcément malveillant. Il pourrait s'agir d'une erreur de déploiement.
Mais c'est exactement le type d'événement qui mérite une enquête.
L'indicateur important n'est pas « Cette clé a effectué une requête », mais « Cette clé a effectué une requête qui ne correspond pas à sa charge de travail habituelle ».
2. Dérive du mix de modèles
La répartition des modèles utilisés par une application est souvent étonnamment stable.
Imaginons qu'une application de support se présente normalement ainsi :
Model A    72%
Model B    23%
Model C     5%
Puis, soudainement :
Model A    18%
Model B    12%
Model C    70%
Le volume total de requêtes peut à peine varier. Une simple alerte de dépenses pourrait donc passer à côté de l'événement.
La dérive du mix de modèles peut révéler des changements que le nombre total de jetons dissimule.
Les explications possibles incluent :
- un nouveau déploiement,
- un changement de routage,
- le déclenchement d'une solution de secours,
- une configuration incorrecte,
- ou une utilisation inattendue des identifiants.
Encore une fois, ce signal n'est pas la preuve d'un compromis. C'est la preuve que la charge de travail a changé.
3. Écart du taux de requêtes
Mesurez le volume de requêtes par rapport à l'historique de la charge de travail.
Par exemple : support-agent-prod
Normal:
09:00 → 120 requests
10:00 → 145 requests
11:00 → 138 requests

Observed:
09:00 → 130 requests
10:00 → 151 requests
11:00 → 1,842 requests
Un seuil global peut s'avérer trop imprécis, car chaque application possède son propre profil de trafic.
Une API de production desservant des millions d'utilisateurs et une tâche de rapport nocturne ne devraient pas partager le même seuil. La référence doit être spécifique à la charge de travail.
Pour certaines applications, la comparaison pertinente peut porter sur la même heure lors des jours de semaine récents. Pour d'autres, les tendances hebdomadaires ou mensuelles peuvent être plus significatives. L'essentiel est de comparer ce qui est comparable.
4. Écart de consommation de jetons
Le nombre de requêtes ne suffit pas. Une requête peut consommer quelques centaines de jetons, tandis qu'une autre peut en consommer des centaines de milliers.
Suivez au minimum les jetons d'entrée, les jetons de sortie, le total des jetons et, lorsque cela est possible, l'utilisation des jetons de raisonnement ou mis en cache.
Une métrique utile est la consommation de jetons par requête. Si le volume de requêtes reste stable mais que la consommation moyenne de jetons augmente soudainement, la charge de travail sous-jacente a peut-être changé.
Cela pourrait indiquer :
- des contextes plus longs,
- une modification du prompt ou de la récupération,
- une boucle d'agent,
- une migration de modèle,
- ou une activité inattendue.
5. Dérive temporelle
Les charges de travail de production suivent des modèles temporels.
Un service client peut être plus sollicité pendant les heures de bureau.
Un pipeline de traitement par lots peut s'exécuter chaque nuit.
Un environnement de développement peut être actif pendant les heures de travail et rester quasi inactif la nuit.
Une identification inattendue peut briser ce modèle. Par exemple :
Normal:
08:00–20:00 → active
20:00–08:00 → near zero

Observed:
02:13 → 900 requests
02:17 → 1,400 requests
02:22 → 1,900 requests
Cela ne prouve pas pour autant un vol d'identifiants.
Mais si la charge de travail était historiquement inactive à ce moment-là, l'événement devient beaucoup plus significatif.
Le temps doit donc être traité comme une caractéristique de la charge de travail, et non simplement comme un horodatage dans un journal.
6. Dérive réseau et géographique
Si votre infrastructure fonctionne normalement à partir d'un ensemble connu d'environnements ou de régions, un changement soudain peut constituer un autre signal utile.
Par exemple : support-prod
Encore une fois, il existe des explications légitimes.
- Les migrations vers le cloud arrivent.
- Les développeurs déploient depuis de nouvelles régions.
- Les VPN modifient les localisations apparentes.
Mais la dérive réseau ou géographique devient beaucoup plus pertinente lorsqu'elle est combinée à d'autres anomalies. Par exemple :
est considérablement plus intéressant que chacun de ces événements pris isolément.
Les métadonnées suffisent souvent
La surveillance de la sécurité ne nécessite pas nécessairement le stockage des invites utilisateur.
Pour de nombreuses questions opérationnelles, les métadonnées de la requête suffisent.
Un schéma d'événement utile peut ressembler à ceci :
timestamp
credential_id
application
environment
model
provider
tokens_in
tokens_out
source_region
status
latency_ms
request_id
Vous pouvez ajouter :
request_id
deployment_id
user_or_service_id
si ces identifiants sont adaptés à votre environnement.
L'avantage est que le système de surveillance peut répondre à des questions telles que :
- Quelle clé a généré ce trafic ?
- Quelle application l'a utilisé ?
- Quel modèle a été appelé ?
- Quand le comportement a-t-il changé ?
- De quelle région la requête provient-elle ?
sans conserver l'invite réelle ou la réponse du modèle.
C'est également un principe de confidentialité utile : Collectez le minimum de données nécessaires pour répondre à la question opérationnelle.
Si les métadonnées permettent d'identifier une charge de travail suspecte, il n'est peut-être pas nécessaire de conserver l'intégralité du contenu de chaque requête à des fins de surveillance de sécurité.
Créer un détecteur d'anomalies basé uniquement sur les métadonnées
Il n'est pas nécessaire de disposer d'un système de ML sophistiqué pour concevoir une première version utile.
Commencez par un journal de requêtes structuré.
Pour chaque charge de travail, établissez une base de référence représentant son cycle de fonctionnement normal.
Pour un service présentant des modèles de trafic quotidiens, vous pourriez comparer :
Monday 10:00
vs.
previous Mondays around 10:00
plutôt que de comparer le lundi matin au dimanche soir.
Un historique de 14 jours peut constituer un point de départ raisonnable pour un service fonctionnant en continu, mais la fenêtre appropriée dépend de la charge de travail. Les applications fortement saisonnières peuvent nécessiter des bases de référence beaucoup plus longues, tandis qu'une nouvelle charge de travail peut ne pas encore disposer d'un historique suffisant pour une détection fiable des anomalies.
Pour les charges de travail de production instables, des statistiques robustes telles que la médiane et l'écart absolu à la médiane (MAD) peuvent s'avérer utiles.
median(x)
MAD = median(|x - median(x)|)
La médiane vous donne une valeur typique, tandis que le MAD fournit une mesure de la variation habituelle des observations normales autour de cette valeur. Contrairement à une simple moyenne, ces mesures sont moins facilement faussées par un petit nombre de requêtes anormalement importantes.
Il n'est pas nécessaire de transformer cela en un système statistique complexe. L'essentiel est de choisir la bonne base de référence et de comparer des charges de travail et des périodes équivalentes.
Pour la plupart des équipes, cela peut commencer par un flux de travail de surveillance interne léger, construit à partir de la télémétrie existante de l'application ou de la passerelle. Les organisations plus avancées peuvent combiner plusieurs signaux comportementaux — tels que le volume de requêtes, l'utilisation du modèle, la consommation de jetons, le timing et les informations sur la source — dans un flux de travail de détection dédié.
Pour les clients ayant des exigences plus poussées en matière de sécurité et de surveillance, Eden AI peut prendre en charge des approches personnalisées pour identifier les modèles d'utilisation inhabituels de l'IA en utilisant les données centralisées de trafic et d'utilisation de l'IA. Il ne s'agit pas d'une fonctionnalité standard de détection d'anomalies intégrée à la plateforme ; ces besoins peuvent être traités dans le cadre d'exigences client plus avancées.
Pourquoi la médiane et le MAD peuvent être préférables à une simple utilisation de l'écart-type
Considérez cette charge de travail :
120
135
128
142
131
127
900
La valeur 900 peut correspondre à un traitement par lots légitime ou être suspecte.
Si le détecteur utilise immédiatement la moyenne et l'écart-type, cette observation extrême influence la ligne de base elle-même.
Les statistiques robustes réduisent cet effet. L'objectif n'est pas d'identifier magiquement une attaque, mais de fournir une réponse plus stable à la question : « À quel point cette observation est-elle inhabituelle par rapport au comportement normal de cette charge de travail ? »
Cette distinction est importante.
Un détecteur d'anomalies doit être un déclencheur d'enquête, et non un verdict.
De six signaux à une enquête
Vous pouvez désormais évaluer chaque requête ou fenêtre temporelle selon plusieurs dimensions :
Workload mismatch
Model drift
Request-rate deviation
Token deviation
Temporal deviation
Network/region deviation
Une fois ces signaux disponibles, une équipe peut les combiner dans un flux de travail d'enquête.
Un flux de surveillance simple pourrait générer un rapport d'enquête tel que :
Credential anomaly detected

Key:
support-prod

Signals:
✓ Request rate: 8.4× baseline
✓ Model mix: significant deviation
✓ Time: outside normal operating window
✓ Region: previously unseen
✓ Token volume: 6.1× baseline
✓ Workload identity: mismatch

Action:
Investigate credential and recent deployments
Remarquez que le système ne dit pas « Cette clé a été définitivement compromise ». Ce serait une fausse précision.
Le détecteur a identifié un comportement qui mérite une enquête.
Une implémentation plus avancée peut attribuer des poids à différents signaux, mais ces poids doivent découler des charges de travail observées et de l'expérience opérationnelle plutôt que de chiffres arbitraires.
La première version peut être basée sur des règles.
L'essentiel est de disposer de la télémétrie.
Un incident synthétique : ce que voit le détecteur
Imaginons une application de production fictive appelée : support-agent-prod
Son comportement normal est le suivant :
Requests/hour:       100–180
Models:              Model A + Model B
Active hours:        08:00–20:00 UTC
Region:              Europe
Average tokens/request: ~3,500
À 02:14 UTC, le système de surveillance observe :
Requests/hour:       1,420
Model:               Model C
Region:              Previously unseen
Average tokens/request: ~8,900
Credential:          support-prod
Le détecteur signale l'événement.
Que doit-il se passer ensuite ?
Pas « Supprimer l'application ».
Au lieu de cela :
- Vérifiez les déploiements récents.
- Vérifiez si une tâche planifiée a été exécutée.
- Vérifiez si la configuration du modèle a été modifiée.
- Consultez les journaux de l'application pour détecter des tentatives ou des boucles.
- Vérifiez si l'identifiant a été récemment partagé ou renouvelé.
- Comparez l'activité avec celle d'autres environnements.
- Si l'activité reste inexpliquée, faites pivoter ou révoquez les identifiants.
C'est là qu'une bonne observabilité devient une infrastructure de sécurité.
La détection ne représente que la moitié du travail
Repérer une anomalie n'est utile que si vous pouvez agir en conséquence.
La question suivante est : Quels dégâts un seul identifiant peut-il causer ?
C'est ce qu'on appelle le rayon d'impact.
Une clé API unique partagée entre la production, la préproduction, le développement, les outils internes et l'intégration continue a un rayon d'impact bien plus large que des identifiants distincts pour chaque charge de travail.
Une meilleure structure consiste à :
support-prod       → key A
research-prod      → key B
batch-worker       → key C
staging            → key D
development        → key E
Désormais, une anomalie dans support-prod ne nécessite pas automatiquement la rotation de tous les identifiants de l'organisation.
Une bonne hygiène des identifiants implique donc :
- de séparer les clés par charge de travail,
- de séparer les clés par environnement,
- d'appliquer le principe du moindre privilège,
- d'effectuer une rotation régulière,
- des identifiants à courte durée de vie lorsque cela est possible,
- des plafonds de dépenses,
- des limites de débit,
- et un processus de révocation éprouvé.
Ce dernier point est facile à négliger.
Un contrôle de sécurité qui n'existe que dans la documentation n'est pas un contrôle fiable.
Les équipes doivent tester périodiquement :
- Pouvons-nous identifier la clé concernée ?
- Pouvons-nous la révoquer rapidement ?
- Pouvons-nous déterminer quelle charge de travail l'utilisait ?
- Pouvons-nous rétablir le service avec un identifiant de remplacement ?
Ce qu'une passerelle IA peut — et ne peut pas — faire
Une passerelle IA crée un point de contrôle supplémentaire entre les applications et les fournisseurs de modèles.
Au lieu de :
vous pouvez avoir :
Cette architecture peut grandement faciliter la gestion des identifiants, le routage, le suivi de l'utilisation et l'application des politiques.
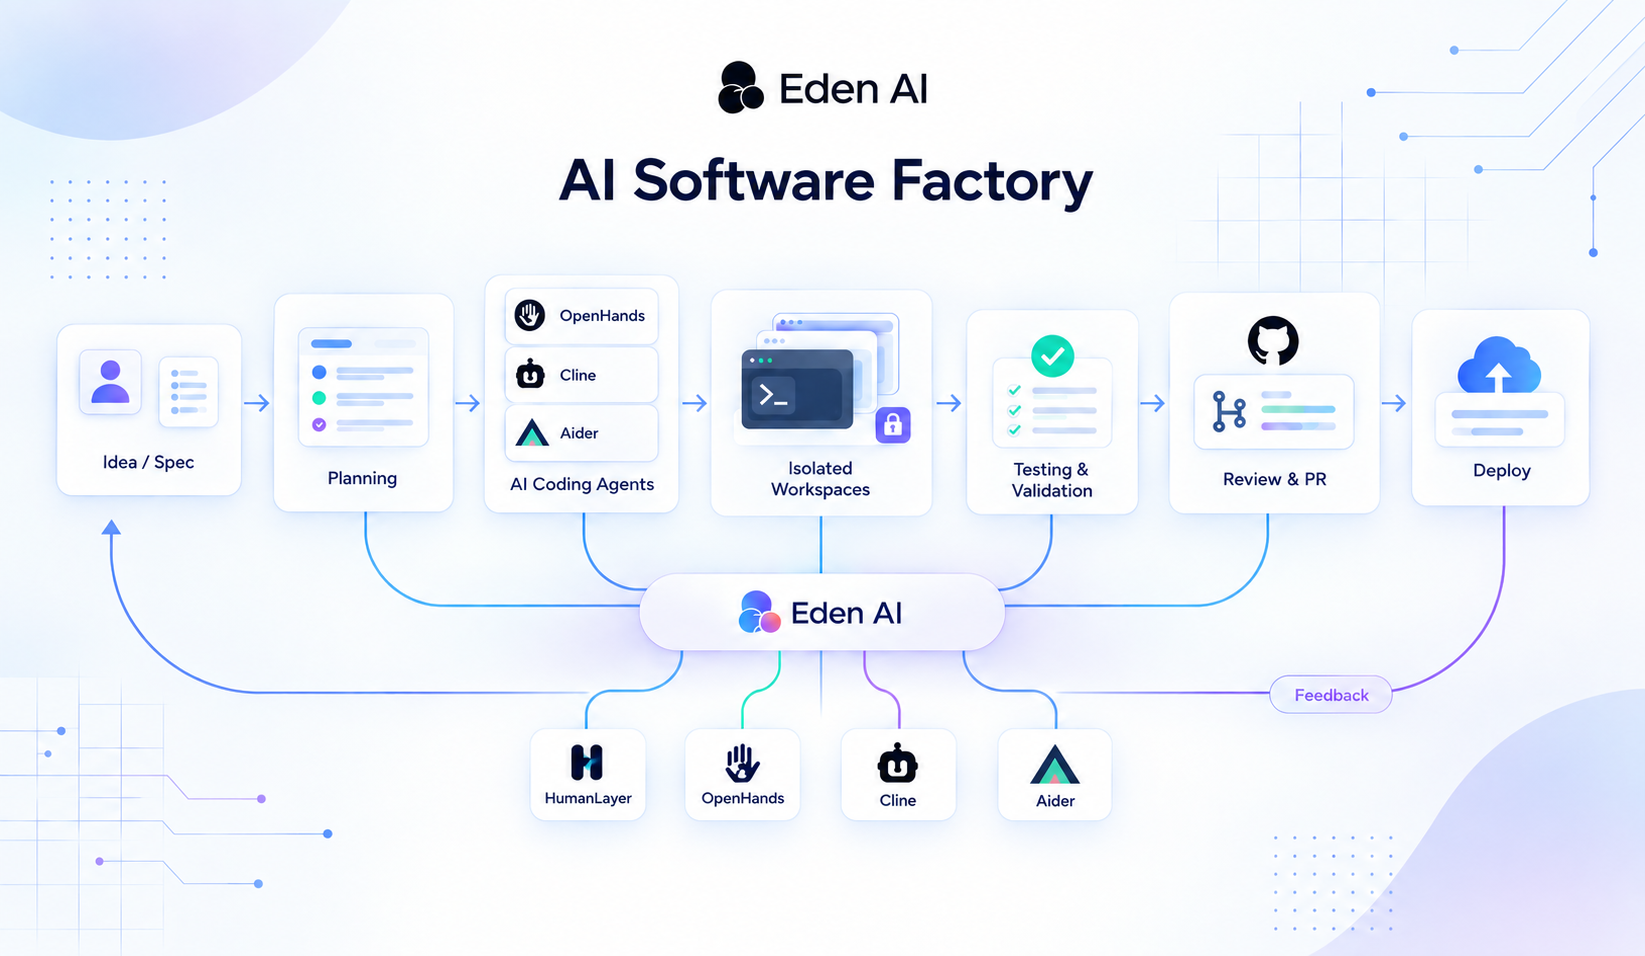
Par exemple, Eden AI fournit une passerelle unifiée pour plus de 500 modèles d'IA auprès de plus de 50 fournisseurs via une API unique. Sa plateforme V3 prend en charge le routage des modèles, les solutions de secours et le suivi des coûts.
Au lieu de collecter indépendamment la télémétrie auprès de chaque fournisseur, une organisation peut normaliser les métadonnées importantes au niveau des requêtes autour d'une couche de passerelle commune.
Le système de secours d'Eden AI permet également aux applications de spécifier des modèles de remplacement en cas de défaillance d'un fournisseur ou d'un modèle principal. Bien qu'utile pour la résilience, cela doit être pris en compte dans le monitoring : un événement de basculement peut légitimement modifier la répartition des modèles d'une charge de travail.
Cette distinction est importante.
Un système de monitoring qui considère tout changement de modèle comme suspect générera du bruit inutile.
Un système de monitoring capable de :
distinguer un événement de routage attendu d'une dérive de modèle inexpliquée.
Cependant, une passerelle n'est pas une solution miracle en matière de sécurité.
Si un attaquant dérobe un identifiant toujours valide, une passerelle ne peut pas déterminer automatiquement si chaque requête effectuée avec cet identifiant est malveillante.
Et si le point de terminaison est compromis avant que la requête n'atteigne votre passerelle, celle-ci ne peut pas réparer la machine compromise.
Son rôle est différent : Faciliter le contrôle des identifiants, l'observation des activités et l'investigation des comportements suspects.
La passerelle n'a pas besoin de prévenir chaque vol d'identifiant pour être utile. Elle doit rendre l'utilisation d'identifiants volés plus difficile et faciliter les enquêtes.
La véritable amélioration de la sécurité : passer des clés aux charges de travail
Le changement architectural le plus important consiste à cesser de considérer une clé API comme l'unité d'identité principale.
La clé n'est qu'un identifiant.
La question la plus pertinente est : Quelle charge de travail est autorisée à utiliser cet identifiant, et à quoi ressemble un comportement normal pour cette charge de travail ?
Cela vous donne une hiérarchie :
Une fois les requêtes reliées à cette hiérarchie, les anomalies deviennent beaucoup plus faciles à comprendre.
Par exemple :
Organization: Acme
Environment: Production
Application: Support Platform
Workload: Customer Support Agent
Credential: support-prod
Model: Model C
Region: Europe
Time: 02:14 UTC
Désormais, une requête inattendue ne se résume plus à « Quelqu'un a utilisé notre clé API ».
Elle devient « Une charge de travail de support en production a effectué une requête inhabituelle, hors de son profil comportemental habituel ».
Ce qu'il faut retenir
La sécurité des identifiants d'IA ne se limite plus à la question :
- « Combien avons-nous dépensé ? »
Les équipes de production doivent également se demander :
- « Quelle charge de travail a généré cette dépense ? »
- « Ce comportement est-il normal ? »
- « Qu'est-ce qui a changé ? »
- « Pouvons-nous révoquer l'identifiant concerné sans tout perturber ? »
Un pic d'utilisation est une information utile. Un détecteur d'anomalies est préférable.
Mais l'attribution est ce qui transforme une anomalie en une enquête.
Le point de départ pratique ne nécessite ni le stockage des prompts, ni le déploiement d'une plateforme de sécurité sophistiquée.
Commencez par des métadonnées structurées.
Séparez les identifiants par charge de travail.
Établissez des bases de référence spécifiques à chaque charge de travail.
Suivez le modèle, les jetons, le temps, la requête et le comportement réseau.
Recevez ensuite une alerte lorsque plusieurs signaux évoluent de concert.
Une passerelle d'IA telle qu'Eden AI peut offrir une couche centralisée pour l'accès aux modèles, le routage, la gestion des solutions de secours et la visibilité sur l'utilisation, mais le principe de sécurité sous-jacent reste le même : définissez ce qui constitue un comportement normal, identifiez la charge de travail responsable et limitez autant que possible l'impact potentiel de chaque identifiant.
À mesure que les agents d'IA gagnent en autonomie et que les infrastructures d'IA se décentralisent, cette couche d'attribution deviendra tout aussi cruciale que la clé API elle-même.
FAQ