Résumez cet article avec :
Une publication virale affirme que chaque développeur devrait exécuter son propre proxy LLM. Nous comparons les proxys auto-hébergés, les passerelles IA gérées et OpenTelemetry pour déterminer quelle couche offre la meilleure visibilité, quel niveau de contrôle vous obtenez et quels sont les coûts d'exploitation associés.
Les passerelles auto-hébergées, les passerelles IA gérées et OpenTelemetry répondent à des besoins différents au sein d'une même problématique. Voici comment déterminer ce dont votre architecture a réellement besoin.
Le 18 octobre 2026, le développeur Jared Siegel a publié un court article soutenant que quiconque souhaite comprendre ses charges de travail liées à l'IA devrait exécuter son propre proxy LLM. Son titre, adouci sur Hacker News en « Si vous n'utilisez pas votre propre proxy LLM, comment savez-vous ce qui se passe ? », est délibérément provocateur. La frustration qui en est à l'origine est bien connue : les tableaux de bord des fournisseurs indiquent le volume de consommation d'un service, mais pas le niveau de détail par requête nécessaire pour déboguer une application en production ou un agent de codage.
Siegel énumère cinq raisons d'utiliser un proxy : un point de terminaison unique pour plusieurs fournisseurs et modèles, des journaux indiquant quelle clé a appelé quel modèle, avec quel client et à quel moment, des clés API virtuelles, une infrastructure sous votre contrôle, et la possibilité de changer de modèle ou de fournisseur sans reconstruire votre configuration. Il affirme également pouvoir identifier la cause d'un échec de cache lors d'une session de codage en environ 20 secondes en consultant les données de son proxy.
Il a lui-même anticipé la principale objection : les agents de codage peuvent déjà exporter des données de télémétrie via OpenTelemetry. La discussion sur Hacker News a poussé cette objection plus loin. Un commentateur a fait valoir que l'insertion d'un proxy dans le flux de requêtes crée un point de défaillance unique pour le travail quotidien. D'autres ont répondu que la télémétrie ne couvre qu'une partie des fonctions d'un proxy, car elle ne permet pas de définir des limites strictes ou de rediriger le trafic.
Les deux points de vue se défendent. La question pertinente n'est pas de savoir si chaque développeur doit utiliser un proxy, mais quelles fonctionnalités votre application exige, quelle couche doit les fournir et qui est responsable de la maintenance de cette couche.
À quoi sert réellement un proxy LLM ?
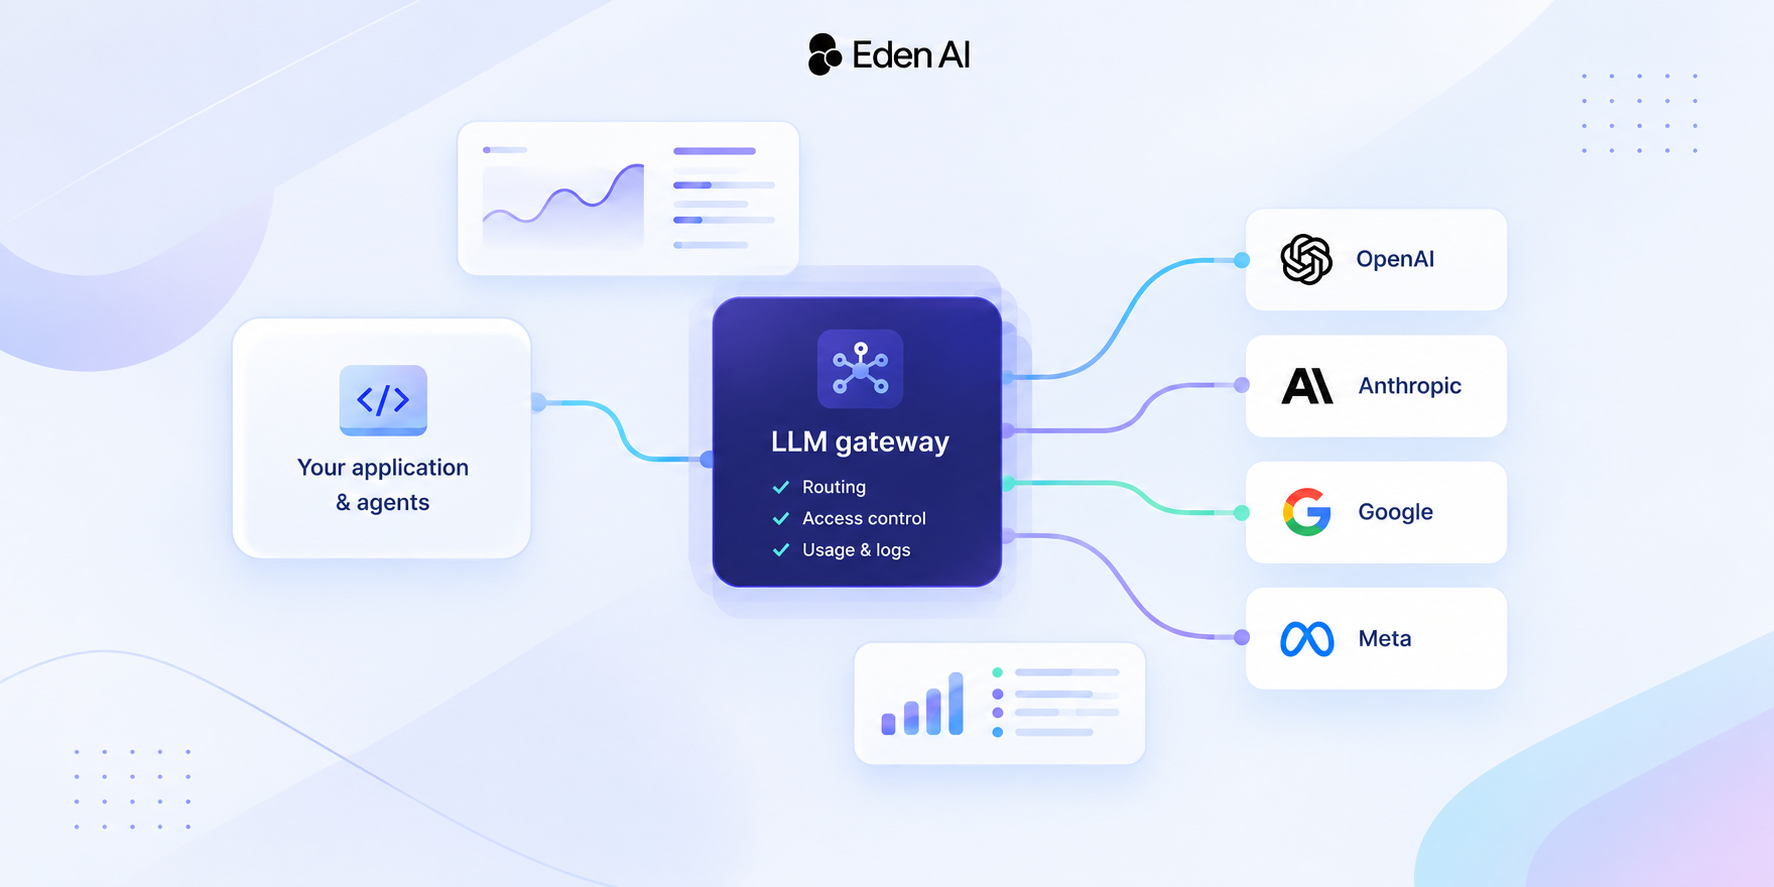
Un proxy LLM se place entre vos applications et les fournisseurs de modèles qu'elles sollicitent. Au lieu de connecter chaque application à chaque fournisseur, vous envoyez vos requêtes vers un point de terminaison unique que le proxy se charge de transmettre. Les termes « proxy LLM » et « passerelle LLM » sont souvent utilisés de manière interchangeable ; « passerelle » implique généralement des fonctionnalités de politique telles que la gestion des budgets, les règles d'accès et le routage.
Cette architecture simplifie l'intégration, mais le principal avantage réside dans ce qu'une passerelle bien configurée peut faire du trafic qui la traverse. Prenons l'exemple d'une équipe utilisant plusieurs agents de codage avec différents modèles. Sans couche de contrôle partagée, les identifiants des fournisseurs, les historiques d'utilisation et les configurations finissent par être dispersés sur les ordinateurs portables, les tâches CI et les environnements isolés des agents. Enquêter sur une seule requête défaillante revient alors à devoir assembler des informations provenant de sources multiples.
Les cinq arguments de Siegel se recoupent, mais chacun résout un problème distinct.
Un point de terminaison unique réduit le travail d'intégration. Les applications utilisent une interface unique pour accéder aux modèles pris en charge par plusieurs fournisseurs. Le changement de modèle est facilité, mais il est rarement totalement transparent : l'appel d'outils, les sorties structurées et les paramètres spécifiques aux fournisseurs peuvent se comporter différemment d'un modèle à l'autre, un écart que nous avons abordé dans ce que signifie réellement « prendre en charge » en production.
Les journaux au niveau des requêtes rendent le débogage concret. Au lieu de se fier à des graphiques d'utilisation agrégés, les ingénieurs peuvent inspecter les requêtes individuelles : la clé ou le client, le modèle, l'horodatage, le statut, la consommation de jetons et le coût. Cela permet d'expliquer pourquoi une application s'est comportée différemment de ce qui était prévu, bien que cela ne révèle pas toutes les décisions prises en interne par un fournisseur.
Les clés virtuelles séparent l'accès des identifiants. Chaque application ou agent reçoit son propre identifiant au lieu d'utiliser la clé API principale du fournisseur. Selon la passerelle, cette clé peut être limitée, budgétisée, surveillée ou révoquée sans affecter le reste. C'est particulièrement important pour les agents de codage en bac à sable : le bac à sable ne voit qu'une clé que vous pouvez révoquer. Cela facilite également la détection d'une utilisation anormale des identifiants.
Posséder l'infrastructure permet une personnalisation plus poussée. Une passerelle auto-hébergée peut s'intégrer aux politiques internes d'authentification, de journalisation, de réseau et de déploiement. Siegel, par exemple, a modifié la sienne pour obtenir une meilleure visibilité et des points de terminaison MCP personnalisés. Cependant, chaque personnalisation devient un élément que votre équipe doit maintenir.
Le routage et le basculement peuvent améliorer la résilience. Une passerelle peut relancer les requêtes éligibles ou changer de fournisseur lorsqu'une défaillance prise en charge survient. L'amélioration de la fiabilité dépend du mode de défaillance, de la politique de nouvelle tentative et de la compatibilité du modèle. Les tentatives aveugles peuvent augmenter les coûts ou dupliquer les effets secondaires ; le basculement doit donc être conçu plutôt que simplement activé. Notre guide sur les stratégies de routage LLM approfondit ce sujet.
Ces avantages deviennent pertinents lorsqu'une organisation dispose d'un volume de trafic IA, d'utilisateurs et d'une complexité opérationnelle suffisants pour justifier une couche de contrôle partagée. Pour un développeur effectuant des appels occasionnels à un modèle, cette infrastructure supplémentaire est généralement inutile.
Proxy LLM vs OpenTelemetry : la visibilité n'est pas le contrôle
L'objection liée à OpenTelemetry est le contre-argument le plus solide dans ce débat, et elle mérite bien plus qu'une simple mention.
OpenTelemetry (OTel) est un framework open source, indépendant des fournisseurs, destiné à générer, collecter et exporter des traces, des métriques et des journaux. Il ne s'agit pas d'un backend d'observabilité : les équipes l'utilisent pour instrumenter leurs applications, puis envoient les données vers un système qui les stocke, les interroge et les visualise. Ses conventions sémantiques GenAI, encore en cours de développement, normalisent la manière dont un appel de modèle est décrit, incluant le fournisseur, le modèle et la consommation de jetons.
Les agents de codage émettent déjà des signaux utiles. Claude Code exporte des métriques et des événements via OTel, avec le traçage distribué en version bêta. Codex prend également en charge l'exportation OTel, mais elle est désactivée par défaut et doit être activée dans son fichier de configuration. Une fois configurés, ces signaux aident les équipes à enquêter sur les échecs de requêtes, la latence, l'exécution des outils et les coûts.
Pour un développeur indépendant qui souhaite principalement comprendre une session de codage, les journaux locaux et OTel peuvent suffire. Pour une équipe disposant d'une pile d'observabilité établie, ajouter un service uniquement pour collecter des données que l'application émet déjà représente une complexité inutile.
Mais la télémétrie et le contrôle du trafic ne sont pas interchangeables. La télémétrie décrit ce qui s'est passé. Une passerelle se place sur le chemin de la requête et peut agir avant que celle-ci ne soit transmise : appliquer un budget, bloquer un modèle, révoquer une clé virtuelle ou envoyer la requête à un autre fournisseur. OTel vous aide à détecter et à étudier un problème ; en soi, il n'impose rien.
La frontière n'est pas absolue. Les applications peuvent appliquer des limites elles-mêmes via des hooks ou du code, et de nombreuses passerelles émettent des données OTel, ce qui combine le contrôle du trafic avec une observabilité standardisée. La véritable comparaison se situe entre les capacités offertes par chaque architecture et le coût opérationnel pour les fournir.
La télémétrie présente également des angles morts, car elle ne montre que ce que les composants instrumentés exposent. Claude Code, par exemple, ne transmet pas ses paramètres OTel aux sous-processus qu'il lance ; ainsi, un outil exécuté via son shell ne sera pas rapporté dans le même pipeline à moins d'être configuré séparément. Les décisions de cache côté fournisseur et les appels réseau effectués par les outils peuvent également ne pas apparaître. Les équipes préoccupées par le comportement global des agents pourraient avoir besoin d'une surveillance réseau, d'un sandboxing ou d'une passerelle en complément de la télémétrie.
Le coût caché de l'auto-hébergement d'une passerelle LLM
Un proxy auto-hébergé offre à une équipe un contrôle direct, mais il ajoute également un service à déployer, surveiller, mettre à jour et sécuriser. Si les applications ne peuvent pas fonctionner sans lui et qu'il n'existe aucune redondance ou contournement, il devient un point de défaillance unique, ce qui est précisément le risque soulevé sur Hacker News.
Les équipes doivent planifier la disponibilité, la capacité, la latence, le stockage des identifiants, le contrôle d'accès, les sauvegardes, les mises à jour et la réponse aux incidents. La personnalisation est précieuse, mais le code et la configuration personnalisés élargissent également la surface nécessitant des tests et une maintenance.
La sécurité est l'autre facette de cette responsabilité. Le 24 mars 2026, deux versions de LiteLLM publiées sur PyPI, les versions 1.82.7 et 1.82.8, contenaient du code malveillant. Selon la mise à jour de l'incident LiteLLM, les paquets sont restés en ligne pendant environ 40 minutes avant que PyPI ne les mette en quarantaine, et l'équipe pense que le compromis provient du scanner de sécurité Trivy utilisé dans son pipeline CI/CD. La charge utile était un logiciel de vol d'identifiants qui recherchait des variables d'environnement, des clés SSH, des identifiants cloud, des jetons Kubernetes et des mots de passe de base de données.
Les utilisateurs de l'image Docker officielle LiteLLM Proxy n'ont pas été affectés, car ce chemin de déploiement verrouille ses dépendances. LiteLLM a publié une version v1.83.0 propre via un pipeline de publication reconstruit le 30 mars, et ses images Docker sont désormais signées.
L'incident est important car une passerelle détient exactement ce que les attaquants recherchent : des clés de fournisseur et des configurations. Un composant compromis à ce niveau peut exposer bien plus que les requêtes qu'il achemine, un risque que nous avons exploré dans quand votre routeur LLM se retourne contre vous.
La mauvaise leçon serait de croire que l'auto-hébergement de LiteLLM est intrinsèquement dangereux, ou qu'une passerelle gérée ne peut pas subir d'incident de chaîne d'approvisionnement. Chaque composant sur le chemin de la requête IA ajoute des dépendances et des hypothèses de confiance. L'auto-hébergement rend votre organisation responsable de l'exploitation et de la sécurisation du déploiement ; un service géré signifie, à l'inverse, évaluer les contrôles, les politiques et la fiabilité du fournisseur.
Quel que soit le modèle choisi, quelques mesures de protection s'appliquent :
- Verrouillez les dépendances sur des versions vérifiées et privilégiez les artefacts de publication signés lorsqu'ils existent.
- Vérifiez la provenance des artefacts et analysez la chaîne d'approvisionnement logicielle.
- Limitez les processus pouvant lire les secrets et séparez les identifiants de développement de ceux de production.
- Maintenez un processus testé pour révoquer les clés exposées et enquêter sur les activités suspectes.
La question n'est pas de savoir quel modèle de déploiement élimine les risques, mais si votre équipe est capable de gérer ceux qu'elle accepte.
Auto-hébergé, géré ou uniquement OTel : quelle architecture convient à votre équipe ?
Les proxys auto-hébergés, les passerelles gérées et les configurations basées uniquement sur la télémétrie sont des points de référence utiles, et non des choix exclusifs. De nombreux systèmes en production combinent une passerelle avec OpenTelemetry.
Une passerelle auto-hébergée est pertinente lorsque le contrôle du déploiement, de la personnalisation et du flux de données justifie le coût de son exploitation. Elle est adaptée aux équipes disposant d'ingénieurs plateforme capables de la faire fonctionner de manière fiable.
Une une passerelle gérée délègue le déploiement et la maintenance de la passerelle à un fournisseur de services. Cette solution convient aux équipes ayant besoin d'un accès multi-fournisseurs et de contrôles centralisés sans avoir à gérer un service supplémentaire, en échange d'une confiance accordée au fournisseur concernant la disponibilité, les pratiques de sécurité, le traitement des données et la mise en œuvre.
Une approche axée sur OTel est souvent le point de départ le plus simple lorsque le besoin principal est la visibilité plutôt que l'application de règles. Elle complète également tout type de passerelle en offrant à l'application et à ses dépendances un pipeline de télémétrie commun.
En pratique, le bon choix dépend de votre profil :
- Développeur indépendant utilisant un seul outil de codage par abonnement : commencez par les journaux et la télémétrie natifs de l'outil. Un proxy apporte peu de valeur ajoutée, et les plans d'abonnement ne peuvent souvent pas être redirigés via une passerelle arbitraire sans solutions de contournement non prises en charge, une limite dont Siegel lui-même s'est plaint plus tôt en octobre.
- Développeur expérimentant plusieurs modèles : un proxy léger auto-hébergé constitue un bon projet d'apprentissage, tant que la charge de maintenance reste acceptable.
- Équipe plateforme avec des exigences de déploiement strictes : l'auto-hébergement est judicieux lorsque vous avez besoin d'un contrôle direct sur l'infrastructure et que vous disposez des ressources nécessaires pour la sécuriser et la maintenir.
- Équipe de production utilisant plusieurs fournisseurs d'API sans infrastructure dédiée : une passerelle gérée, combinée à une surveillance au niveau de l'application et à OTel lorsque cela est pertinent, réduit la charge opérationnelle.
- Organisation ayant des besoins complexes en matière d'observabilité : une architecture hybride permet de mettre en place des politiques et un routage au niveau de la passerelle, tout en bénéficiant de la télémétrie provenant des applications, des agents de codage et des services de support.
Un principe s'applique aux cinq cas : ne construisez pas de proxy simplement parce que cela semble être le choix d'ingénierie le plus sérieux. Partez de vos besoins, identifiez la couche capable d'y répondre et n'exploitez pas de composants qui ne justifient pas leur coût.
La place d'Eden AI
Eden AI est une option gérée pour les équipes qui souhaitent une interface unique pour accéder à de nombreux fournisseurs d'IA sans avoir à gérer leur propre infrastructure de passerelle.
Elle expose une API compatible avec OpenAI, permettant ainsi aux SDK et aux frameworks d'agents existants de basculer vers cette solution en modifiant simplement l'URL de base. Derrière ce point de terminaison se trouvent des LLM et des modèles experts spécialisés dans l'OCR, la reconnaissance vocale et la traduction, provenant de multiples fournisseurs. Les fonctionnalités de la passerelle incluent le routage intelligent et les mécanismes de secours, le routage basé sur les coûts, la mise en cache, des plafonds budgétaires par clé API réinitialisables quotidiennement, hebdomadairement ou mensuellement, ainsi que le coût de chaque requête renvoyé dans sa réponse. Gestion de l'organisation attribue les appels à une équipe, un client ou un produit, avec des rôles et un accès aux modèles par clé. Grâce à l'option « Bring Your Own Keys », les équipes peuvent conserver leurs tarifs négociés auprès des fournisseurs, tandis qu'Eden AI gère le routage et la surveillance. Comme pour toute passerelle, vérifiez le comportement de chaque fonctionnalité pour votre charge de travail avant de vous y fier.
Pour répondre aux exigences de résidence des données en Europe, Eden AI propose une point de terminaison européen qui achemine les requêtes uniquement via des fournisseurs éligibles dans l'UE et ne bascule jamais automatiquement vers le point de terminaison mondial. Concernant le traitement des données, ses politiques de données des fournisseurs stipulent qu'Eden AI ne stocke par défaut aucun contenu de requête ou de réponse et n'utilise pas les données des clients pour l'entraînement. La conservation des données par le fournisseur du modèle sous-jacent dépend de ce dernier ; par conséquent, pour garantir une absence totale de conservation des données de bout en bout, il est nécessaire de verrouiller les modèles et les solutions de secours sur des fournisseurs qui le proposent. Sa page de sécurité détaille les certifications et les contrôles. Les équipes doivent évaluer l'ensemble de ces éléments au regard de leur propre configuration, de leurs contrats et de leurs exigences en matière de traitement des données.
Une passerelle gérée permet de s'affranchir de la maintenance technique, mais ne dispense pas de toutes les responsabilités opérationnelles. Les applications nécessitent toujours des contrôles d'accès robustes, une surveillance, une gestion pertinente des tentatives de reconnexion et un plan en cas d'interruption de service. Les organisations doivent évaluer à la fois le fournisseur de la passerelle et les fournisseurs de modèles sous-jacents.
Un service géré n'est donc pas la réponse universelle au débat sur les proxys. C'est une option destinée aux équipes qui préfèrent déléguer une partie de leur infrastructure en échange d'une dépendance vis-à-vis d'un tiers.
La visibilité est une exigence. L'architecture est un choix.
Le débat sur Hacker News souligne une lacune réelle dans la manière dont les équipes observent et contrôlent leurs charges de travail liées à l'IA. Les tableaux de bord des fournisseurs expliquent rarement ce qui s'est passé au sein d'une application, surtout lorsque plusieurs clients, agents et modèles sont impliqués.
L'utilisation d'un proxy n'est qu'un moyen parmi d'autres de combler cette lacune. OpenTelemetry et les journaux d'application offrent une visibilité pertinente ; une passerelle ajoute des politiques centralisées, un contrôle d'accès et un routage ; un service géré supprime la charge opérationnelle liée à cette passerelle.
La véritable erreur n'est pas de choisir le mauvais proxy. C'est de déployer des systèmes d'IA sans savoir quelles preuves sont disponibles, quels contrôles sont appliqués et qui est responsable en cas de défaillance. Répondez d'abord à ces questions, puis choisissez l'architecture la plus simple qui y répond de manière fiable.