Résumez cet article avec :
Le changement de PDG chez Nvidia ne devrait pas perturber vos appels d'API. Mais beaucoup de fournisseurs d'IA, européens compris, tournent sur des GPU Nvidia. Comment vérifier ce dont votre stack dépend vraiment, ce qui tourne déjà sans Nvidia et comment tester une bascule.
Réponse courte : probablement pas. Le conseil d'administration de Nvidia prévoit que les opérations, les engagements envers les clients et la feuille de route produit se poursuivent « sans interruption ». La question utile est celle que cette nouvelle soulève : si vous utilisez trois fournisseurs d'IA, combien tournent sur les mêmes GPU Nvidia ? Souvent plus que vous ne le pensez.
Le 12 novembre 2026, Nvidia a annoncé que Jensen Huang quittait ses fonctions de président, de PDG et de membre du conseil d'administration, avec effet immédiat, après 33 ans dans l'entreprise qu'il a cofondée. Ce guide laisse les gros titres de côté et regarde ce que cela change pour les équipes qui construisent sur des API d'IA : à quel point l'inférence est concentrée, pourquoi « européen » ne veut pas dire « sans Nvidia », et ce qu'on peut déjà appeler sur un autre matériel.
Ce qui s'est passé chez Nvidia
Les faits, d'après l'annonce de Nvidia et le direct de CNN :
- Jensen Huang a démissionné le 12 novembre 2026, avec effet immédiat.
- Colette Kress, directrice financière depuis 2013, devient PDG par intérim. Elle garde son poste de directrice financière jusqu'à la nomination d'un successeur. Le conseil étudiera des candidats internes et externes.
- Harvey C. Jones devient le tout premier président du conseil d'administration de Nvidia. Il a été PDG puis président exécutif de Synopsys.
- L'action Nvidia a fortement baissé le jour de l'annonce.
- Le conseil ne prévoit aucune interruption pour les clients. Les résultats du troisième trimestre restent prévus le 17 novembre.
Rien n'indique de perturbation pour les développeurs aujourd'hui : les GPU déjà installés continuent de tourner, et les fournisseurs continuent de servir les modèles. Mais cette nouvelle rappelle à quel point l'industrie de l'IA repose sur une seule entreprise, et combien peu d'équipes savent sur quelles puces tournent leurs propres requêtes.
Plusieurs fournisseurs, ce n'est pas plusieurs matériels
Beaucoup d'équipes se protègent des pannes en utilisant plusieurs fournisseurs d'IA. C'est une bonne habitude, mais elle protège contre la panne d'un fournisseur, pas contre une dépendance commune. Beaucoup de fournisseurs d'inférence louent ou achètent les mêmes GPU Nvidia. Si votre fournisseur principal et votre fournisseur de secours tournent tous les deux dessus, une pénurie de GPU, une hausse de prix ou un problème logiciel peut les toucher en même temps.
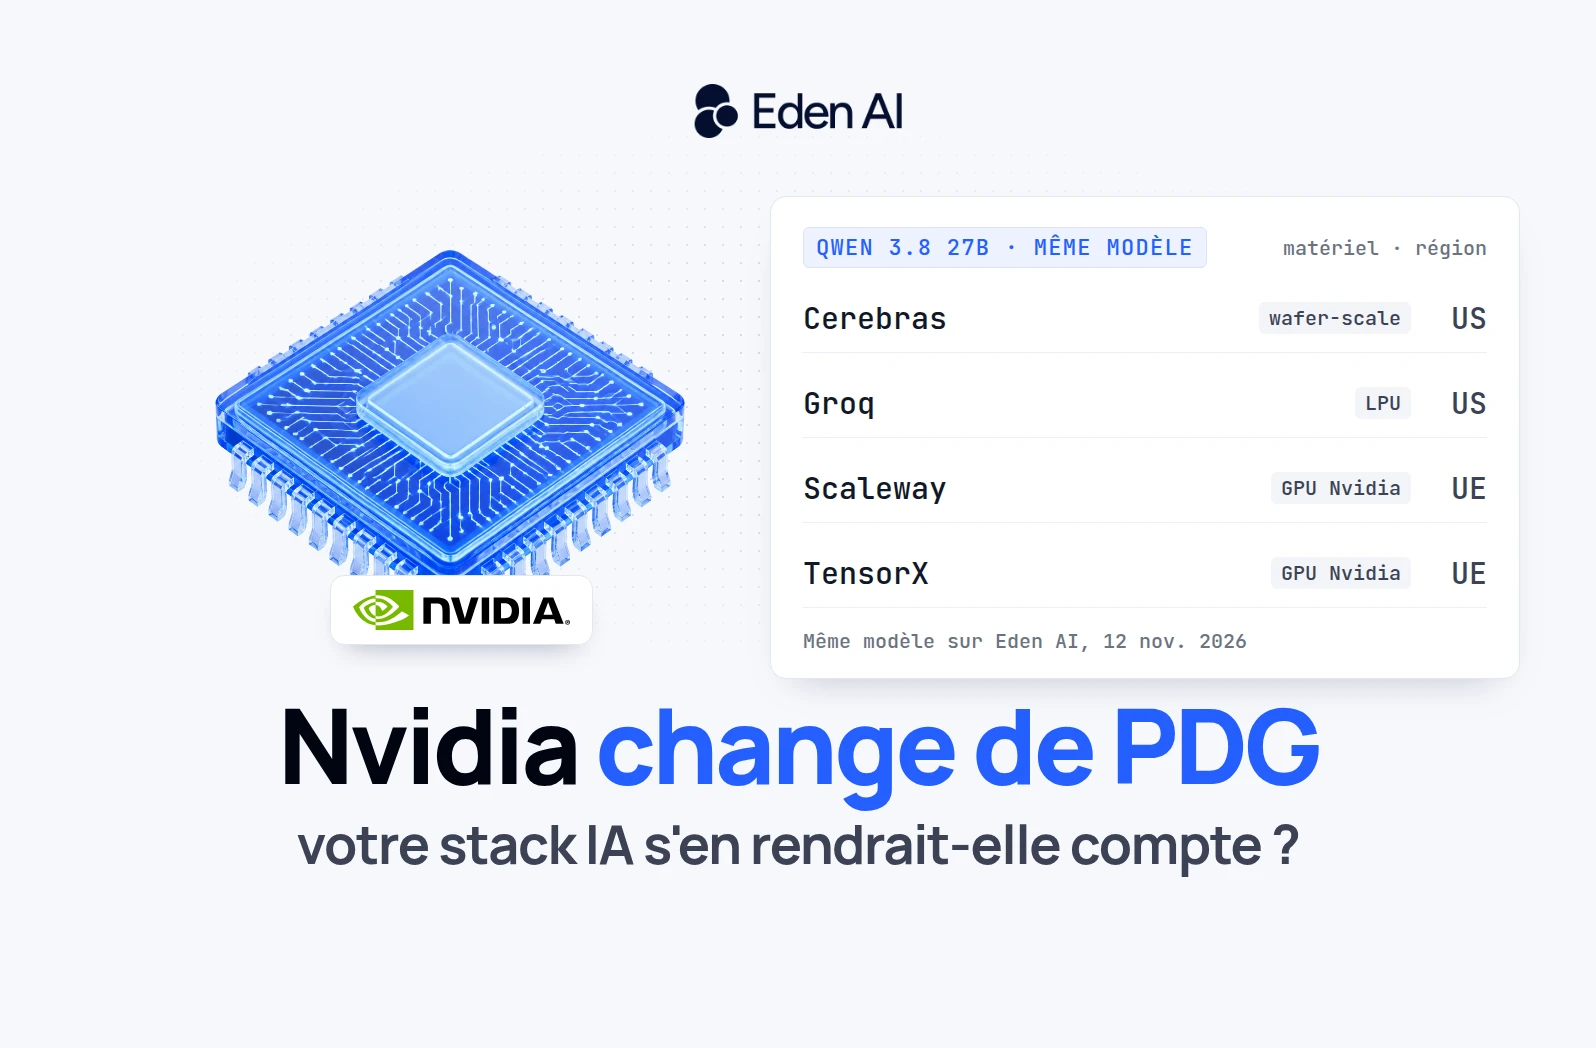
Un exemple concret : Qwen 3.8 27B est servi par 12 fournisseurs différents dans le catalogue Eden AI. La plupart le font tourner sur des GPU Nvidia. Deux d'entre eux, Groq et Cerebras, le font tourner sur des puces qu'ils ont conçues eux-mêmes.
Avant de compter vos fournisseurs, comptez donc vos familles de matériel. Trois questions suffisent :
- Quelles puces servent chacun de vos modèles ? Les fournisseurs l'indiquent en général sur leurs pages GPU ou infrastructure.
- Vos fournisseurs de secours utilisent-ils un autre matériel que le principal ?
- Vos données peuvent-elles sortir de votre région ? Comme on le verra plus bas, c'est là que se trouve le vrai compromis aujourd'hui.
Européen ne veut pas dire sans Nvidia
Choisir un fournisseur européen, dans une région UE, peut garder vos données en Europe. Cela ne change pas les puces. Nous avons vérifié les pages publiques des fournisseurs européens disponibles sur Eden AI :
| Fournisseur | Localisation | GPU annoncés sur leurs pages publiques |
|---|---|---|
| Scaleway | France | Nvidia : H100, L40S, B300 |
| OVHcloud | France | Nvidia : L40S, A100, H100 |
| Arkane Cloud | France | Nvidia Blackwell, dans des data centers français |
| Mistral AI | France | Nvidia, pour Mistral Compute |
| TensorX | Data centers à Dublin et Helsinki | Nvidia B300 |
| Nebius | Pays-Bas | Nvidia : H100, H200, B200 |
| Infomaniak | Suisse | Nvidia H100 |
| IONOS, T-Systems | Allemagne | Non trouvé dans nos sources |
Ces pages annoncent des GPU Nvidia, ou nous n'avons pas trouvé d'information sur le matériel. C'est le même piège que confondre résidence des données et souveraineté : l'endroit où vos données sont traitées et ce dont elles dépendent sont deux questions différentes. La première est traitée dans notre guide des passerelles IA conformes au RGPD.
Ce qui tourne déjà sans Nvidia
Quelques entreprises conçoivent leurs propres puces d'inférence et en vendent l'accès par API :
- Groq fait tourner les modèles sur son LPU, une puce conçue pour l'inférence rapide. Disponible sur Eden AI.
- Cerebras fait tourner les modèles sur son wafer-scale engine, une seule puce de la taille d'une galette de silicium. Disponible sur Eden AI.
- SambaNova fait tourner les modèles sur sa propre architecture RDU et propose une API compatible OpenAI via SambaNova Cloud. Il n'est pas sur Eden AI aujourd'hui.
Pour voir ce que cela donne en pratique, nous avons appelé le même modèle, Qwen 3.8 27B, chez deux fournisseurs européens sur GPU Nvidia, puis chez Groq et Cerebras, via Eden AI :
| Fournisseur | Matériel | Région | Prix par million de tokens (entrée / sortie) |
|---|---|---|---|
| Scaleway | GPU Nvidia | UE | 0,67 $ / 3,67 $ |
| TensorX | GPU Nvidia | UE | 0,40 $ / 2,40 $ |
| Groq | LPU Groq | États-Unis | 0,80 $ / 4,00 $ |
| Cerebras | Puce wafer-scale Cerebras | États-Unis | 0,99 $ / 1,49 $ |
Deux leçons de ce test :
- Le même modèle fonctionne sur des puces différentes. Les quatre fournisseurs ont répondu à la même requête avec le même modèle : changer de matériel ne veut pas dire changer de modèle. Quelques appels de test ne font pas un benchmark : comparez vitesse et qualité sur vos propres usages. Cerebras affichait le prix de sortie le plus bas des quatre.
- Mais elles sont référencées dans la région États-Unis. Dans ce test, quitter Nvidia voulait dire quitter l'UE. Si vos données doivent rester en Europe, vos fournisseurs de secours tourneront très probablement eux aussi sur des GPU Nvidia.
Les puces européennes à suivre
Plusieurs entreprises européennes conçoivent des puces d'inférence. Nous n'avons trouvé aucune API d'inférence publique qui les utilise, mais trois méritent d'être suivies :
- Axelera AI (Pays-Bas) a lancé Europa le 15 septembre 2026, un accélérateur d'inférence disponible dans des serveurs Dell et Supermicro validés. L'entreprise annonce plus de 600 clients pour sa puce précédente, Metis, et OVHcloud a annoncé un partenariat autour des produits basés sur Europa.
- VSORA (France) a finalisé la conception de Jotunn8, sa puce d'inférence pour data centers, en octobre 2025. Nous n'avons trouvé aucun cloud qui la propose encore.
- SiPearl (France) fabrique Rhea1, un processeur et non un accélérateur d'IA. Associé à des puces Axelera, il équipera la partie inférence du supercalculateur italien IT4LIA.
Quand l'une d'elles arrivera chez un fournisseur d'inférence européen, ce pourrait être un moyen de garder ses données en Europe sans dépendre de Nvidia.
Comment ajouter un secours sur un autre matériel avec Eden AI
Pas besoin de réécrire votre stack pour la diversifier. Avec Eden AI, vous appelez tous les fournisseurs via un seul endpoint compatible OpenAI, et vous pouvez lister des modèles de secours dans la même requête avec le paramètre fallbacks. Ici, le modèle principal tourne sur des GPU Nvidia en UE, et les secours font tourner le même modèle sur les puces de Groq et de Cerebras :
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["EDENAI_API_KEY"], base_url="https://api.edenai.run/v3", timeout=30)

response = client.chat.completions.create(
    model="scaleway/qwen3.8-27b",  # GPU Nvidia, hébergé en UE
    extra_body={
        # même modèle sur un autre matériel : LPU Groq, puis puce wafer-scale Cerebras
        "fallbacks": ["groq/qwen/qwen3.8-27b", "cerebras/qwen-3.8-27b"],
    },
    messages=[{"role": "user", "content": "Summarise in one line: the API returned 503 errors for 12 minutes."}],
)

print(response.model, "->", response.choices[0].message.content)
Nous avons lancé ce code le 12 novembre 2026, et c'est Scaleway, le modèle principal, qui a répondu. Pour vérifier la bascule, nous avons ensuite fait échouer l'appel principal exprès, en demandant 5 millions de tokens de sortie, plus que Scaleway n'en accepte : c'est Groq qui a répondu, en moins d'une seconde. Quatre choses apprises pendant nos tests :
- Les fallbacks réagissent aux erreurs, pas à la lenteur. Lors d'un de nos appels, un fournisseur a mis plus de 100 secondes à répondre sans échouer, et le secours n'a pas pris le relais. Fixez un délai d'attente côté client, comme ci-dessus, et décidez de ce que fait votre application quand il est atteint.
- Toutes les erreurs ne déclenchent pas de secours. Une requête plus longue que la fenêtre de contexte du modèle a été refusée sans bascule, ce qui est logique : les secours font tourner le même modèle et échoueraient aussi.
- L'endpoint UE refuse les secours hors UE. Sur l'endpoint UE, notre requête avec un secours Groq a été refusée avec une erreur 451, comme prévu par la documentation. Avec Scaleway et TensorX en secours, elle est passée.
- Trois fallbacks au maximum par requête. Pour laisser Eden AI choisir parmi les fournisseurs d'un même modèle, utilisez plutôt le routage par fournisseur, et vérifiez le matériel de ces fournisseurs : le routage seul ne garantit pas la diversité du matériel.
La checklist de la semaine
- Listez les modèles et les fournisseurs que votre application appelle en production.
- Notez le matériel derrière chacun, d'après les pages publiques du fournisseur.
- Ajoutez au moins un secours sur un autre matériel si vos données peuvent sortir de l'UE, ou chez un autre fournisseur si elles ne le peuvent pas.
- Testez la bascule volontairement, avec un délai d'attente côté client, avant d'en avoir besoin.
- Revérifiez dans six mois : les puces d'inférence européennes arrivent, et les options vont changer.
FAQ
Jensen Huang a-t-il démissionné de Nvidia ?
Oui. Nvidia a annoncé le 12 novembre 2026 que Jensen Huang quittait ses fonctions de président, de PDG et de membre du conseil d'administration, avec effet immédiat. La directrice financière Colette Kress assure l'intérim pendant que le conseil cherche un successeur.
Le changement de PDG chez Nvidia va-t-il affecter les API d'IA ?
Pas directement. Le conseil d'administration de Nvidia prévoit que les opérations, les engagements envers les clients et la feuille de route produit se poursuivent sans interruption, et les GPU déjà installés chez les fournisseurs d'inférence continuent de tourner. Cette nouvelle rappelle surtout de vérifier à quel point votre stack dépend d'un seul fournisseur de matériel.
Quels fournisseurs d'inférence IA n'utilisent pas de GPU Nvidia ?
Groq (LPU), Cerebras (wafer-scale engine) et SambaNova (RDU) font tourner les modèles sur leurs propres puces. Groq et Cerebras sont disponibles sur Eden AI, où ils sont référencés dans la région États-Unis.
Peut-on garder ses données en UE sans dépendre de Nvidia ?
Pas facilement aujourd'hui. Les fournisseurs européens listés plus haut annoncent des GPU Nvidia, ou nous n'avons pas trouvé d'information sur leur matériel, et Groq et Cerebras sont référencés dans la région États-Unis sur Eden AI. Des puces européennes comme Europa d'Axelera commencent à arriver dans des serveurs, mais pas encore dans des API d'inférence publiques.
Comment ajouter un secours sur un autre matériel avec Eden AI ?
Ajoutez une liste fallbacks à votre requête de chat, avec jusqu'à trois modèles de secours. Vous pouvez choisir le même modèle servi sur un autre matériel, par exemple Qwen 3.8 27B chez Scaleway, puis Groq, puis Cerebras. Sur l'endpoint UE, chaque secours doit être éligible à l'UE.