Résumez cet article avec :
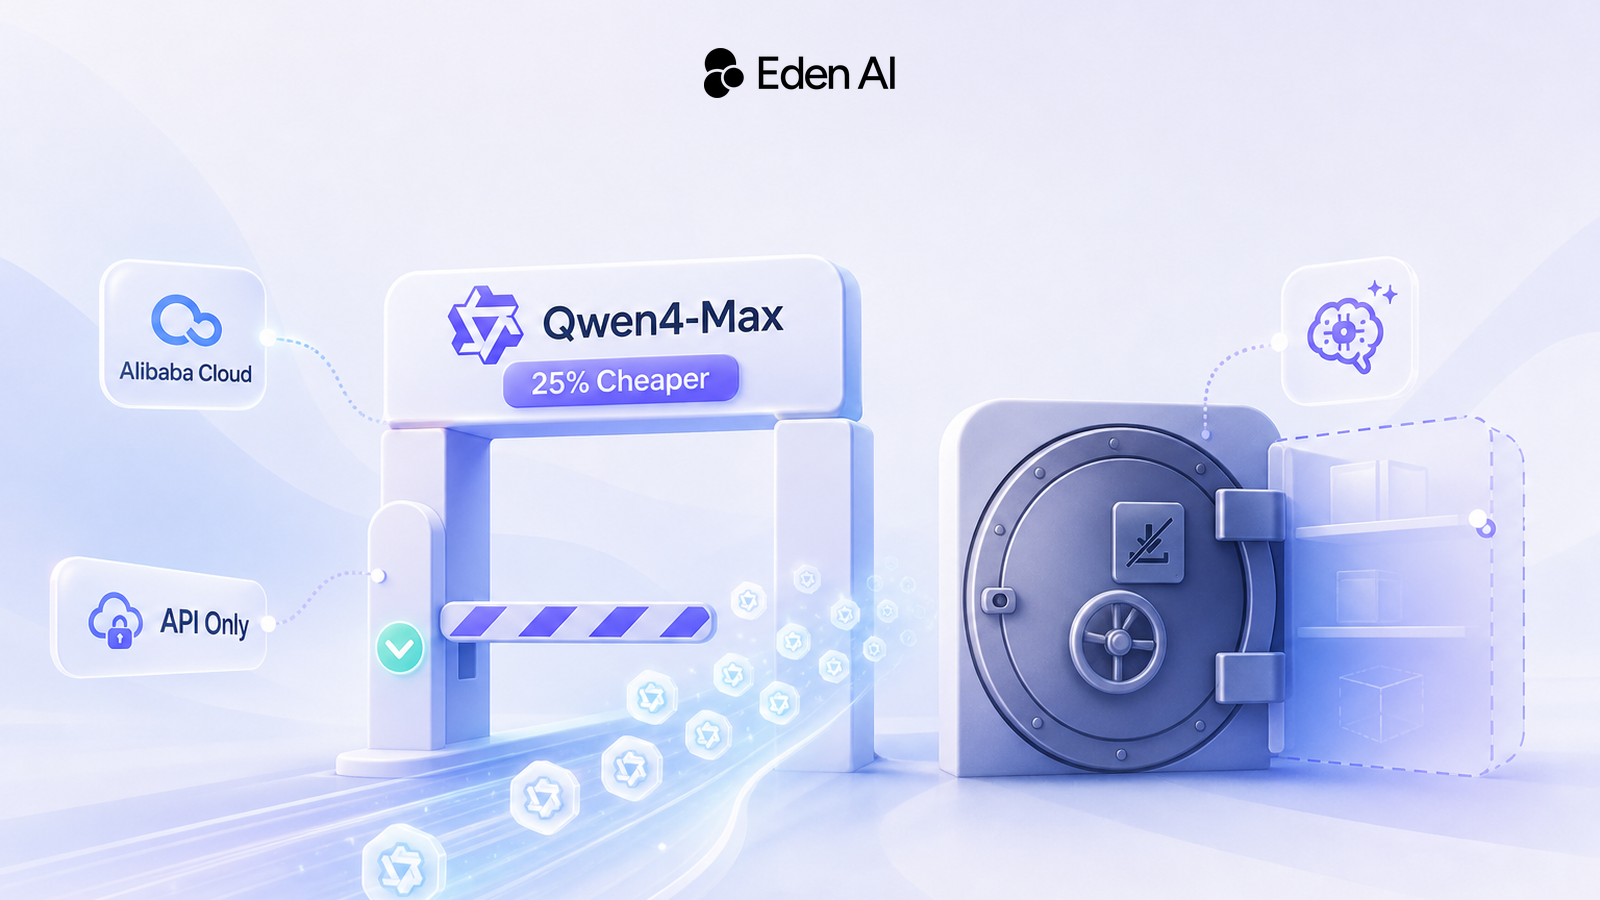
Alibaba a lancé Qwen4-Max le 16 novembre 2026. Sur la grille tarifaire internationale d’Alibaba, le token coûte 25 % de moins qu’avec Qwen3.8-Max. Le raisonnement est activé par défaut et facturé comme de la sortie. Contrairement à la génération précédente, aucun poids du modèle phare n’est téléchargeable. Cet article détaille les nouveautés, ce que montrent les benchmarks, le coût d’une requête et les profils qui ont intérêt à migrer.
Alibaba a lancé Qwen4-Max le 16 novembre 2026, sous l’identifiant qwen4-max. Sur la grille internationale d’Alibaba, il coûte 1,50 $ / 4,50 $ par million de tokens en entrée / sortie, soit 25 % de moins que Qwen3.8-Max. Le raisonnement est activé par défaut, et le modèle phare est livré sans poids téléchargeables.
Le compromis est bien réel. Les utilisateurs de l’API profitent de tokens moins chers et de lectures en cache bon marché. Les équipes qui auto-hébergent perdent en revanche l’option qu’offrait la génération précédente avec Qwen3.8-2.4T-A95B, un modèle ouvert limité au texte. La réflexion est en outre facturée comme de la sortie : vos économies dépendent donc du niveau d’effort de raisonnement et des limites de tokens que vous fixez.
Cet article passe en revue les points clés, les changements par rapport à Qwen3.8-Max, ce que montrent les benchmarks, le coût d’une requête et les profils qui ont intérêt à migrer.
Qwen4-Max en bref
| Sortie | 16 novembre 2026, par Alibaba |
|---|---|
| Architecture | MoE de 2 400 milliards de paramètres, dont 71 milliards actifs par token |
| Contexte | 1 000 000 tokens (inchangé) |
| Entrées et sortie | Texte, image et vidéo en entrée ; texte en sortie (inchangé) |
| Raisonnement | Activé par défaut au niveau high ; niveaux low, high, xhigh |
| Limite de sortie | 262 144 tokens, réflexion et réponse comprises |
| Prix international | 1,50 $ / 4,50 $ par million de tokens en entrée / sortie |
| Poids | Non publiés ; accès par API uniquement |
Alibaba conserve l’architecture en mélange d’experts (MoE) à 2 400 milliards de paramètres de Qwen3.8-Max. Selon le South China Morning Post, Qwen4-Max active 71 milliards de paramètres par token, contre 95 milliards pour Qwen3.8-Max. La synthèse de lancement de Yotta Labs mentionne en outre 328 milliards de paramètres d’embeddings n-grammes, ainsi qu’un mécanisme Qwen Sparse Attention associé à des couches Gated DeltaNet. Un nombre réduit de paramètres actifs ne garantit pas à lui seul des réponses plus rapides.
Ce qui change par rapport à Qwen3.8-Max
| Caractéristique | Qwen4-Max | Qwen3.8-Max | Ce que cela implique |
|---|---|---|---|
| Entrée / sortie par million de tokens | 1,50 $ / 4,50 $ | 2,00 $ / 6,00 $ | Prix catalogue 25 % plus bas |
| Paramètres actifs | 71 milliards | 95 milliards | Gain de vitesse non démontré |
| Raisonnement | Activé par défaut (high) | Effort configurable | Les budgets de sortie doivent inclure la réflexion |
| Poids ouverts | Aucun pour le modèle phare | Qwen3.8-2.4T-A95B, texte uniquement | Qwen4-Max n’est accessible que par API |
| Contexte et entrées | 1M ; texte, image, vidéo | 1M ; texte, image, vidéo | Aucun changement |
Sources : documentation qwen4-max d’Alibaba Cloud, Yotta Labs, SCMP et fiche du modèle Qwen3.8-2.4T-A95B. Prix internationaux (Singapour), vérifiés le 17 novembre 2026.
Le changement le plus important concerne la distribution. La fiche du modèle Qwen3.8-2.4T-A95B propose des poids téléchargeables pour un modèle limité au texte, qui raisonne systématiquement. L’entrée visuelle et un mode sans réflexion n’étaient disponibles qu’avec la version hébergée Qwen3.8-Max. Selon Yotta Labs, Alibaba affirme que des modèles Qwen4 plus petits seront publiés en open source, sans avancer ni noms ni dates.
Alibaba a aussi renforcé la sécurité. Selon le SCMP, l’entreprise a retiré des données d’entraînement les capacités de cyberattaque offensive, tout en conservant la détection de vulnérabilités. Elle a également ajouté, lors du post-entraînement, des mesures d’atténuation des risques chimiques, biologiques, radiologiques et nucléaires (NRBC).
Ce que montrent les benchmarks
La quasi-totalité des chiffres publiés provient des supports de lancement d’Alibaba. Ils traduisent un net progrès par rapport à Qwen3.8-Max, sans faire du modèle le leader toutes catégories.
Sur Work360, un nouveau benchmark d’Alibaba couvrant 721 domaines professionnels spécialisés, Qwen4-Max obtient 52,69 contre 47,74. Le coût moyen par tâche recule de 62 %, de 4,43 $ à 1,67 $. Alibaba a conçu ce test et l’a exécuté sur sa propre charge de travail. Selon Yotta Labs, Alibaba attribue cette baisse au tarif réduit et à une consommation de tokens moindre : environ 24 % de moins en effort xhigh et 35 % de moins en effort high.
| Benchmark | Qwen4-Max | Qwen3.8-Max | Meilleur score du graphique |
|---|---|---|---|
| DeepSWE v1.1 (code agentique) | 75,7 | 69,3 | Qwen4-Max, 75,7 |
| HLAB-Vals-1.1 (agents juridiques) | 21,3 | 15,4 | Qwen4-Max, 21,3 |
| Terminal-Bench 4.0 (code en terminal) | 48,5 | 38,9 | Kimi K3.1, 67,2 |
| ProgramBench (réplication logicielle) | 31,5 | 28,0 | Claude Opus 5.5, 65,0 |
| Humanity's Last Exam | 51,7 | 43,9 | Claude Opus 5.5, 59,8 |
Source : graphique de lancement d’Alibaba du 16 novembre 2026, rapporté par Yotta Labs. Qwen3.8-Max correspond à la version 0902. Les paramètres varient selon les lignes.
D’après le décompte de Yotta Labs, Qwen4-Max devance Qwen3.8-Max sur les 15 benchmarks où les deux modèles ont un score. Il obtient le meilleur score sur 4 des 16. Il reste nettement derrière les leaders en code dans le terminal et sur ProgramBench. Selon les notes de bas de page d’Alibaba, plusieurs lignes proviennent de classements tiers comme Artificial Analysis et Vals, les autres ayant été mesurées par Alibaba elle-même.
Les résultats indépendants restent rares. Artificial Analysis attribue à Qwen4-Max un score de 43 sur son Intelligence Index au 16 novembre, avec un coût moyen de 3,27 $ par tâche sur ce test. Celui-ci repose sur une charge de travail différente de Work360 : les deux coûts ne sont donc pas comparables.
Notre comparatif Kimi K3 vs Qwen 3.8-Max porte sur la génération précédente. Pour comparer à armes égales, soumettez des tâches représentatives à chaque modèle, avec les mêmes prompts, les mêmes outils et les mêmes limites de sortie.
Prix et disponibilité
Qwen4-Max est accessible par plusieurs canaux :
- Alibaba Cloud Model Studio et l’API à la consommation de QwenCloud
- Le Token Plan, fondé sur des crédits
- Les applications QwenWork, Qoder et QwenStudio d’Alibaba
L’API accepte les formats Chat Completions et Responses d’OpenAI, ainsi que les formats Messages d’Anthropic et DashScope. La limite par défaut est de 5 000 000 tokens par minute.
Les prix varient selon la région. La grille de Singapour (internationale) affiche 1,50 $ / 4,50 $ par million de tokens en entrée / sortie. Pékin et les régions globales (Francfort, Hong Kong, Tokyo, Virginie) affichent 1,413 $ / 4,24 $. L’offre à la consommation de Singapour inclut aussi un quota gratuit d’un million de tokens, valable 90 jours.
| Poste (grille de Singapour) | Prix par million de tokens | Exemple |
|---|---|---|
| Entrée | 1,50 $ | Prompt de 500 000 tokens : 0,75 $ |
| Entrée en cache (lecture) | 0,075 $ | Même prompt depuis le cache : 0,0375 $ |
| Écriture en cache | 1,875 $ (5 min) / 3,00 $ (1 h) | Pour les points de cache explicites |
| Sortie, réflexion comprise | 4,50 $ | Budget complet de 262 144 tokens : environ 1,18 $ |
Sources : documentation qwen4-max d’Alibaba Cloud et Yotta Labs. Exemples calculés à partir des prix catalogue. Vérifié le 17 novembre 2026.
La réflexion est facturée comme de la sortie et activée par défaut. Le thinking_budget par défaut s’élève à 131 072 tokens : une requête qui l’utilise entièrement paie donc environ 0,59 $ de raisonnement avant même la réponse. Dans Chat Completions, max_tokens équivaut désormais à max_completion_tokens. Ce paramètre plafonne à la fois la réflexion et la réponse : jusqu’à 262 144 tokens avec la réflexion activée, 131 072 sans. Une limite calibrée pour la seule réponse risque de tronquer le résultat.
La baisse de tarif de 25 % n’explique qu’une partie des 62 % d’économies mesurées sur Work360. Le reste dépend du nombre de tokens consommés par le modèle : vous n’obtiendrez cette économie que si vos tâches se comportent comme celles d’Alibaba.
Si vous avez testé la préversion, sachez que qwen4-max-preview est un identifiant de modèle distinct. Il n’est accessible que via le Token Plan, du 11 novembre au 25 novembre 2026 à 24 h (UTC+8). Il utilisait par défaut l’effort xhigh et autorisait 393 216 tokens en sortie. Alibaba recommande de passer au modèle de production.
Faut-il passer à Qwen4-Max ?
Migrez si un accès hébergé vous convient et si votre charge de travail repose sur le raisonnement ou sur du contexte répété. En revanche, ne migrez pas uniquement pour le contexte d’un million de tokens ou l’entrée vidéo : Qwen3.8-Max offrait déjà les deux.
Décision selon la charge de travail
Qui a intérêt à adopter Qwen4-Max
Auto-hébergement
Restez sur Qwen3.8
Aucun poids du modèle phare Qwen4 n’est disponible. Qwen3.8-2.4T-A95B, limité au texte, reste l’option téléchargeable, et aucune date n’a été annoncée pour les modèles Qwen4 ouverts plus petits.
Contexte répété
Testez le cache moins cher
À 0,075 $ par million de tokens d’entrée en cache, les documents récurrents, les prompts système et les définitions d’outils reviennent beaucoup moins cher. Mesurez votre taux réel de succès du cache.
Raisonnement à budget serré
Réglez l’effort et les limites
Choisissez low, high ou xhigh selon la tâche et plafonnez max_tokens. Avec l’effort high activé par défaut, la réflexion peut devenir le premier poste de la facture.
Agents de code
Testez vos propres tâches
Le graphique d’Alibaba place Qwen4-Max en tête sur DeepSWE, mais loin derrière le leader sur Terminal-Bench 4.0. Testez avec des dépôts, des outils et des délais d’expiration fixes.
Outils de sécurité
Vérifiez les garde-fous
Selon le SCMP, la détection de vulnérabilités est conservée, mais les capacités offensives ont été retirées des données d’entraînement. Testez vos workflows de sécurité autorisés avant de migrer.
Secteurs réglementés
Examinez les conditions d’hébergement
Qwen4-Max ne fonctionne que sur le service hébergé d’Alibaba, à Singapour, à Pékin ou dans les régions globales. Examinez les contrôles sur les données, le choix de la région et les nouvelles restrictions NRBC.
Un prix catalogue plus bas ne représente qu’une partie de la facture. Notre guide pour réduire les coûts des API de LLM aborde les limites de sortie, le cache et le routage. Pour évaluer ce que coûte le renoncement à l’auto-hébergement, consultez notre article sur les modèles ouverts face aux modèles propriétaires.
Se préparer avec Eden AI
Une passerelle s’intercale entre votre code et les fournisseurs de modèles : changer de modèle devient alors une simple modification de configuration. Eden AI vous donne une seule clé API et un seul endpoint compatible OpenAI pour plus de 1 000 modèles d’IA, des LLM à l’OCR, en passant par la parole et l’image. Vous pouvez lister les modèles et leurs capacités via l’API : vérifiez donc quels identifiants Qwen4 sont disponibles avant d’en coder un en dur.
La portabilité a ses limites. Un même code client ne rend pas identiques, d’un modèle à l’autre, les réglages de raisonnement, le comportement en matière de sécurité ou l’appel d’outils. Les limites des fournisseurs évoluent aussi. Le plafond de sortie de Qwen4-Max est ainsi passé de 393 216 tokens en préversion à 262 144 au lancement. Notre article sur les limites propres à chaque fournisseur revient sur ce type de changement.
Python
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_EDENAI_API_KEY",
    base_url="https://api.edenai.run/v3",
)

# Find Qwen4 model IDs in the live catalog
qwen4_ids = [m.id for m in client.models.list().data if "qwen4" in m.id.lower()]
print(qwen4_ids)

if qwen4_ids:
    response = client.chat.completions.create(
        model=qwen4_ids[0],
        messages=[{"role": "user", "content": "Summarize this specification in five bullets."}],
        max_tokens=4000,  # on Alibaba's API, this caps thinking and answer together
    )
    print(response.choices[0].message.content)
En production, configurez un fallback automatique vers des modèles de secours, afin qu’une limite de débit ou une panne chez un fournisseur n’interrompe pas votre application. Le prix de chaque modèle figure dans le catalogue : consultez-le avant de basculer votre trafic.
À retenir
- Pas d’auto-hébergement : Qwen4-Max n’est accessible que par API. Ni les noms, ni les tailles, ni les dates, ni les licences des futurs modèles Qwen4 ouverts plus petits n’ont été annoncés.
- Des économies chiffrées par Alibaba : la baisse de 62 % du coût par tâche provient de Work360, le benchmark maison d’Alibaba.
- La réflexion est facturée comme de la sortie : l’effort high et un budget de réflexion de 131 072 tokens sont les valeurs par défaut. Réglez vous-même l’effort et
max_tokens. - Peu de données indépendantes : le graphique de lancement mélange les mesures d’Alibaba et des classements tiers. Le score de 43 attribué par Artificial Analysis reste à ce jour le principal chiffre indépendant.
- Des prix qui varient selon la région : Singapour, Pékin et les régions globales appliquent des grilles tarifaires différentes.
FAQ
Quand Qwen4-Max est-il sorti ?
Les poids de Qwen4-Max sont-ils ouverts ?
Combien coûte l’API Qwen4-Max ?
Le raisonnement est-il activé par défaut dans Qwen4-Max ?
Quelle est la taille de la fenêtre de contexte de Qwen4-Max ?
Qwen4-Max accepte-t-il la vidéo en entrée ?
Peut-on utiliser Qwen4-Max pour la cybersécurité ?
Comment savoir si Qwen4-Max est disponible sur Eden AI ?
Pour aller plus loin
- Documentation Qwen4-Max d’Alibaba : capacités par région, paramètres de raisonnement, prix et limites de débit.
- Documentation de la préversion Qwen4-Max : dates de la préversion, accès via le Token Plan et limites de sortie.
- Synthèse de Yotta Labs sur Qwen4-Max : graphique complet des benchmarks d’Alibaba, prix du cache et formules du Token Plan.
- Fiche du modèle Qwen3.8-2.4T-A95B : poids ouverts, architecture et options de déploiement de la génération précédente.
- Kimi K3 vs Qwen 3.8-Max : benchmarks, prix et accès API du précédent modèle phare Qwen.
- Les modèles Qwen sur Eden AI : notre précédente annonce sur les tarifs des modèles Qwen.