Résumez cet article avec :
Google a rendu Gemini 4 Hydrogen (gemini-4-hydrogen) disponible en version générale le 12 novembre 2026. C'est le modèle d'exécution de la famille Gemini 4 et la suite logique pour les utilisateurs de Gemini 3.8 Flash. Facturé 1,50 $ / 7,50 $ par million de tokens en entrée / sortie, il ajoute un niveau de réflexion xhigh et une offre gratuite. Selon Google, il obtient 51 à l'Artificial Analysis Intelligence Index, soit un point de plus qu'Argon. Cet article détaille ce qui change par rapport à Flash, le coût par tâche réussie, le bon moment pour migrer et la façon de s'y préparer avec Eden AI.
Google a rendu Gemini 4 Hydrogen disponible en version générale le 12 novembre 2026. Le changelog de l'API Gemini le référence sous l'identifiant gemini-4-hydrogen, au tarif de 1,50 $ / 7,50 $ par million de tokens en entrée / sortie. Google le présente comme le modèle d'exécution rapide de la famille Gemini 4 et comme la suite logique de Gemini 3.8 Flash.
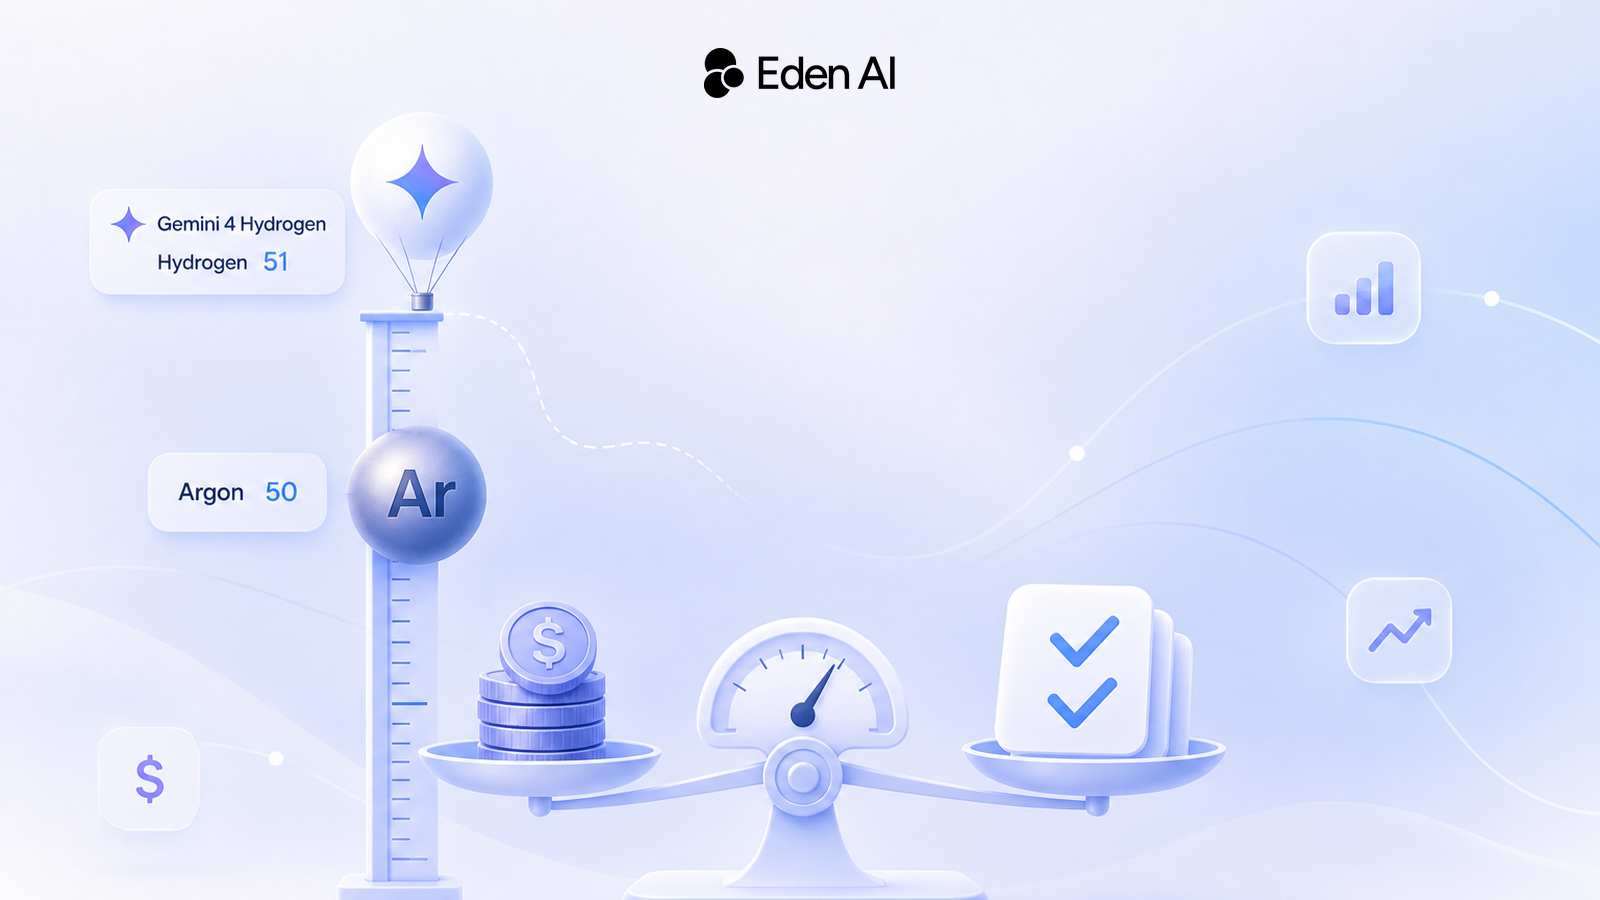
La surprise se trouve dans les benchmarks. Google annonce pour Hydrogen un score de 51 à l'Artificial Analysis Intelligence Index avec son niveau de réflexion par défaut, high, et de 54 avec le nouveau niveau xhigh. Gemini 4 Argon, l'un des modèles de pointe de Google, obtient 50. Il s'agit toutefois d'un seul indice agrégé : rien ne prouve qu'Hydrogen égale Argon sur vos propres cas d'usage.
Pour les utilisateurs de Flash, la vraie question est celle du coût par tâche réussie, car le token Hydrogen coûte aujourd'hui deux fois plus cher que celui de Flash. Cet article passe en revue ce qui change, ce que cela coûte, le bon moment pour migrer et les cas où Argon ou Carbon restent plus adaptés.
Gemini 4 Hydrogen en bref
| Statut | Disponible en version générale depuis le 12 novembre 2026 |
|---|---|
| Identifiant du modèle | gemini-4-hydrogen |
| Niveaux de réflexion | Low, medium, high (par défaut) et le nouveau xhigh |
| Tarif standard | 1,50 $ / 7,50 $ par million de tokens en entrée / sortie |
| Fenêtre de contexte | 1 million de tokens, à tarif unique |
| Entrées | Texte, code, images, audio, vidéo et PDF |
| Sorties | Texte ; pas de génération d'images ni d'audio |
| Accès développeurs | API Gemini, Google AI Studio (offre gratuite incluse), Android Studio |
Google destine Hydrogen au développement courant et à l'exécution agentique, seul ou associé à Carbon ou Argon dans le rôle de planificateur. Il traite texte, code, images, audio, vidéo et PDF dans une même fenêtre de contexte. Selon Google, il accepte nativement 1 million de tokens en entrée et peut en produire jusqu'à 1 million en sortie.
Hydrogen tourne aussi dans l'application Gemini et dans Google Search, mais il s'agit d'interfaces grand public, pas de points d'accès pour les développeurs. Pour les utilisateurs de l'API, le changelog apporte une précision : Hydrogen devient le modèle par défaut de l'agent Antigravity dans Gemini Managed Agents.
Hydrogen face à 3.8 Flash et Argon
Hydrogen prend la relève de 3.8 Flash, dernier représentant d'une gamme Flash que nous avions analysée avec Gemini 3.6 Flash. Les chiffres publiés par Google montrent un net bond par rapport à Flash et une courte avance sur Argon, sur un seul indice.
| Mesure | Hydrogen | Gemini 3.8 Flash | Gemini 4 Argon |
|---|---|---|---|
| Intelligence Index | 51 en high, 54 en xhigh | Non communiqué | 50 |
| Terminal-Bench 4.1 | 57 % | 18,2 % | Non communiqué |
| Vitesse de réalisation des tâches | 2,5× plus rapide que Flash, en high | Référence | Non communiqué |
| Affirmations inventées | Plus de 5× moins que Flash | Référence | Non communiqué |
Sources : annonce de Gemini 4 Hydrogen par Google et page de tarification de l'API Gemini, toutes deux datées du 12 novembre 2026. Vérifié le 13 novembre 2026. Tous les chiffres proviennent de Google.
Ces chiffres sont ceux de Google. L'Intelligence Index agrège de nombreuses évaluations : un point d'avance sur Argon ne dit pas grand-chose du code, de la planification, de l'usage d'outils ou de la latence sur une charge de travail donnée.
Le chiffre de 2,5× porte sur la vitesse de réalisation des tâches au niveau high par défaut. Il ne s'agit ni du délai avant le premier token, ni du débit, ni de la latence des requêtes. Google indique aussi que, lors des premiers tests sur des workflows d'entreprise portant sur des graphes, du SQL et de gros volumes de données, des partenaires ont vu Hydrogen aller 2 à 2,8× plus vite que 3.8 Flash tout en consommant 12 % à 23 % de tokens en moins.
Côté sécurité, Google affirme qu'Hydrogen réduit jusqu'à 81 % les excès d'initiative dans les tâches agentiques par rapport à Flash. Face à des tâches impossibles ou bloquées, il serait jusqu'à 2× moins enclin à contourner les limites d'autorisation. Il atteint enfin un taux d'honnêteté de 96,7 % sur l'évaluation interne de Google consacrée à l'honnêteté des agents.
Tarifs et disponibilité
| Formule | Entrée par million | Sortie par million | Usage |
|---|---|---|---|
| Standard | 1,50 $ | 7,50 $ | Trafic de production courant |
| Entrée en cache | 0,075 $ | Sans objet | Prompts répétés |
Source : page de tarification de l'API Gemini. Prix vérifiés le 13 novembre 2026.
Le prix de sortie inclut les tokens de réflexion, et les tarifs restent identiques sur toute la fenêtre de contexte. Pour obtenir le coût par tâche réussie, additionnez pour chaque tentative (entrée hors cache × 1,50 $ + entrée en cache × 0,075 $ + tokens de sortie et de réflexion × 7,50 $) ÷ 1 000 000, puis divisez le total par le nombre de tâches réussies.
Face à Flash, le calendrier compte. Gemini 3.8 Flash coûte 0,75 $ / 3,75 $ par million de tokens en entrée / sortie jusqu'au 31 décembre 2026 : le token Hydrogen est donc aujourd'hui deux fois plus cher. Au 1er janvier 2027, Flash passe à 1,50 $ / 7,50 $, soit le même tarif qu'Hydrogen.
Prenons le chiffre avancé par les partenaires de Google, 12 % à 23 % de tokens en moins. Au double du tarif, Hydrogen reviendrait encore à environ 1,5 à 1,8 fois le coût de Flash par tâche jusqu'au 31 décembre, à taux de réussite égal. À partir du 1er janvier, ces mêmes économies de tokens rendraient Hydrogen moins cher par tâche.
Face à Argon, les tarifs d'Hydrogen sont inférieurs de 25 % au prix de lancement d'Argon, 2 $ / 10 $, valable jusqu'au 30 novembre 2026. À partir du 1er décembre, Argon passe à 4 $ / 20 $ et l'écart grimpe à 62,5 %.
L'entrée en cache coûte aujourd'hui 0,075 $ par million de tokens, sur Hydrogen comme sur Flash. Mais Hydrogen ne prend en charge que le cache implicite : le cache explicite n'est pas disponible au lancement. Si votre application Flash crée des caches explicites, anticipez ce point avant de basculer.
Hydrogen est aussi le premier modèle Gemini 4 proposé avec une offre gratuite dans Google AI Studio et l'API Gemini. Argon et Carbon exigent une facturation payante. La page de tarification de Google décrit cette offre gratuite comme un accès limité, et les contenus qui y transitent servent à améliorer les produits Google. Ce n'est pas le cas des contenus de l'offre payante.
Faut-il migrer vers Hydrogen ?
Migrez les charges de travail pour lesquelles Hydrogen réduit votre coût par tâche réussie, pas celles où il paraît seulement moins cher ou plus performant sur le papier. Nouvelles tentatives, tokens de réflexion, appels d'outils et échecs comptent tous.
Choix du modèle
Une recommandation par situation
Utilisateurs de Flash
Testez le coût par tâche réussie
Rejouez sur les deux modèles des tâches représentatives de code et d'usage d'outils. Avant le 1er janvier 2027, Hydrogen doit économiser assez de tentatives et de tokens pour compenser un prix au token deux fois plus élevé.
Utilisateurs d'Argon
Ne changez pas pour un point d'indice
Comparez qualité, latence et prix sur vos propres tâches. Le prix plus bas d'Hydrogen justifie un test, mais ne prouve pas qu'il peut remplacer Argon.
Utilisateurs de Carbon
Gardez Carbon pour la planification
Google présente Hydrogen comme l'exécutant qui intervient une fois qu'un modèle plus puissant a établi le plan. Notre analyse de Gemini 4 Carbon détaille les tarifs et les résultats du planificateur.
Gros volumes
Commencez par le batch
La page de tarification de Google mentionne une réduction de 50 % pour la Batch API sur l'offre payante, adaptée aux traitements différés. Vérifiez les conditions des modes flex et priority avant de les utiliser pour des agents interactifs.
Sensibles à la latence
Mesurez chaque niveau de réflexion
Les niveaux low ou medium peuvent mieux convenir aux interactions courtes que le niveau high par défaut. Aucune mesure indépendante de latence par niveau n'existe encore : faites les vôtres.
Offre gratuite
Prototypez, ne déployez pas
L'offre gratuite est utile pour une première évaluation. Ses contenus servent à améliorer les produits Google : réservez les données de production ou sensibles à l'offre payante.
Comment tester la bascule
Test de migration pour les utilisateurs de Flash
- Figez le jeu de tâches. Mêmes prompts, outils, fichiers, paramètres et critères de réussite pour les deux modèles.
- Testez les quatre niveaux de réflexion. Low, medium, high et xhigh, sans rien changer d'autre.
- Comptabilisez chaque token facturé. Entrée hors cache, entrée en cache, sortie visible et tokens de réflexion.
- Suivez les résultats, pas les appels. Réussites, nouvelles tentatives, échecs et durée réelle par tâche.
- Vérifiez le cache explicite. Repérez tout code qui crée des caches explicites avant de basculer.
- Migrez charge par charge. Ne basculez que les types de tâches dont le coût par réussite baisse.
Pour les méthodes de mesure d'un fournisseur à l'autre, nos benchmarks de latence des API LLM expliquent quoi mesurer et comment.
Orchestrator est une fonctionnalité d'Antigravity
Dans Google Antigravity, le nouvel Orchestrator alterne au sein d'une même session entre Carbon pour la planification et Hydrogen pour l'exécution. Google annonce un taux de réussite proche de celui de Carbon, avec en moyenne 24 % de quota consommé en moins et une exécution 19 % plus rapide. L'annonce de Google attribue ce test à Terminal-Bench 4.0, l'article d'Antigravity à la version 4.1 : ne le comparez donc pas aux 57 % obtenus par Hydrogen seul.
Orchestrator est une option de modèle dans Antigravity, pas un paramètre de l'API Gemini. Selon l'article d'Antigravity, l'Antigravity SDK permet de connecter Hydrogen et Carbon entre eux. Avec la seule API Gemini, c'est à vous de construire la répartition entre planificateur et exécutant.
Se préparer avec Eden AI
Eden AI vous donne une seule clé API et un seul endpoint compatible OpenAI pour accéder à plus de 1 000 modèles d'IA, des LLM à l'OCR en passant par la voix et l'image. Avant d'envoyer du trafic vers gemini-4-hydrogen, vérifiez qu'il figure bien dans le catalogue accessible à votre clé. Vous pouvez lister les modèles et leurs capacités via l'API, et le prix de chaque modèle est indiqué dans le catalogue.
L'exemple ci-dessous utilise l'endpoint compatible OpenAI. Il choisit Hydrogen si le catalogue le propose, se rabat sinon sur Gemini 3.8 Flash, et s'arrête plutôt que d'appeler un modèle absent. Il affiche aussi la consommation de tokens, utile pour calculer votre coût par tâche.
Python
from openai import OpenAI

client = OpenAI(
    base_url="https://api.edenai.run/v3",
    api_key="YOUR_EDENAI_API_KEY",
)

# Model IDs available to your key right now
available = [m.id for m in client.models.list()]

# Preferred order: Hydrogen if listed, else your current Flash model
preferences = ["gemini-4-hydrogen", "gemini-3.8-flash"]
model = next(
    (m for p in preferences for m in available if m.endswith(p)),
    None,
)
if model is None:
    raise SystemExit("Neither model is listed. Keep your current setup.")

response = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "Summarize this diff in three bullets: ..."}],
)
print(model, response.usage)
Une fois Hydrogen disponible, vous pouvez ajouter un fallback automatique vers des modèles de secours. Le routage par fournisseur vous permet aussi de fixer l'ordre des fournisseurs ou de les trier par prix, vitesse ou latence. Ce mécanisme sélectionne modèles et fournisseurs requête par requête : ce n'est pas l'Orchestrator Carbon-Hydrogen d'Antigravity.
Dans un agent, un modèle d'exécution a souvent besoin de plus que du texte. Le serveur MCP d'Eden AI met les modèles experts à disposition des agents sous forme d'outils : OCR, analyse de documents, recherche web, etc.
Points de vigilance
- Architecture non divulguée : Google n'a publié ni le nombre total de paramètres d'Hydrogen, ni le nombre de paramètres actifs.
- Pas encore de mesures de vitesse neutres par niveau : aucun chiffre indépendant de latence, de délai avant le premier token ou de débit n'a été publié pour les quatre niveaux de réflexion.
- Lacunes sur le cache et la Live API : le cache explicite n'est pas disponible au lancement, et Google n'a donné aucun calendrier ni pour lui, ni pour la prise en charge de la Live API.
- Des prix qui vont bientôt bouger : les tarifs d'Argon doublent le 1er décembre 2026, ceux de Flash le 1er janvier 2027. Refaites votre comparaison de coûts après chaque changement.
- Accès plus restreint dans Antigravity : selon l'article d'Antigravity, Hydrogen n'y est accessible qu'aux abonnés payants Google AI Pro et Ultra, alors que l'API Gemini propose une offre gratuite.
FAQ
Gemini 4 Hydrogen remplace-t-il Gemini 3.8 Flash ?
Gemini 4 Hydrogen est-il moins cher que Gemini 3.8 Flash ?
Pourquoi Gemini 4 Hydrogen obtient-il un meilleur score qu'Argon ?
Quel niveau de réflexion choisir pour Gemini 4 Hydrogen ?
L'offre gratuite de Gemini 4 Hydrogen est-elle illimitée ?
Orchestrator d'Antigravity fonctionne-t-il via l'API Gemini ?
Gemini 4 Hydrogen prend-il en charge le cache explicite des prompts ?
Gemini 4 Hydrogen peut-il générer des images ou de l'audio ?
Pour aller plus loin
- Analyse du lancement de Gemini 4 Carbon : benchmarks, tarifs et disponibilité du planificateur que Google associe à Hydrogen.
- Benchmarks de latence des API LLM : comment mesurer et comparer la vitesse d'un fournisseur à l'autre.
- Annonce de Gemini 4 Hydrogen par Google : promesses du lancement, benchmarks, résultats de sécurité et accès selon les interfaces.
- Changelog de l'API Gemini : l'entrée GA de gemini-4-hydrogen et les dernières évolutions des modèles Gemini.
- Tarifs de l'API Gemini : prix actuels et à venir pour Hydrogen, Flash, Argon et Carbon.
- Article de Google Antigravity sur Orchestrator : comment Carbon et Hydrogen se partagent une session, et qui y a accès.