Résumez cet article avec :
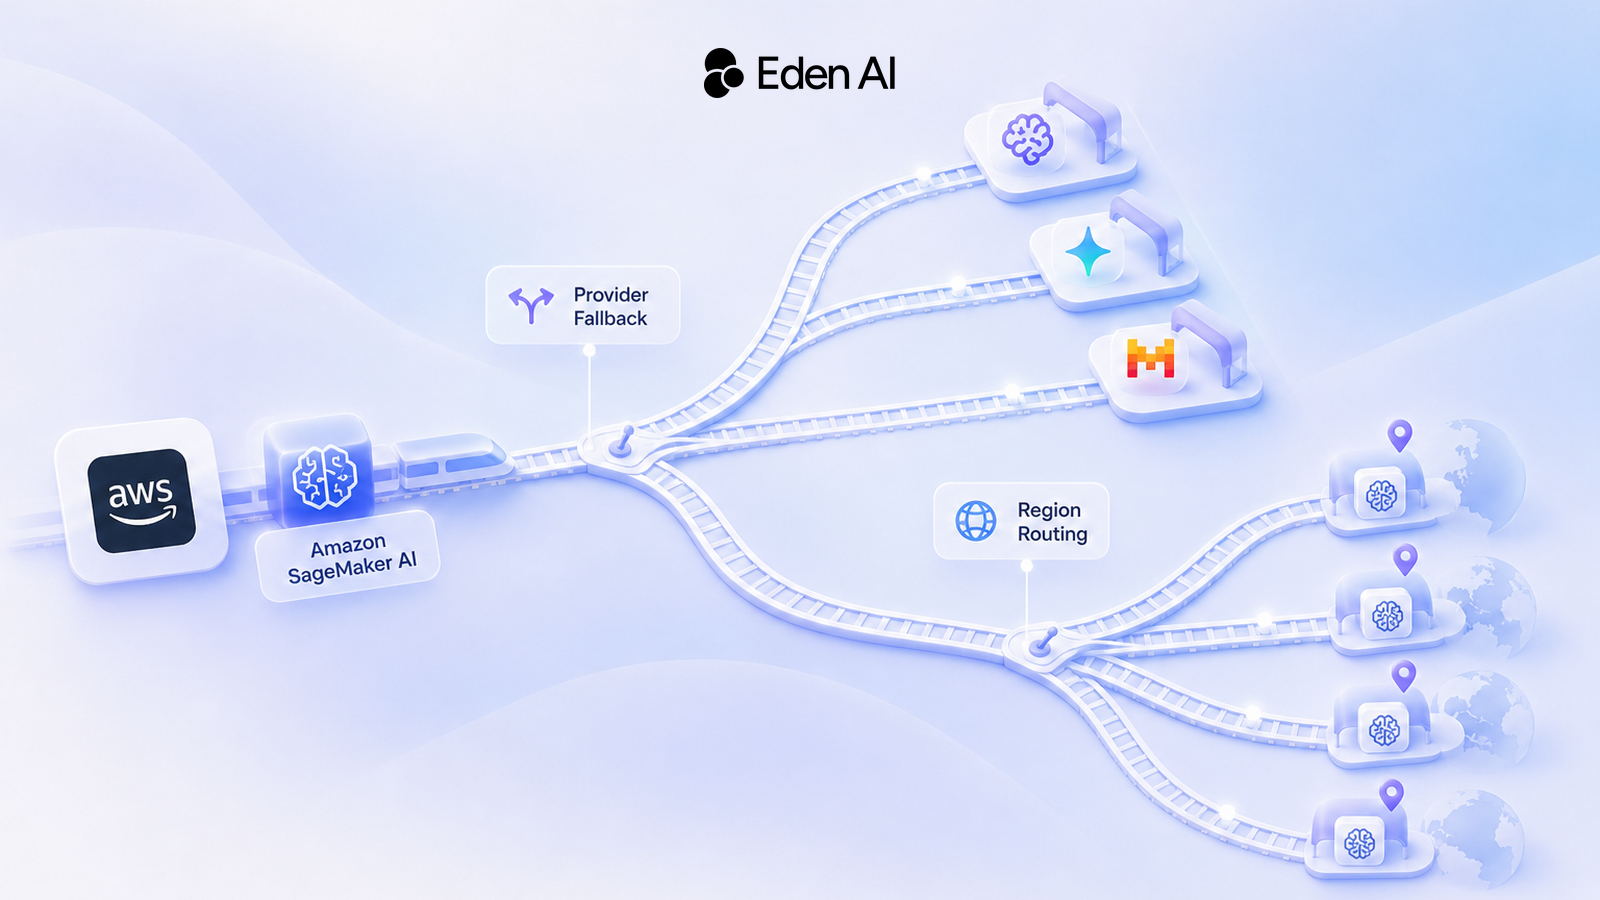
Le 18 novembre 2026, AWS a lancé le routage d’inférence inter-régions pour Amazon SageMaker AI. Il bascule le trafic vers des endpoints SageMaker que vous exploitez déjà dans d’autres régions et d’autres comptes, en cas de panne de la plateforme, de limitation de débit ou d’erreur 5xx du conteneur. Les erreurs client 4xx et les réponses lentes ne le déclenchent pas. Le fallback entre fournisseurs répond à une autre panne : un modèle ou un fournisseur indisponible. Ce comparatif détaille ce que protège chaque couche, ce qui reste à votre charge et quand associer les deux.
Le 18 novembre 2026, AWS a lancé le routage d’inférence inter-régions pour Amazon SageMaker AI. Un routeur d’inférence unique redirige les requêtes vers des endpoints SageMaker que vous exploitez déjà dans d’autres régions et d’autres comptes AWS, lorsque les endpoints locaux tombent en panne ou manquent de capacité. Selon AWS, les équipes devaient jusqu’ici concevoir et maintenir elles-mêmes cette logique de routage, de contrôle de santé et de nouvelles tentatives.
Tout se joue sur ce qui déclenche la bascule. D’après la documentation d’AWS, les pannes de la plateforme, les limitations de débit (throttling) et les erreurs 5xx du conteneur font basculer le trafic. Ce n’est pas le cas des erreurs client 4xx ni des réponses lentes du modèle, et une requête qui expire n’est pas relancée ailleurs.
Ce mécanisme protège vos propres déploiements SageMaker contre les pannes régionales. Il ne couvre pas l’indisponibilité d’un modèle ou d’un fournisseur : c’est le rôle du fallback entre fournisseurs. Cet article compare ces deux couches, ce que chacune vous laisse à gérer et les cas où il faut les combiner.
| Lancement | 18 novembre 2026, par AWS |
|---|---|
| Routage entre | Endpoints SageMaker existants dans d’autres régions et comptes |
| Ordre de routage | Endpoints de la région locale en priorité |
| Bascule le trafic en cas de | Pannes de la plateforme, limitations de débit, erreurs 5xx du conteneur |
| Ne bascule pas en cas de | Erreurs client 4xx, réponses lentes du modèle |
| Disponibilité | 32 régions commerciales (temps réel), 25 (asynchrone) |
| Changement côté client | Nouveau service runtime du routeur et nouvelles API d’invocation |
| Coût du routeur | Aucun ; endpoints et métriques CloudWatch facturés normalement |
Source : AWS, 18 novembre 2026.
Routage inter-régions et fallback entre fournisseurs en un coup d’œil
Le routage SageMaker s’adresse aux équipes qui servent leurs propres modèles, ou des modèles personnalisés, sur des endpoints SageMaker. Le fallback entre fournisseurs compte davantage pour les applications qui appellent des API de modèles managées. Le tableau compare les deux couches et ce que chacune laisse à votre charge.
| Question | Routage SageMaker | Fallback fournisseur | À votre charge |
|---|---|---|---|
| Panne couverte | Panne d’un endpoint régional ou manque de capacité | Indisponibilité d’un modèle ou d’un fournisseur | Associer chaque type de panne à une couche |
| Modèle servi | Le même modèle déployé | Éventuellement un autre modèle | Tester les sorties du modèle de secours |
| Cibles | Endpoints que vous avez déjà déployés | Modèles autorisés par votre politique | Valider chaque cible au préalable |
| Déclencheurs | Pannes de la plateforme, limitations de débit, 5xx du conteneur | Définis par la passerelle ou l’application | Gérer les erreurs 4xx et les réponses lentes |
| Modes de requête | Temps réel et asynchrone | Selon l’implémentation | Vérifier votre mode de requête |
| Périmètre | Régions et comptes choisis, même partition AWS | Fournisseurs et destinations validés | Faire respecter les règles de résidence des données |
| Coût | Pas de frais de routeur ; endpoints et métriques facturés | Selon la tarification des fournisseurs | Budgéter la capacité de réserve |
Source de la colonne SageMaker : AWS, 18 novembre 2026. Vérifié le 19 novembre 2026.
Le routeur lui-même n’entraîne aucuns frais, mais la résilience a un prix. Les endpoints cibles de chaque région sont facturés au tarif standard de SageMaker AI, et les métriques du routeur au tarif standard d’Amazon CloudWatch. Le routeur ne crée jamais de cibles : elles doivent déjà exister.
Comment fonctionne le routage d’inférence inter-régions de SageMaker
Vous créez un routeur d’inférence, vous y enregistrez les endpoints temps réel, les endpoints asynchrones ou les composants d’inférence que vous exploitez déjà, puis vous faites pointer votre application vers ce routeur. Il privilégie les endpoints de sa propre région. Quand les erreurs augmentent, il redirige les nouvelles requêtes vers des destinations saines dans d’autres régions, puis rétablit progressivement le trafic une fois l’endpoint local rétabli.
Les endpoints, les modèles déployés, les conteneurs et le corps des requêtes ne changent pas. Pas plus que ContentType, Accept, CustomAttributes et InferenceId. Le client, lui, évolue : il appelle le service sagemaker-inference-router-runtime au lieu de sagemaker-runtime.
Ce pseudocode illustre le changement. Vérifiez les noms exacts des méthodes du SDK dans le guide du développeur SageMaker AI avant de le reprendre.
Python
# Pseudocode: check method names in the AWS SDK reference

# Before: invoke one endpoint directly
runtime = aws_client("sagemaker-runtime")
runtime.invoke_endpoint(
    EndpointName="my-endpoint",
    Body=payload,
    ContentType="application/json",
)

# After: invoke a routing target through the router
router = aws_client("sagemaker-inference-router-runtime")
router.invoke_inference_router(
    InferenceRouterName="my-router",
    RoutingTargetName="production",
    Body=payload,
    ContentType="application/json",
)
Les clients synchrones appellent InvokeInferenceRouter, les clients asynchrones InvokeInferenceRouterAsync.
Les propriétaires des endpoints gardent la main sur l’usage entre comptes. Une politique basée sur les ressources, avec la condition sagemaker:SourceInferenceRouterArn, détermine quels routeurs d’autres comptes peuvent appeler un endpoint. Un plafond facultatif de trafic inter-régions réserve de la capacité aux appelants locaux de l’endpoint.
Aucun de ces contrôles ne détermine où vont vos données : seules les cibles que vous configurez le font. Les destinations doivent en outre appartenir à la même partition AWS que le routeur : il ne bascule donc pas d’AWS commercial vers AWS GovCloud.
Les pannes qui font basculer le trafic, et celles qui ne le font pas
D’après la documentation d’AWS, le routeur ne relance une tentative échouée sur une autre destination qu’en cas d’erreur pouvant être retentée. C’est le cas d’une limitation de débit, ou d’une erreur 5xx du conteneur survenue avant le début de toute sortie. Les pannes de la plateforme pèsent aussi sur l’état de santé d’une destination.
Les timeouts suivent une autre logique. Une requête qui expire n’est pas relancée, mais des timeouts répétés dégradent l’état de santé de la destination et détournent les requêtes suivantes.
Les erreurs client 4xx et les réponses lentes du modèle ne déclenchent jamais de bascule. Le routage suppose aussi une cible configurée, saine et disposant de capacité libre. Si toutes les cibles sont saturées ou plafonnées, le routeur n’a nulle part où envoyer la requête.
Chaque réponse temps réel indique l’endpoint qui l’a servie ainsi qu’un RoutingReason : local-preferred, capacity-available, only-healthy ou failover. Journalisez ces champs, en complément des métriques du routeur dans Amazon CloudWatch, pour savoir à quelle fréquence le trafic quitte sa région d’origine.
Le fallback entre fournisseurs, au niveau de l’application ou de la passerelle
Le fallback entre fournisseurs couvre une autre panne : celle du modèle ou du fournisseur lui-même. Votre application, ou une passerelle, envoie la requête vers un autre modèle validé lorsque le modèle privilégié est indisponible. Cela peut tenir à une panne, à une limite de capacité, voire à un problème de compte, comme l’explique ce guide sur ce qui se passe quand un fournisseur d’IA vous bannit.
La contrepartie, c’est la cohérence. Le routage SageMaker sert le même déploiement dans une autre région, alors qu’un modèle de secours peut différer par la structure de ses sorties, la prise en charge des outils, son comportement en matière de sécurité, sa latence et sa qualité. Testez chaque modèle de secours selon les mêmes critères d’acceptation que le modèle principal : un format de requête identique ne garantit pas un comportement identique.
Une passerelle s’ajoute en outre au chemin des requêtes. Elle ne corrige ni les requêtes invalides, ni les bugs applicatifs, ni les sorties dangereuses. Comme les données peuvent atteindre un autre fournisseur ou un autre lieu de traitement, définissez les destinations autorisées avant d’activer le fallback automatique.
Les arguments en faveur de cette couche sont détaillés dans notre article expliquant pourquoi ne pas dépendre d’un seul fournisseur d’IA. Pour le travail d’intégration qu’implique le recours à plusieurs fournisseurs, consultez comment gérer une intégration d’IA complexe.
Quelle stratégie de bascule choisir ?
Choisissez la couche qui correspond à la panne à laquelle vous devez résister. Beaucoup de systèmes en production ont besoin des deux.
Recommandations
Adapter la couche de routage à la panne
SageMaker
Modèles personnalisés sur SageMaker
Optez pour le routage inter-régions si le principal risque est un endpoint défaillant ou une région à court de capacité. Déployez, dimensionnez et validez chaque cible au préalable.
Couche fournisseur
API de modèles managées
Optez pour le fallback entre fournisseurs si votre application doit continuer de fonctionner quand un modèle ou un fournisseur devient indisponible. Testez chaque modèle de secours séparément.
Les deux couches
Applications à haute disponibilité
Combinez-les si vous servez des modèles personnalisés sur SageMaker tout en appelant des API managées. Chaque couche couvre des pannes que l’autre ne voit pas.
Gouvernance
Charges de travail soumises à la résidence des données
N’enregistrez comme cibles que des régions et comptes AWS acceptables. Les plafonds de trafic et les politiques d’endpoint ne sont pas des contrôles de résidence. Vérifiez séparément les conditions de traitement de chaque fournisseur externe.
Pour les charges de travail de chat ou de streaming, vérifiez dans le guide du développeur SageMaker AI quels modes de requête le routeur prend en charge avant d’y faire passer du trafic en streaming.
Une architecture de routage à deux couches
Application
Envoie la requête à sa logique de routage ou à sa passerelle.
Couche fournisseur
Choisit une API de modèle managée ou votre modèle SageMaker, avec des solutions de secours validées.
Routeur SageMaker
Pour le trafic SageMaker, choisit un endpoint configuré et sain.
Endpoint de service
Renvoie la réponse avec l’endpoint et le motif de routage.
Journaux
Consignent le fournisseur, l’endpoint et le RoutingReason.
La place d’Eden AI
Eden AI se situe au niveau de la couche fournisseur, pour les API de modèles managées qu’appelle votre application. Avec le routage entre fournisseurs, vous fixez l’ordre des fournisseurs ou vous les classez par prix, vitesse ou latence. Le fallback automatique vers des modèles de secours se règle séparément. Notre article sur les limites de débit et les fallbacks dans les appels à l’API Eden AI montre comment les deux fonctionnent en pratique.
Cette requête définit un ordre explicite de fournisseurs. Configurez les modèles de secours comme indiqué dans la documentation sur le fallback.
Python
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_EDENAI_API_KEY",
    base_url="https://api.edenai.run/v3",
)

response = client.chat.completions.create(
    model="YOUR_PRIMARY_MODEL",
    messages=[
        {"role": "user", "content": "Summarize this incident."}
    ],
    extra_body={
        "routing": {
            "order": ["YOUR_FIRST_PROVIDER", "YOUR_SECOND_PROVIDER"]
        }
    },
)

print(response.choices[0].message.content)
Pour les charges de travail européennes, Eden AI propose un endpoint UE pour la résidence des données en Europe, avec zéro conservation des données sur cet endpoint UE. Il vous appartient toutefois de vérifier que chaque fournisseur autorisé respecte vos propres exigences de traitement.
Eden AI ne déploie pas d’endpoints SageMaker et ne remplace pas le routeur SageMaker. C’est aussi un service de plus sur le chemin des requêtes : il ne supprime donc pas tous les points de défaillance uniques. La résilience régionale de vos modèles personnalisés reste du ressort de SageMaker.
À retenir
- Provisionnez d’abord les cibles : le routage SageMaker exige des destinations déployées, saines et disposant de capacité libre, toutes facturées.
- La latence n’est pas un déclencheur : les réponses lentes ne provoquent jamais de bascule, et une requête expirée n’est pas relancée.
- Vérifiez la couverture : le routage temps réel couvre 32 régions commerciales et le routage asynchrone 25, toutes au sein d’une même partition AWS.
- Validez chaque destination : passez en revue les régions, les comptes, les plafonds de trafic, le comportement des modèles de secours et les politiques de données avant la mise en production.
Mesurez avant de vous y fier
AWS n’a pas publié la latence qu’ajoutent le routeur ou un saut entre régions. Comparez appels directs et appels routés avec vos propres payloads et vos régions cibles avant de fixer vos timeouts.
FAQ
Qu’est-ce qui déclenche le routage inter-régions de SageMaker ?
Une inférence lente déclenche-t-elle la bascule de SageMaker ?
Faut-il modifier le code client pour utiliser le routeur d’inférence SageMaker ?
Les endpoints cibles doivent-ils déjà exister ?
Comment fonctionne le routage entre comptes dans SageMaker ?
Le routeur d’inférence SageMaker prend-il en charge le streaming ?
Combien coûte le routage inter-régions de SageMaker ?
Peut-on combiner le routage SageMaker et le fallback entre fournisseurs ?
Pour aller plus loin
- L’annonce d’AWS sur le routage d’inférence inter-régions : disponibilité, comportement du routage et tarification, de source officielle.
- Faut-il passer au routage SageMaker tenant compte du cache KV ? : une autre fonctionnalité de routage de SageMaker, axée sur l’efficacité de l’inférence.
- Eden AI est disponible sur AWS Marketplace : comment les équipes qui achètent via AWS peuvent accéder à Eden AI.
- Comment gérer une intégration d’IA complexe : ce qui change lorsqu’une application utilise plusieurs services d’IA.
- Que faire quand l’API OpenAI tombe en panne : un cas concret de panne côté fournisseur et la manière de s’y préparer.