Résumez cet article avec :
La nouvelle stratégie de routage KV_AWARE d’Amazon SageMaker AI s’appuie en temps réel sur les événements de stockage et d’éviction remontés par le conteneur vLLM d’AWS. Elle envoie ainsi les prompts répétés vers l’instance qui les garde encore en cache. Ce guide explique ce qui la distingue de PREFIX_AWARE, quels endpoints peuvent l’utiliser et comment l’activer. Il précise aussi ce qu’il faut mesurer avant de l’adopter et la place d’une passerelle comme Eden AI dans l’architecture.
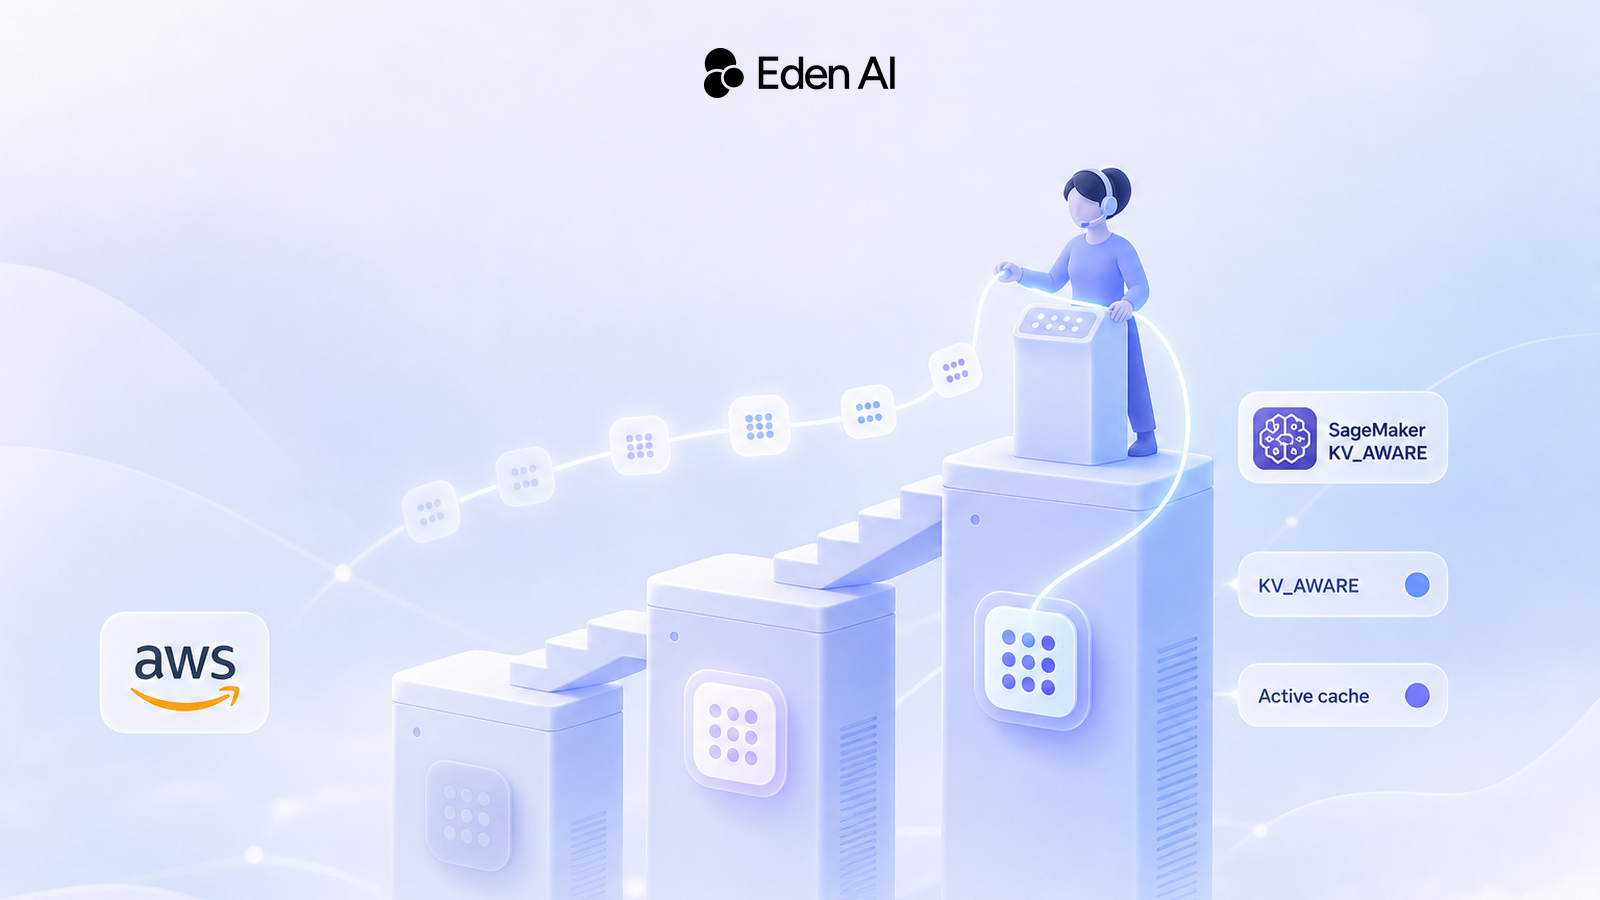
Le 16 novembre 2026, AWS a ajouté le routage sensible au cache KV aux endpoints d’Amazon SageMaker AI dédiés à l’inférence en temps réel. La nouvelle stratégie KV_AWARE envoie chaque requête LLM vers l’instance qui conserve en cache la plus longue portion correspondante de son prompt. Elle s’appuie sur une vue en temps réel des blocs que chaque conteneur vLLM stocke et évince.
Prenons un endpoint RAG ou d’agent réparti sur plusieurs instances GPU. Les requêtes partagent un long prompt système et le même contexte documentaire. Une requête peut arriver sur une instance qui n’a jamais mis ce préfixe en cache, ou qui l’a évincé pour libérer de la mémoire GPU sous la charge. L’instance doit alors le recalculer, et le prompt répété repart à froid.
La nouveauté ne tient pas au cache lui-même, mais à la prise en compte des évictions. AWS affiche comme objectif un temps jusqu’au premier token (TTFT) plus court, sans publier le moindre chiffre de performance. Seul un test sur votre propre trafic vous dira s’il faut basculer. Ce guide distingue les couches de routage en jeu, compare KV_AWARE et PREFIX_AWARE, et vous propose un plan de migration et de mesure.
Trois couches de routage pour trois problèmes différents
Une requête vers un LLM, hébergé par un fournisseur ou par vos soins, peut passer par trois décisions de routage distinctes. Chacune peut, à elle seule, préserver ou faire perdre la réutilisation du cache :
- Passerelle : choisit le fournisseur ou le modèle. La réutilisation est perdue quand une requête bascule vers un autre fournisseur ou un autre modèle.
- Prompt caching du fournisseur : géré côté fournisseur, selon ses propres règles. La réutilisation est perdue quand le préfixe change ou que le cache du fournisseur ne le contient plus.
- Endpoint SageMaker : choisit l’instance ou la copie de composant d’inférence. La réutilisation est perdue quand l’instance choisie n’a pas les blocs ou les a évincés. C’est cette couche que
KV_AWAREmodifie.
La remise qu’accorde un fournisseur au titre du prompt caching et un hit dans le cache KV de votre propre instance sont deux choses différentes. La première est une fonctionnalité de facturation propre à une API hébergée, que nous détaillons dans notre guide du prompt caching pour Claude, GPT et Gemini. La seconde évite des recalculs sur des GPU que vous payez à l’heure. Pour la couche passerelle, consultez notre guide sur l’automatisation du choix de modèle en production. La suite de ce guide porte sur la décision que prend SageMaker au niveau des instances.
Ce qui change entre PREFIX_AWARE et KV_AWARE
PREFIX_AWARE envoie les requêtes qui partagent le même préfixe de prompt vers la même instance ou la même copie de composant d’inférence. Vous réglez la longueur du préfixe et un seuil de concurrence avec PrefixLength et ConcurrencyThreshold, comme l’explique la référence API de PrefixAwareRoutingConfig. Lorsque l’instance ou la copie sélectionnée atteint ce seuil, la requête part ailleurs.
KV_AWARE route en fonction de ce que chaque conteneur contient réellement. D’après la référence de ProductionVariantRoutingConfig, le conteneur vLLM d’AWS signale les blocs de cache qu’il stocke et évince. SageMaker met ensuite en balance la longueur de la correspondance et la charge de chaque instance. AWS conserve les deux stratégies et recommande chacune dans des conditions différentes.
| Critère | PREFIX_AWARE | KV_AWARE |
|---|---|---|
| Signal de routage | Préfixe de prompt partagé, jusqu’à PrefixLength | Plus longue correspondance dans le cache KV actif |
| Prise en compte des évictions | Aucune vue en temps réel des blocs de cache | Suit les blocs stockés et évincés |
| Gestion de la charge | Seuil de concurrence que vous définissez | Met en balance longueur de correspondance et charge de l’instance |
| Configuration | PrefixLength et ConcurrencyThreshold | RoutingStrategy plus une variable d’environnement |
| Usage recommandé par AWS | Prompts partagés stables, prompts courts, charge modérée | Prompts longs, forte charge, mémoire GPU limitée |
Sources : annonce d’AWS (16 novembre 2026) et référence API de SageMaker. Vérifié le 17 novembre 2026.
Ne transmettez pas PrefixAwareRoutingConfig avec KV_AWARE. La référence API précise de ne le spécifier que lorsque RoutingStrategy vaut PREFIX_AWARE.
Quand le routage sensible aux évictions l’emporte sur le routage par préfixe
Le cas le plus favorable est un endpoint multi-instances qui combine des préfixes longs et répétés avec des évictions fréquentes. Une règle de préfixe peut continuer d’envoyer un prompt vers une instance alors que ses blocs utiles ont disparu. KV_AWARE, lui, décide à partir des blocs signalés comme toujours présents.
Comment KV_AWARE choisit une instance
Le conteneur signale les événements de cache
Le conteneur vLLM d’AWS signale les blocs KV qu’il stocke et évince.
SageMaker maintient une vue en temps réel
Le routage s’appuie sur les blocs actuels, et non sur une règle de préfixe fixe.
Une requête arrive
SageMaker cherche les instances ou copies qui détiennent le début de son prompt.
La correspondance est mise en balance avec la charge
La plus longue correspondance est pondérée par la charge de chaque instance.
Fallback si nécessaire
Recherche trop lente, aucune correspondance ou aucune correspondance disponible : la requête est routée comme avec LEAST_OUTSTANDING_REQUESTS.
L’avantage devrait s’amenuiser quand les prompts se répètent rarement ou que les caches évincent peu. Les indications d’AWS sur la stratégie adaptée à chaque niveau de charge restent des recommandations, pas un point de bascule mesuré.
Quelles requêtes peuvent profiter de l’affinité de cache ?
- Prompts système partagés : bons candidats quand les mêmes longues instructions ouvrent de nombreuses requêtes.
- Contexte documentaire stable : bons candidats quand le trafic RAG réutilise le même préfixe documentaire.
- Conversations multitours : à tester, mais la modification de tours précédents, un changement de modèle ou une éviction cassent la réutilisation.
- Prompts ponctuels variés : mauvais candidats, car les débuts de requête diffèrent et reviennent rarement.
Même un bon candidat ne garantit pas un hit. Les blocs doivent encore se trouver sur une instance qui n’est pas surchargée.
Activer KV_AWARE sur SageMaker
Commencez par vérifier les prérequis documentés par AWS. Certains ne sont pas nouveaux : la référence API limite déjà PREFIX_AWARE aux endpoints où au moins deux instances peuvent traiter la requête.
Avant de basculer
- Utilisez le conteneur pris en charge. AWS exige son vLLM Deep Learning Container en version 0.33.0 ou ultérieure.
- Travaillez sur des instances GPU. Les endpoints mono-modèle et les composants d’inférence, adaptateurs LoRA compris, sont pris en charge.
- Prévoyez au moins deux destinations. Utilisez au moins deux instances ou copies de composant d’inférence.
- Activez le signalement des événements de cache. Ajoutez la variable d’environnement de conteneur indiquée dans la documentation de déploiement actuelle d’AWS.
- Supprimez les paramètres propres à PREFIX_AWARE. Ne spécifiez pas PrefixAwareRoutingConfig avec KV_AWARE.
- Mettez à jour vos outils. AWS recommande de passer à la dernière version de l’AWS SDK ou de la CLI.
Le paramètre de routage proprement dit se place sur la variante de production. L’extrait ci-dessous ne montre que cette partie. L’annonce ne donne pas le nom de la variable d’environnement liée aux événements de cache : reprenez la configuration complète du conteneur dans la documentation actuelle d’AWS.
JSON
{
  "RoutingConfig": {
    "RoutingStrategy": "KV_AWARE"
  }
}
Rien ne change côté clients. Selon AWS, vous continuez d’appeler l’endpoint avec les mêmes API SageMaker et les mêmes payloads compatibles OpenAI.
Ce qu’il faut surveiller après la bascule
Menez une comparaison contrôlée. Conservez à l’identique le modèle, le type d’instance, la concurrence, la distribution des prompts et la proportion de préfixes réutilisés. Rejouez ensuite un trafic représentatif sous PREFIX_AWARE puis sous KV_AWARE, et comparez :
- Le TTFT par type de charge : prompts partagés, réutilisation de documents, conversations et requêtes ponctuelles, mesurés séparément.
- Le taux de hit du cache KV : selon AWS, les métriques d’observabilité détaillées l’affichent pour ces endpoints.
- La latence de queue : les percentiles élevés, pas seulement la moyenne.
- Le fallback : si vos métriques l’exposent, la fréquence à laquelle les requêtes contournent la recherche dans le cache.
- Les erreurs et la répartition de la charge : les échecs de requêtes, et une éventuelle concentration de la charge sur certaines instances à cause de l’affinité.
Fixez vos critères de réussite avant de commencer. Par exemple : un TTFT plus bas sur le trafic très répétitif, sans dégradation de la latence de queue ni du taux d’erreur. AWS ne fournit ni benchmark ni seuil de fallback, si bien que vos propres chiffres sont la seule preuve disponible. Notre guide pour benchmarker des LLM sans réécrire votre code explique comment organiser des essais comparables.
Faut-il abandonner PREFIX_AWARE ?
Basculez et testez si votre endpoint correspond au cas documenté et si votre trafic comporte de longs préfixes réutilisables sous contrainte mémoire. Sinon, ne changez rien.
En pratique
Testez KV_AWARE si vous utilisez le vLLM DLC d’AWS en version 0.33.0 ou ultérieure sur au moins deux instances GPU ou copies, avec des préfixes longs et répétés et des évictions fréquentes. Conservez PREFIX_AWARE pour les prompts partagés stables, les prompts courts ou une charge modérée, comme le recommande AWS.
Le cas documenté ne couvre ni les instances CPU, ni les endpoints à instance unique, ni les runtimes autres que le conteneur vLLM d’AWS. Si vous servez vos modèles avec un autre runtime, conservez votre stratégie actuelle tant qu’AWS n’en documente pas la prise en charge.
Ne comptez pas sur des économies. AWS ne facture rien de plus pour le routage lui-même, mais le calcul sous-jacent reste à votre charge, et AWS n’a annoncé aucune baisse de coût liée à KV_AWARE.
Où se situe Eden AI : la couche fournisseur
Eden AI intervient au niveau de la passerelle : une seule clé API et un seul endpoint compatible OpenAI pour tous les LLM de plus de 80 fournisseurs. Eden AI ne voit pas l’état du cache de SageMaker et ne peut pas choisir l’instance SageMaker qui détient vos blocs. Si une partie de votre trafic part vers des fournisseurs hébergés, cette partie a besoin de sa propre politique de cache.
Pour les sessions sensibles à la latence avec des préfixes répétés, gardez un fournisseur stable plutôt que d’en changer à chaque requête. Les options de routage d’Eden AI vous permettent de fixer l’ordre des fournisseurs, ou de les trier par prix, rapidité ou latence. Elles permettent aussi de configurer un fallback automatique vers des modèles de secours. Un ordre fixe maintient une session sur le même fournisseur tant que celui-ci répond correctement. Placez le prompt système partagé en tête et ne le modifiez pas : le fournisseur verra toujours le même préfixe.
Python
from openai import OpenAI

client = OpenAI(
    base_url="https://api.edenai.run/v3",
    api_key="YOUR_EDENAI_API_KEY",
)

# Keep long shared instructions first and identical across requests.
SYSTEM_PROMPT = "You answer questions about our product documentation."

response = client.chat.completions.create(
    model="YOUR_MODEL",  # a model ID from the Eden AI catalog
    messages=[
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": "How do I rotate an API key?"},
    ],
    # Fixed provider order instead of sorting by price or latency.
    extra_body={"routing": {"order": ["PROVIDER_A", "PROVIDER_B"]}},
)
print(response.choices[0].message.content)
Le guide du SDK Python d’OpenAI détaille la configuration. Dans votre application, vous pouvez dériver une clé d’affinité à partir du tenant, du modèle, de la version du préfixe et de l’identifiant de conversation, afin de stabiliser vos choix de routage. Cette clé ne guide que votre code : elle ne crée ni ne transfère aucun hit de cache. Pour le choix des fournisseurs dans son ensemble, consultez notre guide pour bâtir une stratégie multi-LLM fiable.
À retenir
- Les caches restent là où ils ont été calculés : une requête qui arrive sur une instance dépourvue des blocs doit les recalculer.
- Le fallback préserve le service, pas l’affinité : une recherche lente ou sans correspondance envoie la requête vers une instance moins chargée, probablement sans hit de cache.
- Modifier le préfixe casse la réutilisation : changer le prompt système ou l’ordre des documents fait repartir à froid un trafic jusque-là en cache.
- Des détails clés restent inédits : le nom de la variable d’environnement, le seuil de fallback et la prise en charge d’autres runtimes.
- Aucun gain mesuré pour l’instant : AWS n’a publié aucun résultat de TTFT, de débit ou de coût pour
KV_AWARE.
FAQ
KV_AWARE remplace-t-il PREFIX_AWARE ?
Quelle version de conteneur faut-il pour KV_AWARE ?
Le routage KV_AWARE de SageMaker est-il disponible dans ma région AWS ?
Que se passe-t-il quand KV_AWARE ne trouve aucune correspondance dans le cache ?
KV_AWARE réduit-il le coût d’inférence ?
Peut-on utiliser KV_AWARE avec une seule instance ?
Quelles charges de travail ont peu de chances de profiter de KV_AWARE ?
Pour aller plus loin
- L’annonce d’AWS sur le routage sensible au cache KV : prérequis, endpoints pris en charge, fallback, métriques, tarification et disponibilité.
- La référence API de ProductionVariantRoutingConfig : la définition de chaque stratégie de routage par SageMaker.
- La référence API de PrefixAwareRoutingConfig : les paramètres de longueur de préfixe et de concurrence de PREFIX_AWARE.
- Le prompt caching chez Claude, GPT et Gemini : le fonctionnement du cache côté fournisseur et les économies qu’il permet.
- Le routage intelligent des API LLM : choisir fournisseurs et modèles pour maîtriser les coûts.
- Router chaque requête vers le bon LLM : critères de routage applicatif et choix de conception.