Résumez cet article avec :
Les définitions d'outils MCP sont envoyées au modèle à chaque appel ; les agents paient donc pour des outils qu'ils n'utilisent jamais. Ce guide explique où vont ces jetons, quand les catalogues d'outils volumineux nuisent à la fiabilité, pourquoi le filtrage des outils peut briser la mise en cache des invites et comment mesurer le coût réel de chaque tâche accomplie.
Un agent IA n'a pas besoin d'appeler un outil pour payer pour celui-ci.
Chaque fois qu'un modèle reçoit une liste de définitions d'outils, les noms, descriptions et schémas de paramètres deviennent une partie de l'entrée qu'il doit traiter. Connectez quelques serveurs MCP, exposez quelques dizaines de fonctionnalités, et l'agent peut dépenser des milliers de jetons à lire ce qu'il pourrait faire avant de décider ce qu'il devrait faire. Il paie ensuite ce coût à nouveau lors du prochain appel au modèle, car les définitions d'outils accompagnent chaque requête.
Pour une seule petite intégration, la surcharge est à peine perceptible. Mais sur des requêtes répétées, avec plusieurs agents et des flux de travail longs en plusieurs étapes, cela devient une décision architecturale.
Une expérience récente illustre bien ce compromis. Fin octobre 2026, un auteur de la communauté AWS a reconstruit un serveur MCP de tri des coûts AWS en lecture seule à deux reprises. La première version comptait quinze outils et nécessitait sept appels d'outils pour répondre à une question. La version reconstruite ne comptait que quatre outils, a répondu à la même question en deux appels, et ses descriptions d'outils étaient 88 % plus courtes. Le plus surprenant : le compteur de contexte du client n'est passé que de 1,1 % à 0,8 %, car quinze petits outils restent négligeables face à une fenêtre de 200 000 jetons. Le gain réel provient du fait que l'agent a atteint la réponse en moins d'étapes. Les deux versions sont disponibles sur GitHub si vous souhaitez les comparer.
Cette distinction traverse tout cet article. Le protocole MCP n'est pas inefficace par nature. Il offre aux agents un moyen standard de découvrir et d'utiliser des capacités externes. La surcharge provient de la manière dont ces capacités sont conçues, exposées, sélectionnées et exécutées. La vraie question n'est donc pas de savoir comment donner le moins d'outils possible à un agent, mais comment lui fournir les bonnes capacités sans rendre chaque appel inutilement coûteux.
La taxe cachée sur les outils : où vont les jetons
Les outils MCP sont décrits par un nom, une description, un schéma d'entrée et quelques métadonnées. Ensemble, ces éléments indiquent au modèle quand et comment utiliser chaque outil. Lorsqu'un client MCP transmet ces définitions via l'interface d'appel d'outils du modèle, elles deviennent partie intégrante de l'entrée du modèle. Un outil de recherche Jira connecté peut ajouter des jetons à une requête qui n'a besoin que d'informations provenant de GitHub.
L'ampleur peut être surprenante. Dans l'article d'Anthropic sur l'utilisation avancée des outilscinq serveurs MCP exposant 58 outils ont consommé environ 55 000 jetons avant même que la conversation ne commence. Jira seul en a utilisé environ 17 000, et Anthropic a signalé que les définitions d'outils consommaient 134 000 jetons avant optimisation.
Ces chiffres proviennent de configurations spécifiques et ne représentent pas un coût fixe par serveur MCP. La taille du schéma, les ensembles d'outils activés et le comportement du client modifient le résultat. Ils donnent toutefois une idée de l'ordre de grandeur.
Les définitions ne sont pas le seul coût. Les résultats des outils sont également renvoyés au modèle en tant que contexte. Une recherche large renvoyant des centaines d'enregistrements, un appel OCR qui extrait un document entier ou une réponse API remplie de champs que l'agent ne lit jamais viendront gonfler la requête suivante. Ils continuent de gonfler chaque requête ultérieure tant qu'ils restent dans la conversation.
Il est utile de distinguer trois types de surcoûts :
- Surcoût lié aux définitions : les outils et schémas mis à la disposition du modèle à chaque appel.
- Surcoût lié à l'exécution : les appels, les résultats intermédiaires et les tentatives générés lors de l'exécution d'une tâche.
- Surcoût lié au raisonnement : le traitement supplémentaire dont le modèle a besoin pour interpréter les résultats, résoudre les ambiguïtés et décider de la marche à suivre.
Une fenêtre de contexte plus large ne supprime aucun de ces éléments. Elle offre plus d'espace au modèle, mais chaque jeton dans cet espace est toujours facturé et doit toujours être traité. La capacité et l'efficacité sont des propriétés différentes. Les limites elles-mêmes sont également des paramètres définis par le fournisseur qui peuvent changer, comme nous l'avons vu lorsque OpenAI a discrètement réduit la fenêtre de contexte de Codex de 27 %.
Quand la multiplication des outils devient un problème de fiabilité
Un catalogue d'outils surdimensionné ne coûte pas seulement des jetons. Il peut également dégrader la sélection des outils.
Lorsque plusieurs outils ont des noms similaires ou des descriptions qui se chevauchent, le modèle doit distinguer des fonctionnalités qui semblent interchangeables. Il peut choisir un outil plausible mais erroné, transmettre des paramètres inadaptés à l'opération ou appeler plusieurs outils alors qu'un seul aurait suffi. Anthropic note que les échecs les plus courants sont une mauvaise sélection d'outils et des paramètres incorrects, en particulier lorsque les outils ont des noms similaires, tels que notification-send-useretnotification-send-channel.
Les équipes de production signalent le même schéma. Dans sa rétrospective sur le mode Agent, Postman a décrit une forte augmentation des hallucinations d'outils une fois que l'ensemble d'outils dépassait environ 40 éléments : l'agent appelait des outils inexistants, transmettait des arguments incorrects ou choisissait des outils qui semblaient raisonnables mais qui étaient inappropriés dans le contexte. Des modèles plus grands ou plus récents ont réduit le problème sans toutefois l'éliminer.
Il n'existe cependant pas de seuil universel. Un ingénieur de Fullstory a testé la sélection d'outils à mesure que la boîte à outils s'étoffait pour atteindre une centaine d'éléments. Un modèle de pointe actuel est resté fiable bien au-delà de la règle empirique habituelle, tandis qu'un modèle plus ancien et moins coûteux est devenu erratique à mesure que le nombre d'outils augmentait. Sa conclusion est que le manque de clarté du contexte et des données importe souvent plus que le nombre d'outils. Cela rappelle également qu'un modèle qui « prend en charge » l'appel d'outils ne garantit pas qu'il gère votre catalogue correctement, une lacune que nous avons abordée dans ce que signifie réellement « prendre en charge » en production.
La recherche désigne la récupération comme une solution possible. Le document RAG-MCP récupère les descriptions d'outils les plus pertinentes avant de les présenter au modèle. Dans ses expériences, cela a permis de réduire le nombre de jetons de prompt de plus de 50 % et d'augmenter la précision de la sélection d'outils de 13,62 % à 43,13 %.
La leçon à retenir est que la disponibilité des outils, leur clarté et les capacités du modèle doivent être prises en compte conjointement. Supprimer des fonctionnalités utiles peut rendre un agent moins performant. Exposer tout le contenu sans stratégie de découverte peut le rendre moins efficace et moins fiable.
Cinq façons de concevoir un écosystème d'outils MCP plus léger
Aucune optimisation unique ne convient à tous les serveurs. L'approche appropriée dépend du nombre de fonctionnalités que vous exposez, de la complexité de leurs schémas, de leur fréquence d'utilisation et du niveau de contrôle dont l'agent a besoin. Ces cinq techniques constituent un point de départ pratique.
1. Concevez les outils en fonction des résultats, et non des points de terminaison.
Un modèle courant consiste à encapsuler chaque opération backend sous forme d'outil dédié. C'est facile à générer, mais cela oblige le modèle à coordonner plusieurs opérations de bas niveau pour ce qui constitue en réalité un seul flux de travail. Le guide d'Anthropic sur la création d'outils efficaces pour les agents donne un exemple concret : au lieu d'avoir des outils séparés comme get_customer_by_id,list_transactionsetlist_notes , créez un seul outil get_customer_context outil qui compile les informations récentes et pertinentes d'un client en un seul appel.
L'objectif n'est pas de créer un outil universel géant. Chaque outil doit avoir une responsabilité claire et renvoyer ce dont l'agent a besoin pour l'accomplir.
2. Rédigez des schémas que le modèle peut comprendre.
Les noms des outils et les paramètres doivent utiliser le langage de la tâche, et non des termes de base de données internes. Utilisez des noms de paramètres explicites, des valeurs par défaut sensées, des valeurs contraintes (énumérations) lorsque cela est possible, ainsi que des descriptions claires des entrées et sorties attendues.
AWS a testé ces compromis dans Conception d'outils MCP : approches pratiques et compromis, en créant six versions du même outil de recherche pour un seul backend. Des descriptions plus riches ont amélioré la précision, mais ont alourdi les définitions. La restructuration des schémas, les valeurs par défaut et le chargement différé ont chacun permis d'atteindre un équilibre différent, et aucune version ne l'emporte sur tous les plans. Un schéma plus court n'est pas automatiquement meilleur s'il laisse le modèle dans l'incertitude.
3. Gardez les résultats des outils concis.
Un outil doit renvoyer ce qui est utile, et non tout ce que son API sous-jacente fournit par défaut. La pagination, le filtrage, la sélection de champs et la troncature permettent d'éviter que des données non pertinentes n'encombrent la requête suivante. Lorsque vous tronquez, incluez un court message indiquant au modèle ce qui a été omis.
Les gains peuvent être importants. Dans l'exemple d'Anthropic, une réponse détaillée de l'outil a utilisé 206 jetons, tandis que la version concise en a utilisé 72, soit environ un tiers. La propre documentation du serveur MCP d'Eden AI recommande de tronquer les sorties volumineuses d'OCR et de scraping à environ 20 000 caractères avant de les ajouter à la conversation. Pour le contenu web, la conversion des pages en Markdown propre avant qu'elles n'atteignent le modèle est un autre levier, comme le montre notre pipeline open-source avec Crawl4AI et DeerFlow. Pour les textes longs en général, les méthodes de compression de prompt peuvent réduire ce qui reste.
4. Chargez les outils lorsqu'ils sont nécessaires.
Au lieu de charger chaque définition au préalable, un agent peut commencer avec une petite interface de découverte et récupérer les outils pertinents lorsqu'une tâche les exige.
L' outil de recherche d'outils d'Anthropic est le point de données le plus probant. Une configuration traditionnelle consommait environ 77 000 jetons avant même de commencer le travail, contre environ 8 700 avec l'outil de recherche d'outils (Tool Search Tool), soit une réduction de 85 %. Parallèlement, la précision s'est améliorée : lors des évaluations MCP d'Anthropic, Opus 4 est passé de 49 % à 74 % et Opus 4.5 de 79,5 % à 88,1 %. Il s'agit de résultats internes à Anthropic, et non de garanties. OpenAI propose un mécanisme similaire via la recherche d'outils dans l'API Responses, où les outils marqués defer_loading ne sont chargés que lorsque le modèle les recherche.
Vous pouvez également restreindre le catalogue côté serveur. Le serveur MCP GitHub vous permet d'activer uniquement les ensembles d'outils dont vous avez besoin via un --toolsets indicateur pour réduire la taille du contexte, et propose un mode de découverte dynamique en version bêta qui liste et active les ensembles d'outils en réponse à la requête de l'utilisateur.
Parfois, l'étape la plus économique consiste à décider si un outil est réellement nécessaire. Un modèle de décision à très faible coût peut répondre à cette question avant le lancement d'une boucle d'agent coûteuse.
5. Utilisez l'exécution programmatique pour les flux de travail en plusieurs étapes.
Lorsqu'un agent enchaîne plusieurs opérations, renvoyer chaque résultat intermédiaire via le modèle consomme inutilement du contexte. Une alternative consiste à laisser l'agent écrire du code qui appelle les outils et ne renvoie que le résultat final.
Dans l'exécution de code avec MCP, Anthropic montre un agent qui ne charge que les définitions nécessaires via du code, ce qui réduit l'utilisation de jetons de 150 000 à 2 000, soit une économie de 98,7 %. Sa fonctionnalité d'appel d'outils programmatique a réduit l'utilisation moyenne de 43 588 à 27 297 jetons, une réduction de 37 % sur les tâches de recherche complexes.
Cloudflare a appliqué une idée similaire avec Code Mode, qui présente les outils MCP sous forme d'API TypeScript sur laquelle le modèle écrit du code. Appliqué à l'ensemble de son API, le mode Code a réduit l'empreinte en jetons de plus de 2 500 points de terminaison, passant de plus de 1,17 million de jetons à environ 1 000 (InfoQ).
Cette approche impose ses propres exigences : bac à sable (sandboxing), autorisations et contrôle de l'exécution. Elle n'est pas nécessaire pour tous les agents, mais elle s'avère payante pour les flux de travail comportant de nombreuses opérations interdépendantes.
Le paradoxe de la mise en cache des invites
Le filtrage des outils comporte un piège important : envoyer moins de définitions par requête peut rendre la mise en cache des invites moins efficace.
La mise en cache des invites réutilise l'état traité d'un préfixe d'invite inchangé. Si un agent continue d'envoyer les mêmes instructions système, documents de référence et définitions d'outils, le fournisseur peut servir ce préfixe à partir du cache, ce qui est moins coûteux et plus rapide qu'un nouveau traitement. La condition clé est la stabilité, et les définitions d'outils se situent tout au début du préfixe. Selon OpenAI, les outils, les schémas et leur ordre font partie du préfixe mis en cache et sont injectés avant les instructions du développeur ; par conséquent, toute modification invalide le cache.
Imaginez deux agents. Le premier envoie les mêmes instructions et le même catalogue d'outils à chaque appel, de sorte que son préfixe reste identique et peut être réutilisé. Le second supprime les outils non pertinents avant chaque appel. Ses invites sont plus petites, mais son préfixe change constamment, rendant les entrées de cache précédentes obsolètes.
Le résultat est contre-intuitif : moins de jetons d'entrée par requête, mais davantage de traitements non mis en cache entre les requêtes.
Cela ne signifie pas que le filtrage des outils est une mauvaise pratique. Cela signifie simplement que le filtrage et la mise en cache doivent être conçus conjointement.
Les deux principaux fournisseurs proposent désormais des moyens de restreindre les outils sans réécrire le préfixe. Le guide de mise en cache des invites d'OpenAI et son Mise à jour de la mise en cache pour GPT-6 conseil direct : assurez la stabilité des définitions d'outils, des schémas et de leur ordre, utilisez allowed_tools pour ne rendre appelables que les outils pertinents, ou réglez tool_choice sur « none » lorsqu'aucun outil n'est nécessaire, plutôt que de supprimer les définitions.
Les fonctionnalités de recherche d'outils de la section précédente ont été conçues dans cette optique. Avec Anthropic, les outils différés sont exclus de l'invite initiale et ne sont ajoutés qu'après que Claude les a recherchés ; ainsi, l'invite système et les définitions principales des outils restent mises en cache. La version d'OpenAI préserve le cache en injectant les outils nouvellement découverts à la fin de la fenêtre de contexte.
Une précision, car la confusion est fréquente : la recherche d'outils et le chargement différé ne sont pas des fonctionnalités du protocole MCP lui-même. La spécification MCP définit la manière dont les serveurs décrivent et exposent les outils. La décision de savoir quelles définitions parviennent au modèle, et à quel moment, se prend au niveau de l'API du fournisseur ou du client.
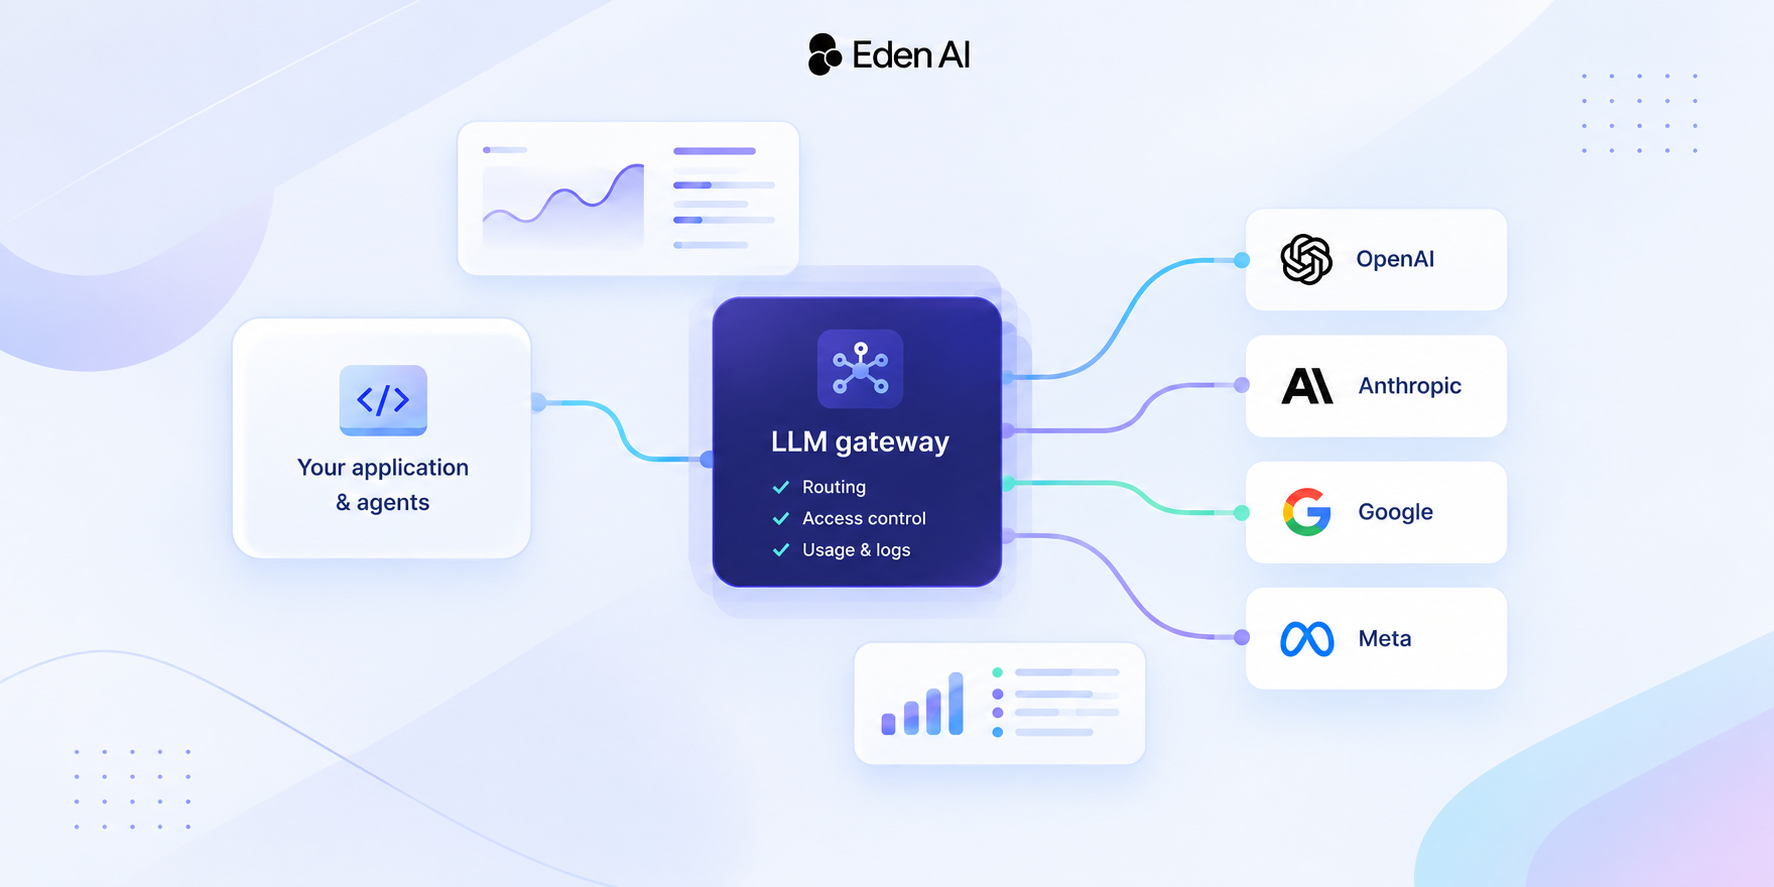
La passerelle ajoute une condition supplémentaire. Un cache d'invite est lié au point de terminaison du fournisseur qui l'a créé. Il n'est pas partagé entre les fournisseurs, les régions, les comptes ou les modèles non apparentés. Si une passerelle répartit une conversation entre plusieurs fournisseurs utilisant le même modèle, chaque saut repart à zéro. Pour éviter cela, Eden AI maintient les conversations routées chez le fournisseur qui détient leur cache: elle utilise un routage persistant pour les modèles bénéficiant de lectures de cache à prix réduit, basé sur un identifiant de conversation stable tel que session_id. La même documentation recommande de maintenir les outils, schémas, exemples et documents identiques octet par octet entre les requêtes.
La règle pratique est simple :
- Gardez le contenu réutilisable stable et placez le contenu dynamique à la fin.
- Restreignez les outils via les mécanismes pris en charge par le fournisseur plutôt que de reconstruire le catalogue à chaque appel.
- Maintenez une conversation chez le fournisseur qui détient son cache.
Eden AI MCP : une connexion unique vers un vaste écosystème de modèles experts
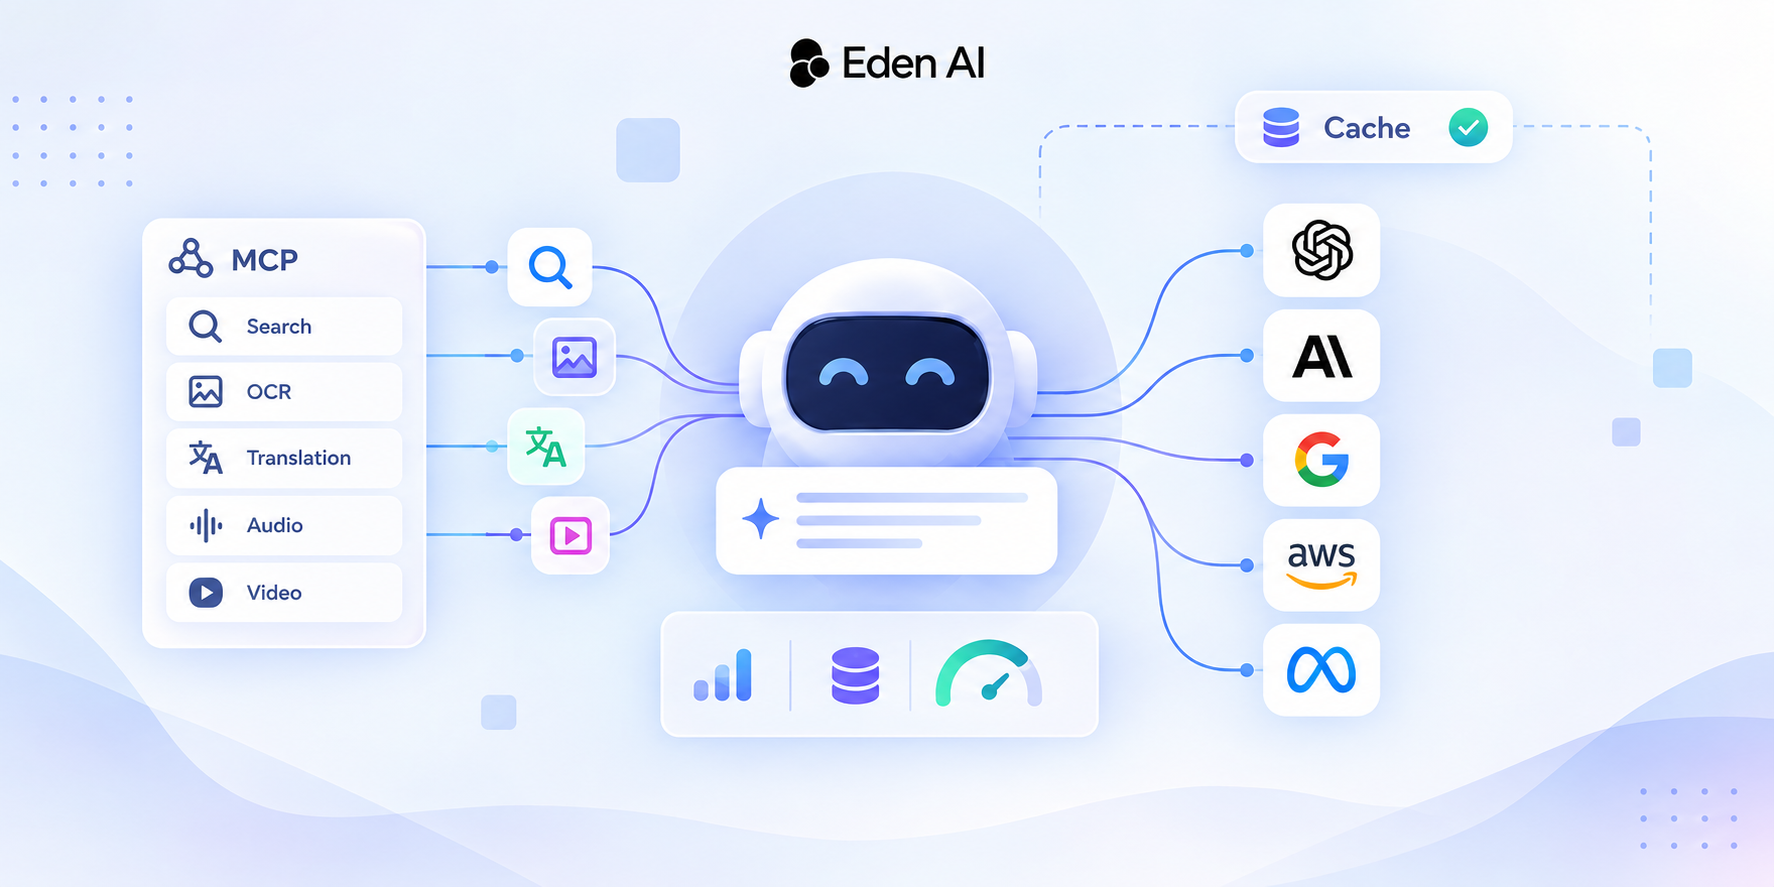
Cette optimisation ne doit pas occulter l'intérêt premier du protocole MCP. Une intégration MCP bien conçue rend les fonctionnalités externes accessibles via une interface cohérente, évitant ainsi à l'agent de devoir connaître l'API de chaque fournisseur.
Eden AI expose ses modèles experts via un serveur MCP hébergé. Plutôt que de déployer et de maintenir une intégration distincte pour chaque fournisseur, les développeurs bénéficient d'une interface unique pour des fonctionnalités telles que l'OCR, l'analyse d'images, le traitement de texte, la recherche web, la traduction, ainsi que l'audio et la vidéo.
Le point de terminaison est https://mcp.edenai.run/mcp, avec un transport HTTP Streamable et une authentification par jeton Bearer. Les clients compatibles MCP peuvent s'y connecter directement ; la documentation inclut des configurations prêtes à l'emploi pour Claude Code, Codex CLI, Cline, Continue et d'autres. Chaque appel d'outil correspond à un appel de modèle expert Eden AI standard : il est facturé sur votre clé et visible dans votre suivi.
La conception du catalogue respecte les principes énoncés ci-dessus. Eden AI expose un outil par fonctionnalité de modèle expert, plutôt qu'un outil par combinaison de fournisseur et de modèle. Un paramètre model partagé permet de sélectionner le fournisseur (ou la paire fournisseur/modèle), de sorte que l'ajout de nouveaux fournisseurs ne multiplie pas le nombre de définitions d'outils. Trois outils utilitaires complètent le catalogue :
upload_filetélécharge du contenu local et renvoie un identifiant de fichier pour tout paramètre de type fichier.check_jobrécupère le statut et le résultat des opérations de longue durée.list_modelsliste les fournisseurs, modèles et tarifs disponibles, éventuellement pour un outil spécifique.
Le serveur est également utile en dehors des clients natifs MCP. La documentation montre comment récupérer le catalogue et transmettre les schémas à n'importe quel modèle capable d'appeler des fonctions via votre propre boucle d'agent sur la passerelle Eden AI, en utilisant le SDK OpenAI ou Anthropic. Tout modèle marqué avec supports_function_calling dans le catalogue de modèles peut utiliser les outils.
Cela permet une composition multimodale. Un modèle textuel peut appeler ocr, recevoir le texte extrait et continuer à raisonner avec. Il n'a pas besoin d'effectuer l'OCR nativement ; il doit simplement savoir quand déléguer.
La couche d'orchestration décide toujours de ce qui parvient au modèle, et la documentation d'Eden AI applique les conseils de cet article. Son exemple de boucle d'agent ne transmet que les outils nécessaires à une tâche, et ses bonnes pratiques indiquent que le catalogue complet représente un volume de schémas trop important pour une seule invite ; envoyer uniquement les outils requis améliore à la fois la précision et les coûts. Le serveur hébergé fournit les capacités. Le développeur de l'agent contrôle la stratégie de sélection et le contexte renvoyé au modèle.
Mesurer le coût réel d'un agent
L'optimisation doit commencer par la mesure, et non par des suppositions.
Avant de modifier une architecture MCP, établissez une base de référence :
- Comptez les jetons d'entrée consommés par l'invite système et les définitions d'outils.
- Enregistrez le nombre d'appels d'outils nécessaires pour chaque tâche.
- Mesurez la taille des résultats obtenus.
Exécutez ensuite la même charge de travail après avoir modifié votre stratégie d'outils.
Eden AI propose plusieurs briques technologiques pour cela :
- Comptez avant d'envoyer. L' endpoint Count Anthropic Tokens accepte des messages, un prompt système, des outils et un choix d'outils, puis renvoie le nombre de jetons d'entrée que la requête consommerait sans exécuter le modèle. Effectuez un comptage avec votre liste complète d'outils, puis un autre sans, et la différence correspond à votre coût en jetons lié aux outils par appel.
- Vérifiez ce qui a réellement été mis en cache. La mise en cache des prompts est normalisée sous la forme de
cached_tokensetcache_write_tokenslà où les fournisseurs le signalent, et le champcostinclut déjà la tarification du cache. La réussite d'une réponse ne prouve pas que le préfixe a été mis en cache, vérifiez donc les champs correspondants. Les métadonnées de la requête indiquent quel fournisseur a traité chaque appel, ce qui est utile pour confirmer que le routage persistant a bien maintenu une conversation sur le fournisseur dont le cache est actif. - Attribuez les dépenses par agent. Tags identifiez les appels via un
X-EdenAI-Tagsen-tête, par exempleagent=support-bot. Vous pouvez ensuite ventiler l'utilisation et les coûts par client, projet ou environnement dans le tableau de bord sans avoir à créer une clé API pour chacun d'eux, et les tags ne sont jamais transmis au fournisseur de modèle. Comparer le coût par tâche de deux agents est le meilleur moyen de mettre en évidence un catalogue d'outils surdimensionné. - Dirigez les étapes vers le modèle approprié. Politiques de routage enregistrez une chaîne de modèles et des préférences de fournisseur sous un nom unique. Comme l'indique notre guide des coûts des jetons , les agents passent la majeure partie de leur temps à lire, rechercher et vérifier ; ces tâches peuvent donc être confiées à des modèles légers, tandis que les modèles de pointe se chargent des étapes complexes. Testez toutefois avec soin les étapes utilisant de nombreux outils : comme l'a montré l'expérience Fullstory, les modèles moins coûteux peuvent être les premiers à peiner face à des catalogues volumineux. Nos articles sur le routage basé sur le rapport prix-performance et sur comment la vérification a permis d'utiliser des modèles moins coûteux traitent ce compromis plus en détail.
Si vous hésitez encore entre une mesure via votre propre proxy ou via des traces, consultez Proxy LLM vs OpenTelemetry.
La métrique qu'il vaut la peine d'optimiser n'est pas le jeton d'entrée le moins cher ou le prompt le plus court. C'est le coût d'une tâche terminée avec succès, incluant les appels de modèles, l'exécution des outils, les tentatives de répétition et le contexte nécessaire pour obtenir un résultat fiable.
Un modèle moins coûteux qui choisit systématiquement le mauvais outil peut revenir plus cher qu'un modèle plus performant qui termine le flux de travail en moins d'étapes. De la même manière, un catalogue d'outils plus restreint qui déclenche des appels de découverte supplémentaires ou qui brise le cache n'est pas nécessairement plus économique qu'un catalogue stable et compatible avec la mise en cache. La seule façon fiable de le savoir est de mesurer l'intégralité du flux de travail.
De meilleurs outils, de meilleurs agents
Le protocole MCP facilite la connexion des agents aux systèmes externes, mais l'accès seul ne garantit pas leur efficacité. La conception du catalogue d'outils, la clarté de ses schémas, la taille de ses résultats et la manière dont les outils sont découverts déterminent la charge de travail du modèle à chaque appel.
Les systèmes les plus efficaces ne sont pas ceux qui possèdent le moins d'outils. Ils exposent les fonctionnalités pertinentes pour la tâche, les décrivent suffisamment bien pour que le modèle les utilise correctement et évitent de retraiter des informations inchangées. La mise en cache des prompts ajoute une contrainte supplémentaire : l'optimisation doit tenir compte de ce qui reste stable entre les requêtes, et pas seulement de ce qui peut être supprimé d'une requête.
Pour les équipes qui développent des agents en production, la conception des outils, la sélection des modèles, la mise en cache et la mesure des coûts font partie d'une même architecture. Avec une couche de fonctionnalités unifiée telle que le serveur MCP d'Eden AI et une stratégie d'orchestration réfléchie, les agents peuvent accéder à un vaste écosystème de modèles experts sans transformer chaque interaction en un prompt surdimensionné.